3.2 牛顿-拉夫逊法:潮流计算的主力算法
3.2 牛顿-拉夫逊法:潮流计算的主力算法
本节摘要:牛顿-拉夫逊法用"线性化—解修正方程—更新迭代"三板斧把非线性潮流方程组逐步逼近到收敛。它收敛快(二次渐近)、精度可控,是商用潮流程序的主力算法。本节推导修正方程与雅可比矩阵的结构,用三节点系统手算两轮迭代展示全过程,并交代初值选取与收敛判据这两个工程要点。
从一个未知量的迭代说起
单变量方程 f(x) = 0 的牛顿迭代你或许见过:从初值 x⁰ 出发,在曲线该点作切线,切线与横轴的交点作为新估计:
x(k+1) = x(k) − f(x(k)) / f′(x(k))
几何直觉是"沿着切线下滑"。多变量版本完全同构:把 f 换成方程组向量 F(x),把 f′ 换成偏导数矩阵——雅可比矩阵 J:
J(x(k)) · Δx(k) = −F(x(k)) x(k+1) = x(k) + Δx(k)
潮流问题里,x 是节点电压幅值与相角组成的向量(PQ 节点的 U 与全部 θ,共 n−1+m... 按 3.1 节账本:n−1 个 θ 加 n−m 个 U),F 是功率失配向量——给定当前电压估计,算出的注入功率与设定注入功率的差。失配向量归零之日,就是潮流收敛之时。
雅可比矩阵:潮流的"地形图"
对 PQ 与 PV 节点联合列出失配方程,雅可比自然分成四块,习惯记为:
[ ΔP ] [ H N ] [ Δθ ] [ ] = [ ] [ ] [ ΔQ ] [ J L ] [ ΔU ]
H 块反映有功失配对相角的敏感度,L 块反映无功失配对电压的敏感度,N、J 是交叉项。四个分块都有解析表达式(对 3.1 节功率方程求偏导),程序里每轮迭代重新计算。这个四分块不只是记号:下一节的快速解耦法直接利用"H 强、N 弱、J 弱、L 强"的物理事实做简化。雅可比还有一个实用身份——潮流灵敏度:它的逆(或因子表)告诉你"节点 7 注入 1 MW 会在哪些线路引起多大功率转移",第 6 章安全分析的灵敏度方法、市场里的阻塞价格分解,数学根源都在这里。
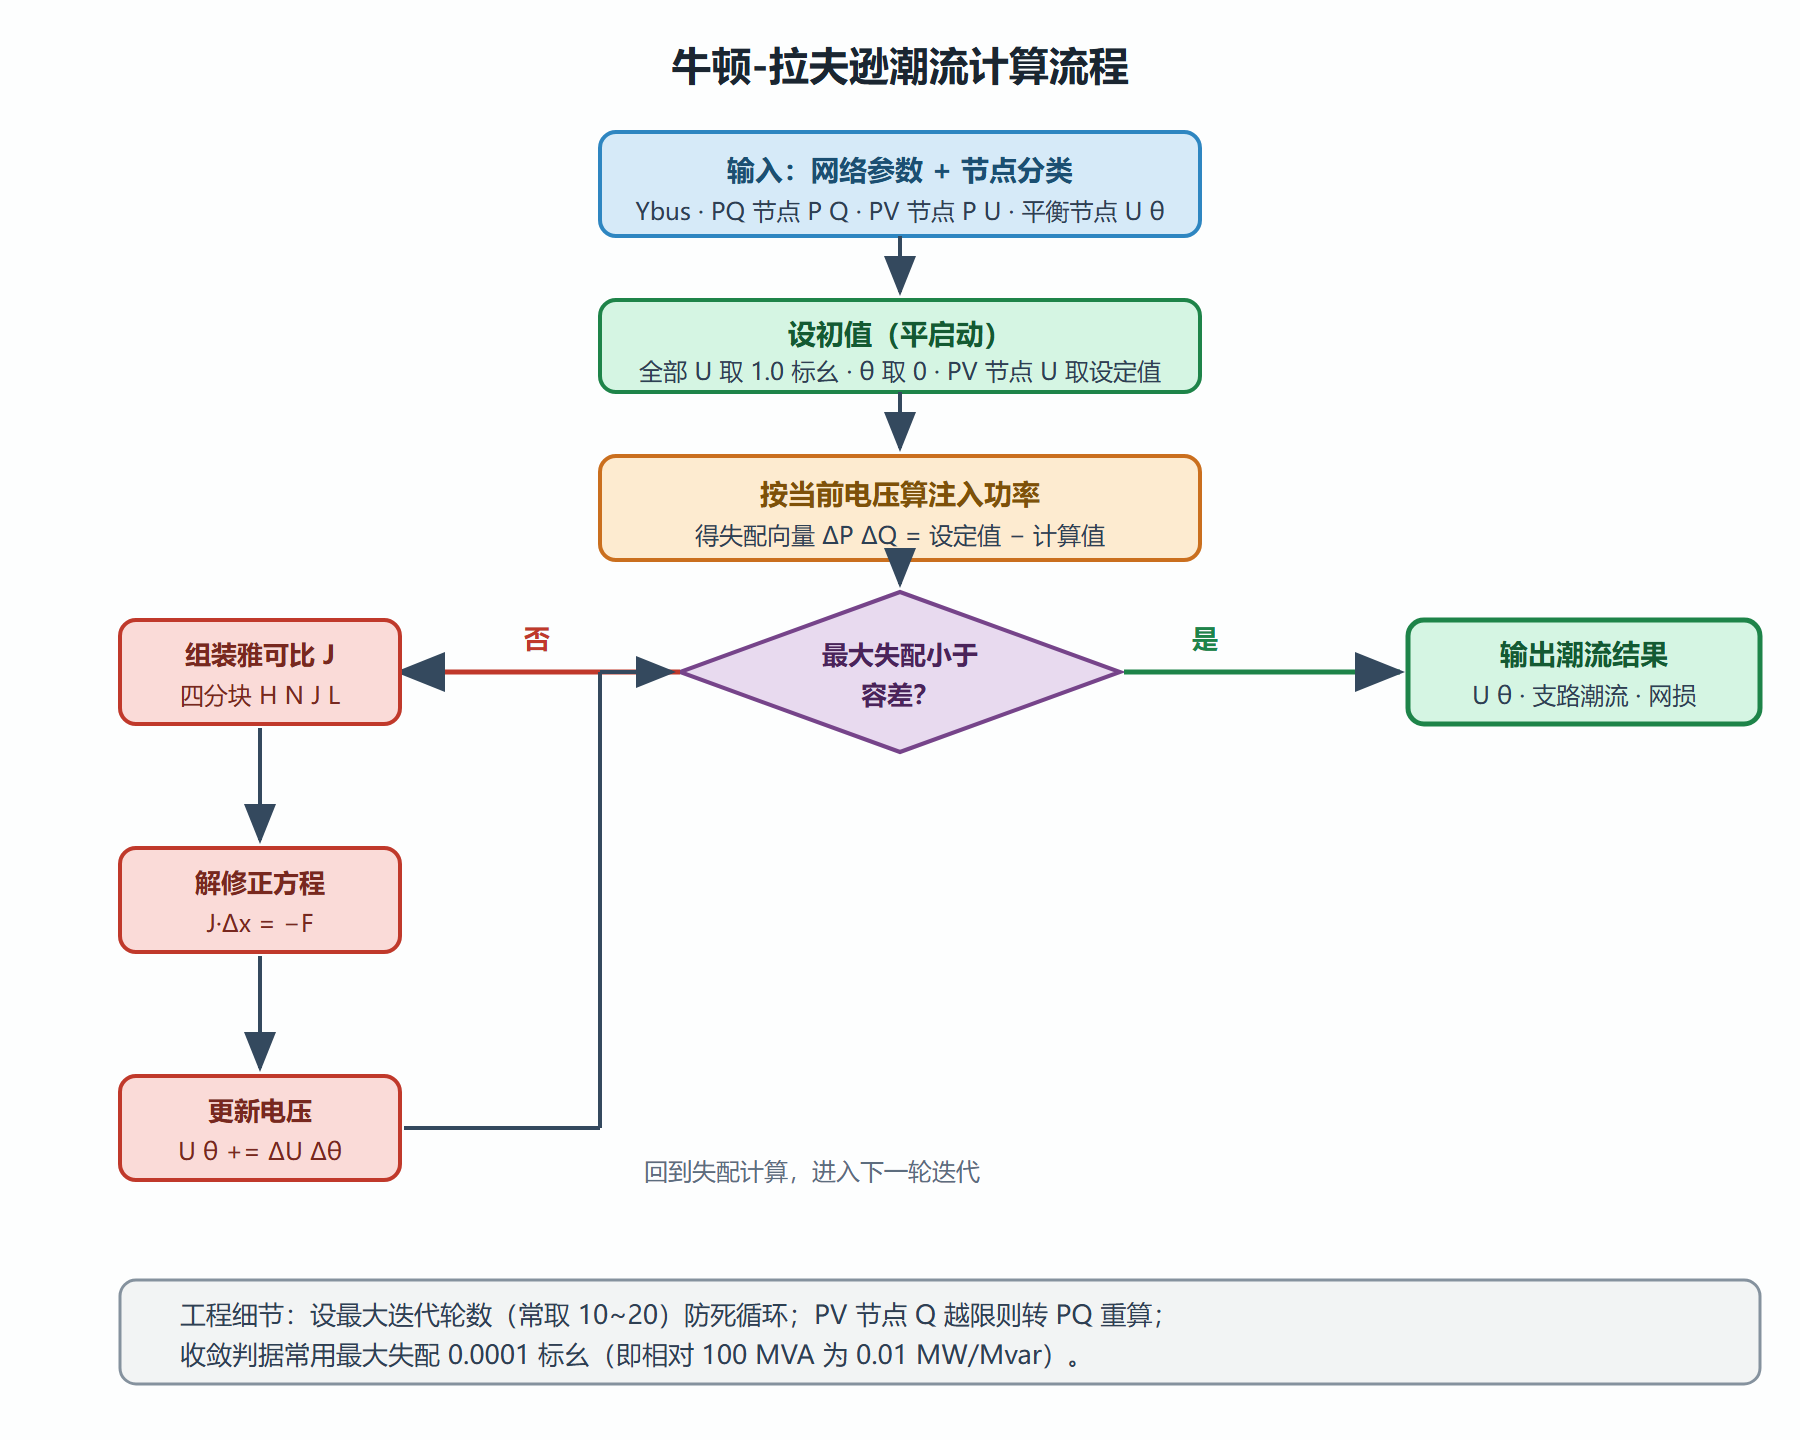
图:牛顿-拉夫逊潮流计算的完整流程
手算两轮:三节点系统走一遍
用 2.3 节的三节点网络,简化起见取纯电抗模型:节点 1 平衡(U₁ = 1.05∠0°),节点 2 PV(P₂ = 0.5,U₂ = 1.02),节点 3 PQ(P₃ = −0.9,Q₃ = −0.3,注入为负表示负荷)。支路电抗:x12 = 0.24,x23 = 0.105(数值来自 2.3 节数据合并)。以节点 2、3 的 θ 与节点 3 的 U 为未知量,平启动 θ₂⁰ = θ₃⁰ = 0、U₃⁰ = 1.0。
第一轮:先算失配。由功率方程(只列主导项做演示量级判断),θ 差全为零时 sin 项消失,P 失配主要来自电导项与对角项;对本例失配 ΔP₂ ≈ −0.487、ΔP₃ ≈ −0.881、ΔQ₃ ≈ −0.324。组装二阶雅可比的对角元素 H22 ≈ U₂²/x12 + U₂U₃/x23 等,这里直接给数值:H22 ≈ 12.6、H33 ≈ 10.1、H23 = H32 ≈ −9.6、L33 ≈ 9.2。解修正方程(手算消元)得 Δθ₂ ≈ 0.041、Δθ₃ ≈ 0.127、ΔU₃ ≈ 0.035。
第二轮:更新后电压 θ₂ = 0.041、θ₃ = 0.127、U₃ = 1.035,重算失配,数值已缩到千位小数量级;再一轮修正后最大失配降到 0.0001 以下,收敛。三次迭代达到工程精度是 N-R 法的常态——二次收敛意味着失配每轮平方级缩小,初值不太离谱时极少超过五轮。完整数值过程的程序化版本如下,直接可跑:
import numpy as np # 三节点示例:节点1平衡,节点2 PV,节点3 PQ;支路电抗 x12=0.24, x23=0.105 x12, x23 = 0.24, 0.105 U1, th1 = 1.05, 0.0 U2, P2, U2set = 1.02, 0.5, 1.02 P3, Q3 = -0.9, -0.3 def mismatch(th2, th3, U3): # 以近似式 Ui·Uk/x · sin(θi-θk) 计算注入(略去电导) P2c = U2*U1/x12*np.sin(th2-th1) + U2*U3/x23*np.sin(th2-th3) P3c = U3*U2/x23*np.sin(th3-th2) + U3*U1/x23*0 # 节点3不与1直连则为0 Q3c = (U3*U2/x23*np.cos(th3-th2) + U3*U1*0 - U3*U3/x23) return np.array([P2-P2c, P3-P3c, Q3-Q3c]) x = np.array([0.0, 0.0, 1.0]) # [θ2, θ3, U3] for k in range(10): F = mismatch(*x) if np.max(np.abs(F)) < 1e-4: print(f"第{k}轮收敛,最大失配 {np.max(np.abs(F)):.6f}") break # 数值雅可比 J = np.zeros((3,3)) for j in range(3): dx = np.zeros(3); dx[j] = 1e-6 J[:,j] = (mismatch(*(x+dx)) - F)/1e-6 x = x - np.linalg.solve(J, F) print(f"第{k+1}轮: θ2={x[0]:.4f} θ3={x[1]:.4f} U3={x[2]:.4f}")
跑通后你会看到失配向量逐轮坍缩的过程,这就是"二次收敛"的直观形态。把 Q3 改成 −0.8 重跑,迭代轮数明显增加甚至不收敛——重负荷把解推到了雅可比接近奇异的区域,这正是电压稳定极限的数值前兆,第 5 章会正面处理它。
工程要点:初值与收敛判据
初值默认"平启动":全部电压取 1.0 标幺、相角取 0(PV 节点电压取设定值)。平启动对绝大多数系统有效;重负荷或病态系统可先用直流潮流(3.3 节)算一组相角作为"热启动"初值。收敛判据看失配向量而非电压增量——失配的物理量纲是 MW/Mvar,工程容差常取 0.0001 标幺。迭代上限必须设置,防止病态数据造成的死循环;加上每轮检查 PV 节点无功越限并切换模式,才是一套能上生产的潮流内核。
N-R 法的代价也要说清:每轮要重新组装并分解雅可比(内存与计算量的开销主体)。节点数上万的系统里,人们用因子表复用、稀疏技术、PQ 解耦(下一节)来摊薄这个成本。算法选择从来不是"谁更高级",而是"谁的总开销与鲁棒性更适合问题规模"。
本节要点回顾
- 三板斧:线性化、解修正方程、更新——牛顿迭代在方程组上的自然推广。
- 雅可比四分块 HN JL 是潮流的灵敏度地图,其逆是安全分析与市场定价的数学工具。
- 二次收敛:平启动下通常三到五轮达标;失配陡然增大或轮数激增,先怀疑病态而非算法。
- 两道保险:迭代上限防死循环,PV 转 PQ 处理无功越限。
N-R 已经够快,但物理还藏着加速空间:高压电网天然解耦的结构,是下一节的主角。