3.3 EXPLAIN 三连与预编译
3.3 EXPLAIN 三连与预编译语句对照
本节摘要:EXPLAIN 是观察执行层的窗口,预编译语句是复用编译产物的抓手。本节把三个引擎在同一条查询上的 EXPLAIN 输出并排摆放,给出三套读法;再对照预编译语句的生命周期——SQLite 的 bind、step、reset 循环,MySQL 的 PREPARE 与二进制协议,PostgreSQL 的扩展查询协议——并交代 schema 变更后 SQLite 自动重编译的行为。
同一条查询的三份说明书
查询目标:找出设备 sensor-07 最近的事件。三个引擎各自的"说明书"形态如下:
-- SQLite:字节码清单(上一节已学读法) EXPLAIN SELECT * FROM events WHERE device = 'sensor-07' AND ts > 1725600000; -- 另有 EXPLAIN QUERY PLAN 只显示访问路径,第 5 章主力工具 -- MySQL:表格计划 EXPLAIN SELECT * FROM events WHERE device = 'sensor-07' AND ts > 1725600000; +----+-------------+--------+------+---------------+----------+---------+-------+------+ | id | select_type | table | type | key | ref | rows | Extra | +----+-------------+--------+------+---------------+----------+---------+-------+ | 1 | SIMPLE | events | ref | idx_dev_ts | const | 132 | NULL | +----+-------------+--------+------+---------------+----------+---------+-------+ -- PostgreSQL:计划树 EXPLAIN SELECT * FROM events WHERE device = 'sensor-07' AND ts > 1725600000; QUERY PLAN ------------------------------------------------------------- Index Scan using idx_dev_ts on events Index Cond: ((device = 'sensor-07'::text) AND (ts > 1725600000)) (2 rows)
三套读法各有门道。SQLite 读两样东西:EXPLAIN QUERY PLAN 的路径行(SCAN 是全扫,SEARCH 是查找,USING INDEX 指出用哪棵索引树);需要更细时再看 EXPLAIN 的字节码。MySQL 读五个关键列:type(const、ref、range、index、ALL 依次变差)、key(实际用上的索引)、rows(估算扫描行数)、Extra(Using index 表示覆盖索引、Using filesort 表示额外排序)、以及多表时的连接顺序(id 越大越先执行)。PostgreSQL 读计划树的形状与代价:每节点括号里的 cost 起止值是估计代价,rows 是估计行数,加 ANALYZE 关键字则真跑一遍并显示 actual 时间——三库里它的树形输出把"计划、估计、实测"组装得最完整,页级命中信息还能用 BUFFERS 选项补上。
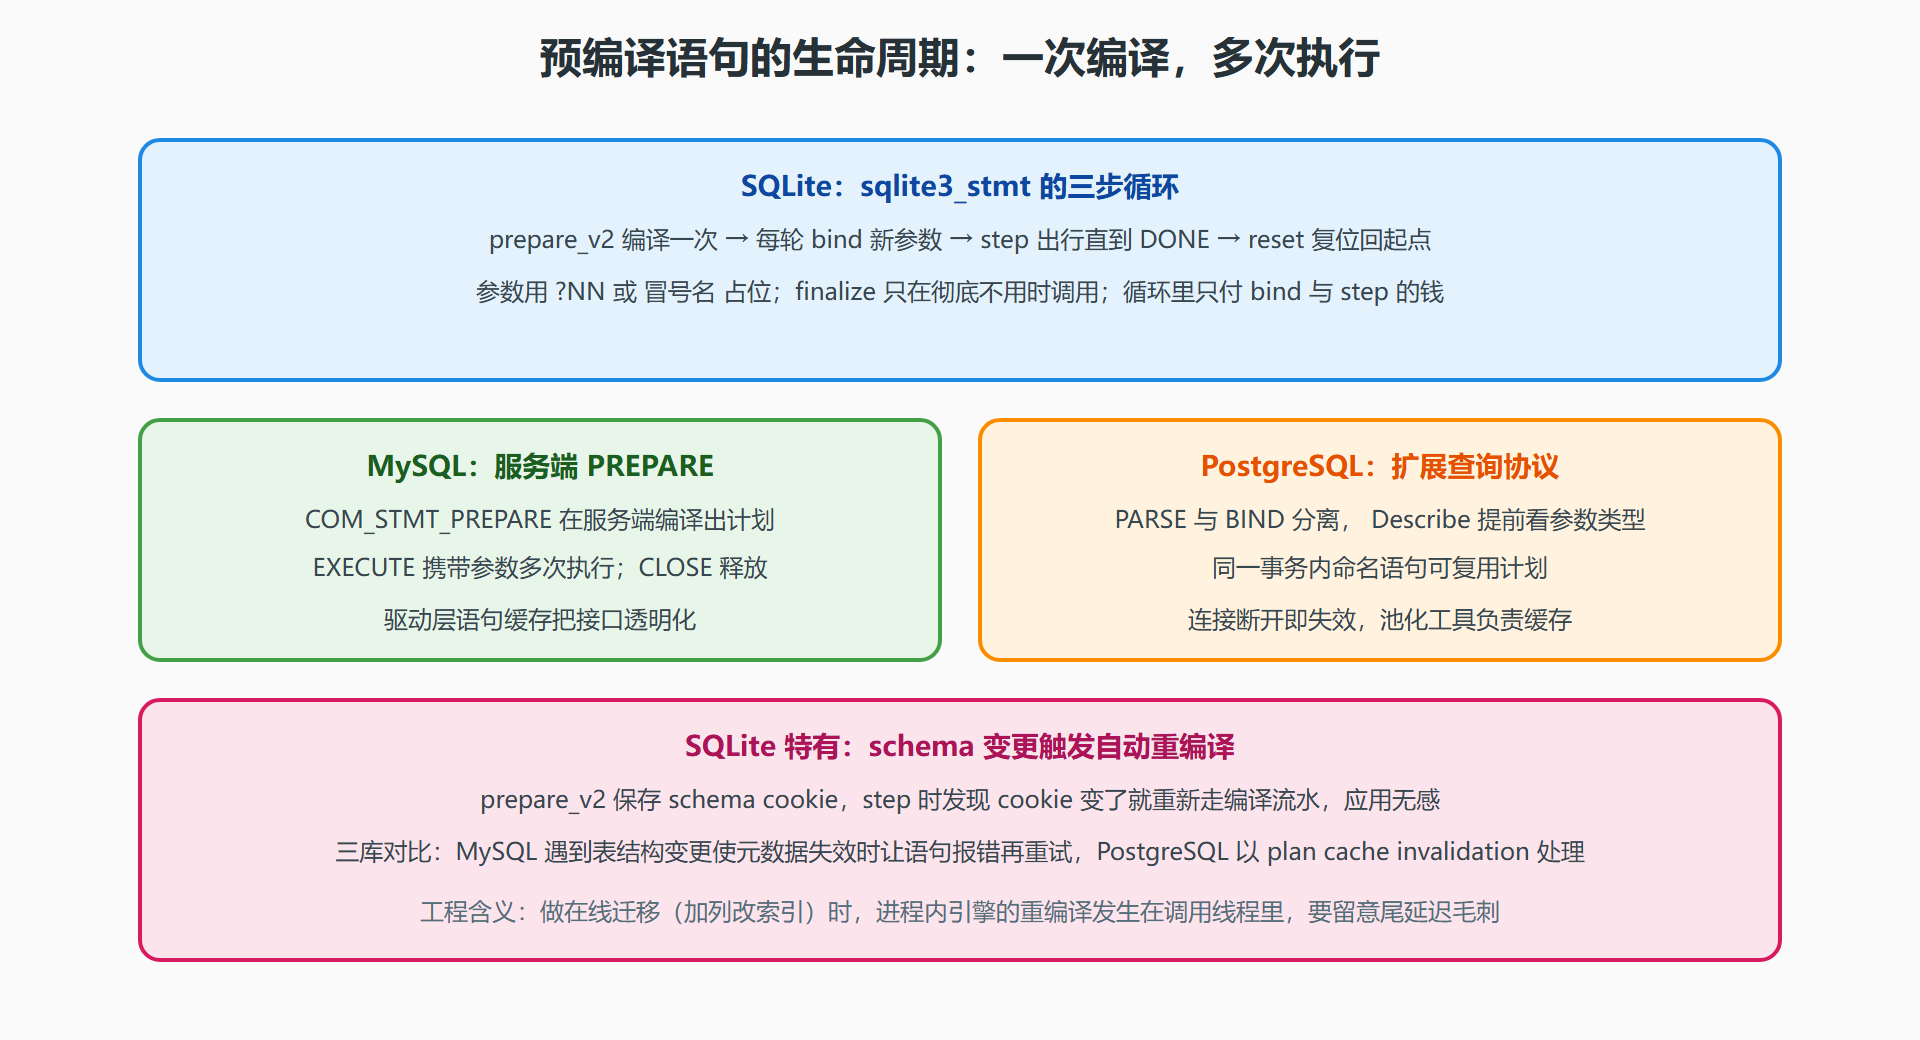
图:预编译语句生命周期对照
预编译:从机制到习惯
SQLite 预编译的标准循环如下,注意 reset 与 clear_bindings 的分工:
sqlite3_stmt *stmt = NULL; sqlite3_prepare_v2(db, "INSERT INTO events(device, value, ts) VALUES(?, ?, ?)", -1, &stmt, NULL); for (int i = 0; i < 100000; i++) { sqlite3_bind_text(stmt, 1, "sensor-07", -1, SQLITE_STATIC); sqlite3_bind_double(stmt, 2, 21.5); sqlite3_bind_int64(stmt, 3, ts_base + i); sqlite3_step(stmt); /* INSERT 只需 step 一次 */ sqlite3_reset(stmt); /* 复位以便下一轮复用,不清参数槽 */ } sqlite3_finalize(stmt);
三件事值得强调。其一,reset 只把语句拉回执行起点,绑定值还在;批量写入同参数形状时连 bind 都能省几个。其二,占位符本身杜绝了 SQL 注入——参数永远不进入解析器的词元流,单引号再刁钻也只是个普通字符串值。其三,prepare 与 step 分离让"编译一次执行十万次"的收益成为三个数量级的差距,7.3 节的实测会给出数字。MySQL 与 PostgreSQL 的对应机制在概念上完全同构(服务端预编译、扩展查询协议),差异主要在生命周期归属:前两者的语句缓存由连接池或驱动管理,SQLite 的语句对象就住在你自己的进程里,谁持有谁负责。
💡 关键直觉:预编译在三个引擎里的收益方向不同——服务端省的是"解析加计划生成加两次往返",嵌入式省的是"纯解析加代码生成"。同为数量级收益,但前者还包括网络,这就是为什么连接池里的语句缓存在服务端世界是命根子,而在 SQLite 世界可有可无。
EXPLAIN 的两个易踩坑
第一,EXPLAIN 显示的是"当时的计划"。ANALYZE 之前统计信息可能缺失,计划随后可能变——把 EXPLAIN 输出贴进工单前先确认统计是否新鲜。第二,三库的"好计划"词汇表不要互相翻译:SQLite 的 SEARCH 加 USING INDEX 是好信号、SCAN TABLE 不一定是坏信号(小表全扫比索引回表更快);MySQL 的 type=ALL 同理;PostgreSQL 的 Seq Scan 在小表上也是正常选择。判断计划好坏永远要连着表规模一起想,第 5 章的成本模型会给出定量依据。
本节要点回顾
- 三份说明书三种读法:SQLite 读路径行与字节码,MySQL 读 type、key、rows、Extra 四件套,PostgreSQL 读计划树与 cost,并可 ANALYZE 实测。
- 预编译三库同构:一次编译多次执行;SQLite 的 prepare、bind、step、reset 循环是最直白的形态。
- 占位符参数不进解析器,注入防御在机制层面完成,与语言层转义无关。
- SQLite 的 v2 接口在 schema 变更时自动重编译,在线迁移要注意调用线程的尾延迟毛刺。
下一章进入事务:写操作的字节码触发日志与锁,SQLite 如何在单文件上兑现 ACID。