4.2 加法器:从半加器到进位链
4.2 加法器:从半加器到进位链
本节摘要:加法器是 ALU 的运算核。本节从半加器、全加器的真值表推起,用 for-generate 搭出行波进位加法器,再讲超前进位为什么快、代价是什么,最后验证一行
+与手搓结构在电路层面的对应关系。
从真值表推起:半加器与全加器
两个一位二进制数相加,输出本位和与进位——这就是半加器。真值表四行:零加零得零,一加零、零加一得一,一加一得零进一。落成逻辑:和 = a 异或 b,进位 = a 与 b。半加器没法处理"低位传来的进位",把进位输入也纳入,就得到全加器:
library ieee; use ieee.std_logic_1164.all; entity full_adder is port ( a, b, cin : in std_logic; sum, cout : out std_logic ); end entity full_adder; architecture rtl of full_adder is begin sum <= a xor b xor cin; -- 三个输入的奇偶 cout <= (a and b) or (cin and (a xor b)); -- 任意两个为一则进位 end architecture rtl;
cout 的表达式读作:"a 与 b 同时为一,或者 a、b 不相等且低位进了一"。可以不用化简到最简形式直接写 (a and b) or (b and cin) or (a and cin)——多数原则,两个以上为一就进位,可读性更好,综合器自己会化简。
行波进位:把全加器串成链
四位加法就是把四个全加器首尾相接,低位的进位输出接高位的进位输入——这就是行波进位加法器。用 for-generate 写出结构化的版本:
library ieee; use ieee.std_logic_1164.all; entity ripple4 is port ( a, b : in std_logic_vector(3 downto 0); cin : in std_logic; sum : out std_logic_vector(3 downto 0); cout : out std_logic ); end entity ripple4; architecture struct of ripple4 is component full_adder is port (a, b, cin : in std_logic; sum, cout : out std_logic); end component; signal carries : std_logic_vector(4 downto 0); -- 进位链,5 根 begin carries(0) <= cin; gen : for i in 0 to 3 generate fa : full_adder port map (a => a(i), b => b(i), cin => carries(i), sum => sum(i), cout => carries(i+1)); end generate; cout <= carries(4); end architecture struct;
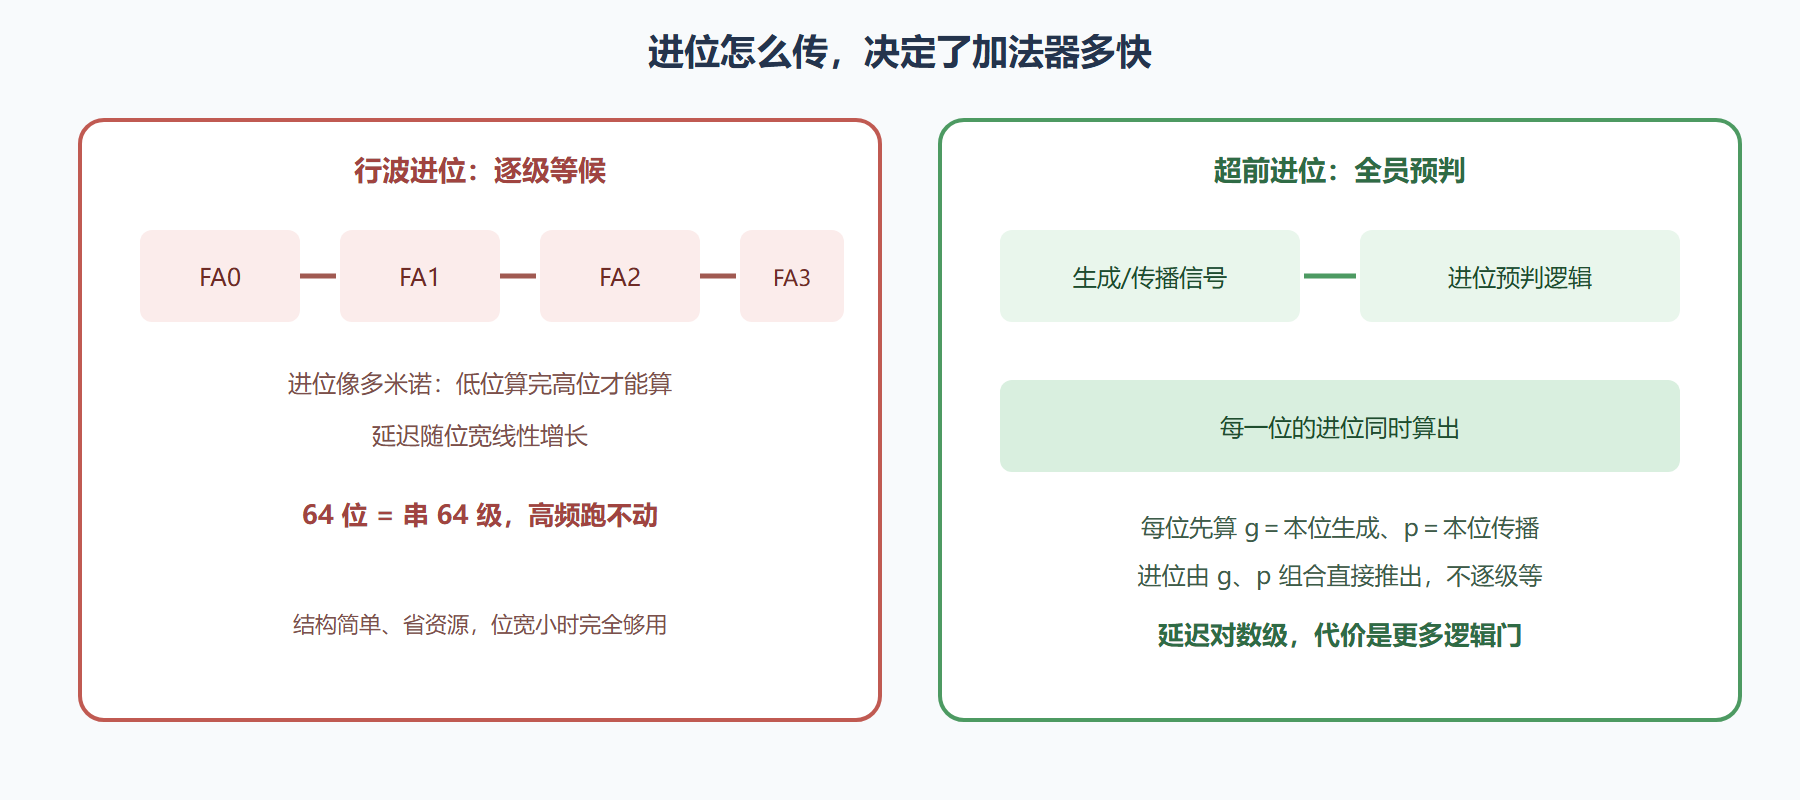
这段代码是结构化描述的样板:声明元件、拉出内部连线、用 generate 重复实例化。改一位数字就能从四位滚到六十四位。行波进位的软肋也在图上:最高位的和要等进位逐级传上来,四级全加器的延迟串联。位宽一大,延迟线性恶化。
图:行波进位与超前进位的速度差异
超前进位:预判代替等待
行波进位慢在"等"。超前进位的思路是每位预先算两个信号:生成信号 g = a and b(本位一定产生进位)、传播信号 p = a xor b(低位进位会穿透本位)。有了 g、p,每位的进位可以直接展开成表达式:c1 = g0 or (p0 and c0),c2 = g1 or (p1 and g0) or (p1 and p0 and c0)……全部并行算出,谁也不用等谁。代价是高位进位的表达式项数变多,门电路变宽——用面积换速度的经典交换。实际工程里不需要手写超前进位,因为 FPGA 的逻辑单元自带专用进位链,综合器把 + 映射上去就是快速加法;理解它的意义在于看懂时序报告时知道"加法器延迟为什么不是位宽乘以常数"。
一行 + 背后是什么
行为级写法只要一行:sum <= std_logic_vector(unsigned(a) + unsigned(b));。把它与手搓的 ripple4 分别综合,对比报告:LUT 数量同量级,专用进位链都被调用。行为级描述与结构化描述是同一电路的两个视角——前者写"做什么",后者写"怎么搭"。工程决策很简单:标准算术用 +,让工具调专用资源;非标准结构(比如进位保留、特殊的进位跳转)才值得手搓。
验证环节给 ripple4 配穷举测试台:四位输入共二百五十六种组合,双循环遍历 a、b,期望值用整型算出再对比。跑完零差异,你的手搓加法器就毕业了。
⚠️ 常见坑:generate 里实例化的元件忘了先 component 声明(或忘了 use 对应的库),报错信息是"找不到元件",新手常误以为 generate 语法错了。结构化描述的三件套——声明、连线、实例化——少一件都不行。
💡 关键直觉:加法器的所有提速手段,本质都在回答同一个问题——"能不能别等低位"。流水线(第 5 章的移位寄存器一节会见到)是另一个答案:等不起就分拍算。
本节要点回顾
- 半加器不管进位输入,全加器三入两出,是加法世界的细胞;
- 行波进位:结构简单、延迟线性增长,generate 一句滚任意位宽;
- 超前进位:g、p 信号并行预判进位,用面积换速度;
- FPGA 有专用进位链:日常写
+即可,工具自动映射快速结构; - 行为与结构互为视角:写什么用行为级,怎么搭用结构级,别拧着来。
实战延伸:进位链延迟与流水线权衡
纯行波进位加法器(ripple carry)的延迟是 O(n),n 是位数。32 位加法器需要 32 个全加器串联,时钟频率上不去。
进位选择加法器(carry select)把高半和低半预计算,根据进位选一个,延迟降到 O(sqrt(n))。进位保留加法器(carry save)则是为多操作数累加设计的——适合乘法器部分积累加。
工程上:8 位以下用 ripple,16-32 位用 carry lookahead/select,64 位以上必须用 carry save + 流水线。
资源-性能权衡
在 FPGA 里,加法器用查找表(LUT)实现。一条进位链会占用连续的 LUT,限制布局。32 位 ripple 在 7-series FPGA 上可能达到 100+ LUT 链长,频率卡在 200MHz。如果目标频率是 400MHz,必须插寄存器(流水线)。
实战代码
-- 8 位 ripple carry adder entity ripple_adder_8 is port(a, b : in unsigned(7 downto 0); cin : in std_logic; sum : out unsigned(7 downto 0); cout : out std_logic); end entity; architecture behavioral of ripple_adder_8 is begin process(a, b, cin) variable s : unsigned(8 downto 0); begin s := ('0' & a) + ('0' & b) + ("00" & cin); sum <= s(7 downto 0); cout <= s(8); end process; end architecture;