2.1 丘奇2012:一本书写进DNA
2.1 丘奇2012:一本书写进DNA
本节摘要:2012 年 9 月,乔治·丘奇团队在《科学》发表《下一代数字信息存储在 DNA 中》,把一本 5.27 兆字节的著作——包括全书文本、十一张图片和一个 JavaScript 程序——写入 DNA 并完整读回,密达每克数百 PB 的理论方向被首次以书籍尺度验证。本节还原这项实验的编码规则、合成与读回流程、错误面貌,以及它以"每碱基一比特"绕开同聚物陷阱的巧思与代价。
先把数据量摆上桌面
理解这个实验的分量,要先看它存了什么:丘奇与人合著的《再生生物学》全书 53426 个单词,折合 5.27 兆比特的数据量,外加十一张 JPEG 插图和一段 53 字节的 JavaScript 程序。在今天这是张软盘都嫌小的体量,但对 2012 年的存储实验而言,它把此前所有分子信息写入纪录一下子拉高了百万倍。此前最大的存储对象,不过是几条短序列上嵌的几十个字节。
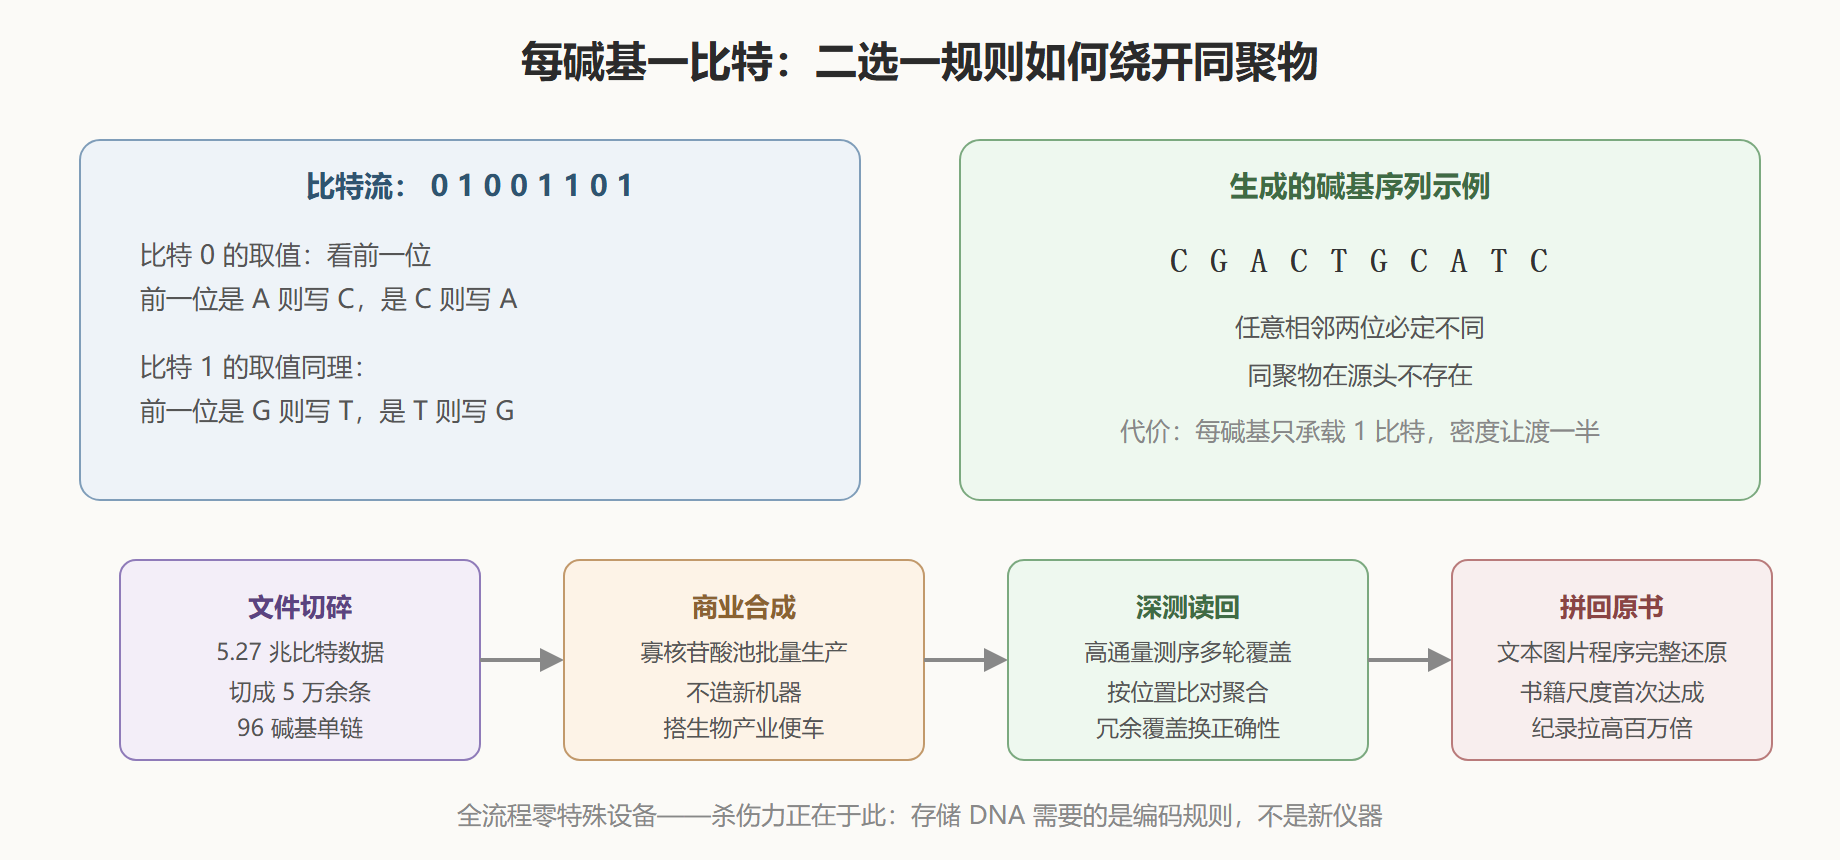
工程上,团队把整个比特流切成 54898 条各 96 个碱基的单链寡核苷酸,交给商业合成服务商以寡核苷酸池方式批量生产——没有定制合成流程,没有特殊仪器,存储实验第一次搭上了生物产业的现成供应链。读回端同样标准:高通量测序平台跑一轮,深测数遍后用软件把reads对回位置。整个流程没有任何一步超出普通基因组学实验室的设备清单,这恰恰是这篇论文最大的杀伤力:它证明存储 DNA 不需要发明新机器,只需要一套聪明的编码规则。
编码规则:用二选一驯服同聚物
这套规则的核心是一次大胆的降维。常规直觉是四个碱基对应两个比特,密度拉满;但直接映射会随机产生长串同聚物——比如连续几个 A——而化学合成在高同聚物区段的差错率陡增。丘奇团队的选择是每碱基只放一比特,且让每个比特的两种取值来自两组不同的碱基:比特零在 A 与 C 之间选择,比特一在 G 与 T 之间选择,具体取哪个,取决于前一个碱基是谁——前一位选了 A,这一位的零就写 C;前一位选了 C,这一位的零就写 A。如此生成的序列天然不会出现任何连续相同碱基,同聚物问题从编码层面被整个绕开。
代价也一目了然:密度砍半。四选一的映射理论上每碱基装两比特,二选一只装一比特,理论密度直接让渡一半。但团队算的是另一笔账:合成错误才是密度的真正杀手,与其在纸面上写满两比特再让错误吃掉,不如写一比特保它读得回来。这笔"密度换保真"的账,此后十年里会被无数后续方案反复重算——从戈德曼的三联体编码到喷泉码,本质上都在找这条曲线上的新最优点。
错误面貌也要如实记录。读回比对显示,最终数据里存在少量碱基错误与个别丢失的寡核苷酸,团队用每个位置多重覆盖的冗余做了弥补,且把插图与程序这类对完整性敏感的内容做了重点核对。按后来的标准,这套"以覆盖度换正确性"的办法粗糙而昂贵——冗余倍数直接堆在合成与测序的账单上。但作为第一篇以书籍尺度说话的论文,它把"错误率是多少"变成了一个可以被测量、被讨论、被改进的工程量,这个转变本身就值回票价。
图:丘奇方案的一比特编码与开山实验流程
实验之外:选址哈佛的深层原因
一个常被忽略的背景是:为什么是丘奇团队先做出来。表面看是运气,实际是三重条件的叠加。其一,丘奇实验室是合成基因组学的重镇,对"序列即信息"的理解远比一般生物实验室深入;其二,团队长期押注芯片合成与寡核苷酸池,对耗材价格与错误率的账目烂熟于心;其三,哈佛所在的生态把信息论学者、合成生物学家与测序工程师放在同一栋楼里。开山实验没有用任何单点黑科技,它是一次纯粹的"组合式创新"——把现成的合成供应链、现成的测序平台和一套新编码规则拼在一起。这对后来者的启发比论文本身更值钱:这个领域的门槛从来不在某一台机器,而在跨学科的账目对齐能力。
要点回顾
- 丘奇团队 2012 年把 5.27 兆比特的书籍、图片与程序写入 DNA,纪录较此前提高百万倍,全程使用商业化合成与测序供应链。
- 编码规则的灵魂是"每碱基一比特加前文感知的二选一",从源头消灭同聚物,代价是密度让渡一半。
- 错误处理走"多重覆盖换正确性"的粗放路线,昂贵但有效,并把错误率第一次变成可测量的工程量。
- 实验的成功是组合式创新的胜利:合成耗材、测序平台与编码规则三者对齐,比任何单点黑科技都重要。
常见追问
每碱基只放一比特,不是浪费了理论容量的一半吗? 是的,这是主动的取舍而非认知局限。四碱基直接映射的理论密度更高,但随机比特流会频繁产生同聚物,而同聚物区正是合成与测序的差错重灾区——错误率一上去,纠错开销会把省下的密度连本带利吐回去。团队用可测量的错误账换取了不可 violated 的约束豁免:序列里根本不存在同聚物,与其纠错,不如让它无从发生。这种"源头免疫"的思想后来贯穿了所有约束编码设计。
实验读回时丢了东西吗? 丢了。部分寡核苷酸在合成或扩增环节缺失,读回的覆盖并不完整。团队的处理方式是靠多重覆盖补位与内容层面的冗余:文本有语言冗余,图片有格式校验,程序有语法自检,个别碱基差错可以被这些上层结构吸收。以归档标准看这套保障很粗糙,但它诚实地划出了问题边界——此后五年纠错码研究的全部动力,就是把"靠运气"换成"靠代数"。
数字备忘
留几组便于复盘的数字。规模:五点二七兆比特,五万四千八百九十八条九十六碱基单链,按当时代价折算的写入开销远超任何商业存储——但作为演示,它买的不是容量,是叙事的可信度。错误面貌:读回数据中的差错以单碱基替换与整条序列缺失为主,与合成化学的已知错误谱系吻合。时间坐标:论文发表在 2012 年 9 月,距高通量测序平台普及只用了几年,距芯片合成的商业化也只有几年——两班车的交汇点,才是这项实验真正的出生证明。
细节补全
一个常被跳过的工程细节:丘奇方案没有给序列配强索引,读回定位靠的是"每条序列长度相同、按排序对位"的约定。这在数据完整时可行,一旦有条序列缺失,后续所有对位都会错位一格——这是它比戈德曼方案更依赖覆盖冗余的结构性原因。把它与本节的编码规则放在一起看,你会得到一个完整的判断:这套方案是"在一切顺利的前提下最高效"的设计,而戈德曼方案是"在一切都不顺利时仍可审计"的设计。两种设计哲学没有高下,只有场景——这恰好是下一节的对比框架。
丘奇方案证明了快与密,但错误与索引的粗糙留下了明显的毛边。一年后,大西洋对岸的戈德曼团队交出了另一份答卷——慢一点、重一点,却几乎无懈可击。下一节拆解它。