2.2 戈德曼2013:EBI的稳健路线
2.2 戈德曼2013:EBI的稳健路线
本节摘要:2013 年 1 月,欧洲生物信息研究所的尼克·戈德曼与尤恩·伯尼团队在《自然》发表 DNA 归档存储方案,把莎翁全部十四行诗、沃森与克里克 1953 年那篇双螺旋论文的扫描件、《我有一个梦想》演讲音频等共约 75 万字节数据写入 DNA,读回零字节错误。本节拆解这套方案的完整流程——压缩、三联体霍夫曼编码、交替读码框、逐序列索引与多重冗余合成——并解释它为什么被称为"稳健路线"。
从一份文件清单说起
戈德曼团队选的文件单子像一份宣言:莎士比亚全部 154 首十四行诗的文本、一篇经典科学论文的 PDF 扫描件、一张研究所的照片、一段二十六秒的演讲录音,外加方案自身的摘要文本——五份文件共约 75 万字节,文本、图像、音频、格式化文档各占一样。这个清单的潜台词很直白:DNA 存的是任意字节流,不挑内容、不挑格式。相比丘奇团队用一本书验证"能存多少",欧洲团队更关心另一个问题:存进去的东西,能不能以可验证的方式分毫不差地拿回来。
于是这份答卷把重注押在了可靠与可溯上。整条流水线设计得像一份审计报告:每个环节都有编号、有校验、有冗余,读回时每份文件都能对照校验和宣布"零差错"。论文发表后,媒体津津乐道于"一个咖啡杯就能装下全世界的数据",但对工程界更有价值的是那张编码流程图——此后十年,几乎所有严肃的存储方案都以它为骨架做增量改造。
编码流程:五步造出碱基
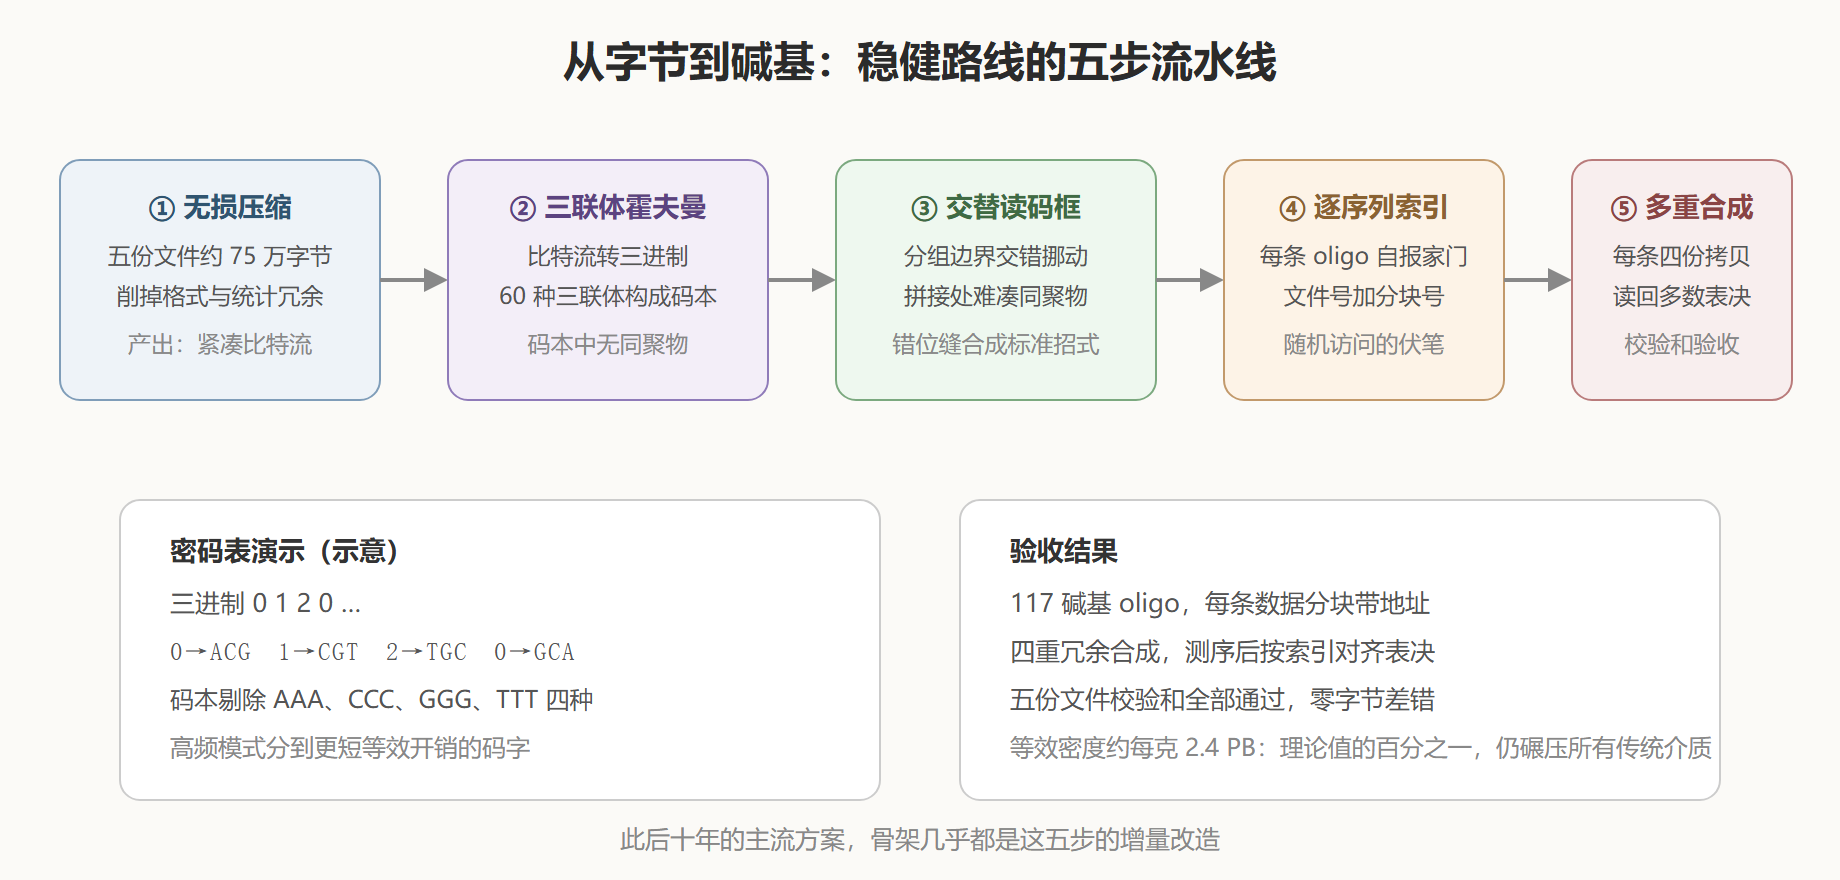
第一步,压缩。五份文件先用常规无损压缩算法去冗余,与存储无关的格式开销尽量削掉。这一步和磁盘世界的压缩没有区别,不展开。
第二步,三进制化与霍夫曼编码。这是方案的灵魂。先把比特流转成三进制数字流,再设计一张"三联体密码表":以三个碱基为一组,从 64 种可能组合里剔除全同聚物的四种(AAA、CCC、GGG、TTT),剩下的 60 种三联体构成码本,用霍夫曼算法按出现频率分配码字——高频三进制模式拿到更短的等效开销。由于码本里根本不存在同聚物三联体,单条序列内部天然不会出现三个连续相同碱基。
第三步,交替读码框。上面那招管住了三联体内部,但两个相邻三联体的拼接处仍可能凑出同聚物——比如前一个三联体以 AA 结尾、后一个以 A 开头。戈德曼的处理极其聪明:让连续的 oligo 轮流使用不同的读码起点,交错挪动分组边界,使任何两条序列之间、以及单条序列的跨组边界上都不易拼出三连同碱基。这道"错位缝合"后来成了所有约束编码的标准招式。
第四步,加索引。每个数据分块前后都接上一段寻址序列,标明自己属于哪份文件的第几个分块。这看似平淡,实则是把"存储"从磁带升级成"分子硬盘"的关键伏笔——有了序列级地址,才有后来的随机访问(第三章展开)。开山双雄里,正是戈德曼方案确立了"每条序列自报家门"的范式。
第五步,合成与多重冗余。每条 117 个碱基的 oligo 各合成四份互为备份的拷贝,测序读回后按索引对齐、四取多数表决,再对照校验和验证文件完整性。结果:约 75 万字节、15 万余条 oligo,读回后所有文件校验通过,仅发现极个别碱基级别的差错且全部被冗余吸收——用《自然》审稿人的话说,这是第一个达到归档级可靠性的演示。
图:戈德曼五步编码流水线
稳健的账单:密度与成本的让步
稳健不是免费的。逐项数一数这套方案的让步:每碱基的有效比特数被三联体霍夫曼与冗余稀释,等效密度落在每克 2.4 PB 的量级,只有理论极限的百分之一上下;每条 oligo 四重合成,写入成本直接乘以四;索引序列占了每条链相当比例的长度,纯数据区进一步缩水。论文发表时不少同行嘀咕:这么重的开销,离实用还很远吧。
历史却给这套"浪费"记了功。其一,索引与多数表决确立了"可验证性优先"的工程文化,后来所有严肃方案的随机访问、纠错码设计都建立在这个地基上;其二,它留下的密度赤字成了领域前进的靶子——2017 年的喷泉码方案打的正是这个靶子,把密度一路打到逼近理论极限;其三,五步流水线的模块化切分,让后来的研究者可以各自攻坚单步而不必整体推倒。可以说,丘奇方案给出了这项技术的上限宣言,戈德曼方案给出了它的工程守则。
要点回顾
- 戈德曼团队 2013 年把五份异构文件约 75 万字节写入 DNA,四重冗余加多数表决,读回零字节错误,是首个归档级可靠性的完整演示。
- 方案的五个部件——压缩、三联体霍夫曼、交替读码框、逐序列索引、多重合成——此后十年成为主流方案的标准骨架。
- 剔除同聚物三联体与错位读码框的组合,从源头杜绝同聚物;这条"约束进码本"的思路影响至今。
- 稳健的代价是密度与成本:等效密度仅理论值百分之一、写入成本乘四;这个赤字正是后续编码研究的靶心。
常见追问
为什么选三联体而不是二联体或四联体? 二联体只有十六种组合,剔除同聚物后余量太少,霍夫曼编码的压缩空间随之萎缩;四联体二百五十六种组合又过于奢侈,码本维护与解码复杂度陡增。三联体六十四种组合里剔除四种全同聚物后余六十种,既给霍夫曼算法留出了足够的频率分层空间,又天然满足了最长同聚物的约束边界——这是约束满足与压缩效率之间的一次教科书式折中。
五份文件为什么偏偏是那五份? 文本、扫描件、图片、音频各选一样,是在向评审与公众同时证明"字节流无偏好":任何格式进编码器都只是比特。把方案摘要本身也存进去,则是一枚技术界的传统彩蛋——自指式存证,既是完整性测试,也是宣言:这份文件宣布了自己的存储方式,并用自己的方式被验证。
四重冗余为什么不是五重或三重? 三重表决在两票对一票时无法仲裁平局,且合成批次偶发的批量差错可能同时影响两条拷贝;五重则让合成账单再涨四分之一,边际收益有限。四重是"平局可仲裁、成本可承受"的最小偶数解——你看,连冗余倍数都是一道工程算术题。
细节补全
戈德曼方案还有一处容易被忽略的巧思:读码框的交替不仅防同聚物,还顺带服务了纠错。因为相邻序列使用不同读码起点,同一段数据的两条拷贝在碱基层面几乎不相似——测序读段之间不会因相似而错误配对到一起。这种"冗余副本去相关化"的思想,在磁盘阵列与分布式存储里对应的是交差校验,分子版本做得同样优雅。把它记进工具箱:凡要放大冗余,先想清楚副本之间的相关性——相关冗余在关联错误面前会一起倒下。
两篇论文、两条路线,各留下一半答案。下一节把它们摆上同一张手术台,逐项对比,并盘点开山之后领域捡到的三笔遗产。