- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
MapReduce 分布式计算模型教程 · 教程导读
一句话定位:MapReduce 是把"分而治之"工程化到上千台机器的一套计算范式——把大问题切成小块(切分)、每块独立加工(映射)、再把中间结果汇拢归并(汇流)。本教程用"范式三幕剧"的叙事,把这三幕逐一讲透,并落到可复算的真实代码上。
为什么用"三幕剧"来讲 MapReduce
市面上的 MapReduce 材料,多半按组件罗列:先讲架构,再讲流程,然后是 API、调优、应用场景。读完很容易记住一堆名词,却在面对一道真实的计算题时不知从何下手。问题出在叙事方式:组件是静态的,而 MapReduce 的精髓是一条动态的数据旅程。
换个角度。任何一次 MapReduce 计算,无论数词频、做 Join 还是建索引,都在上演同一出三幕剧:
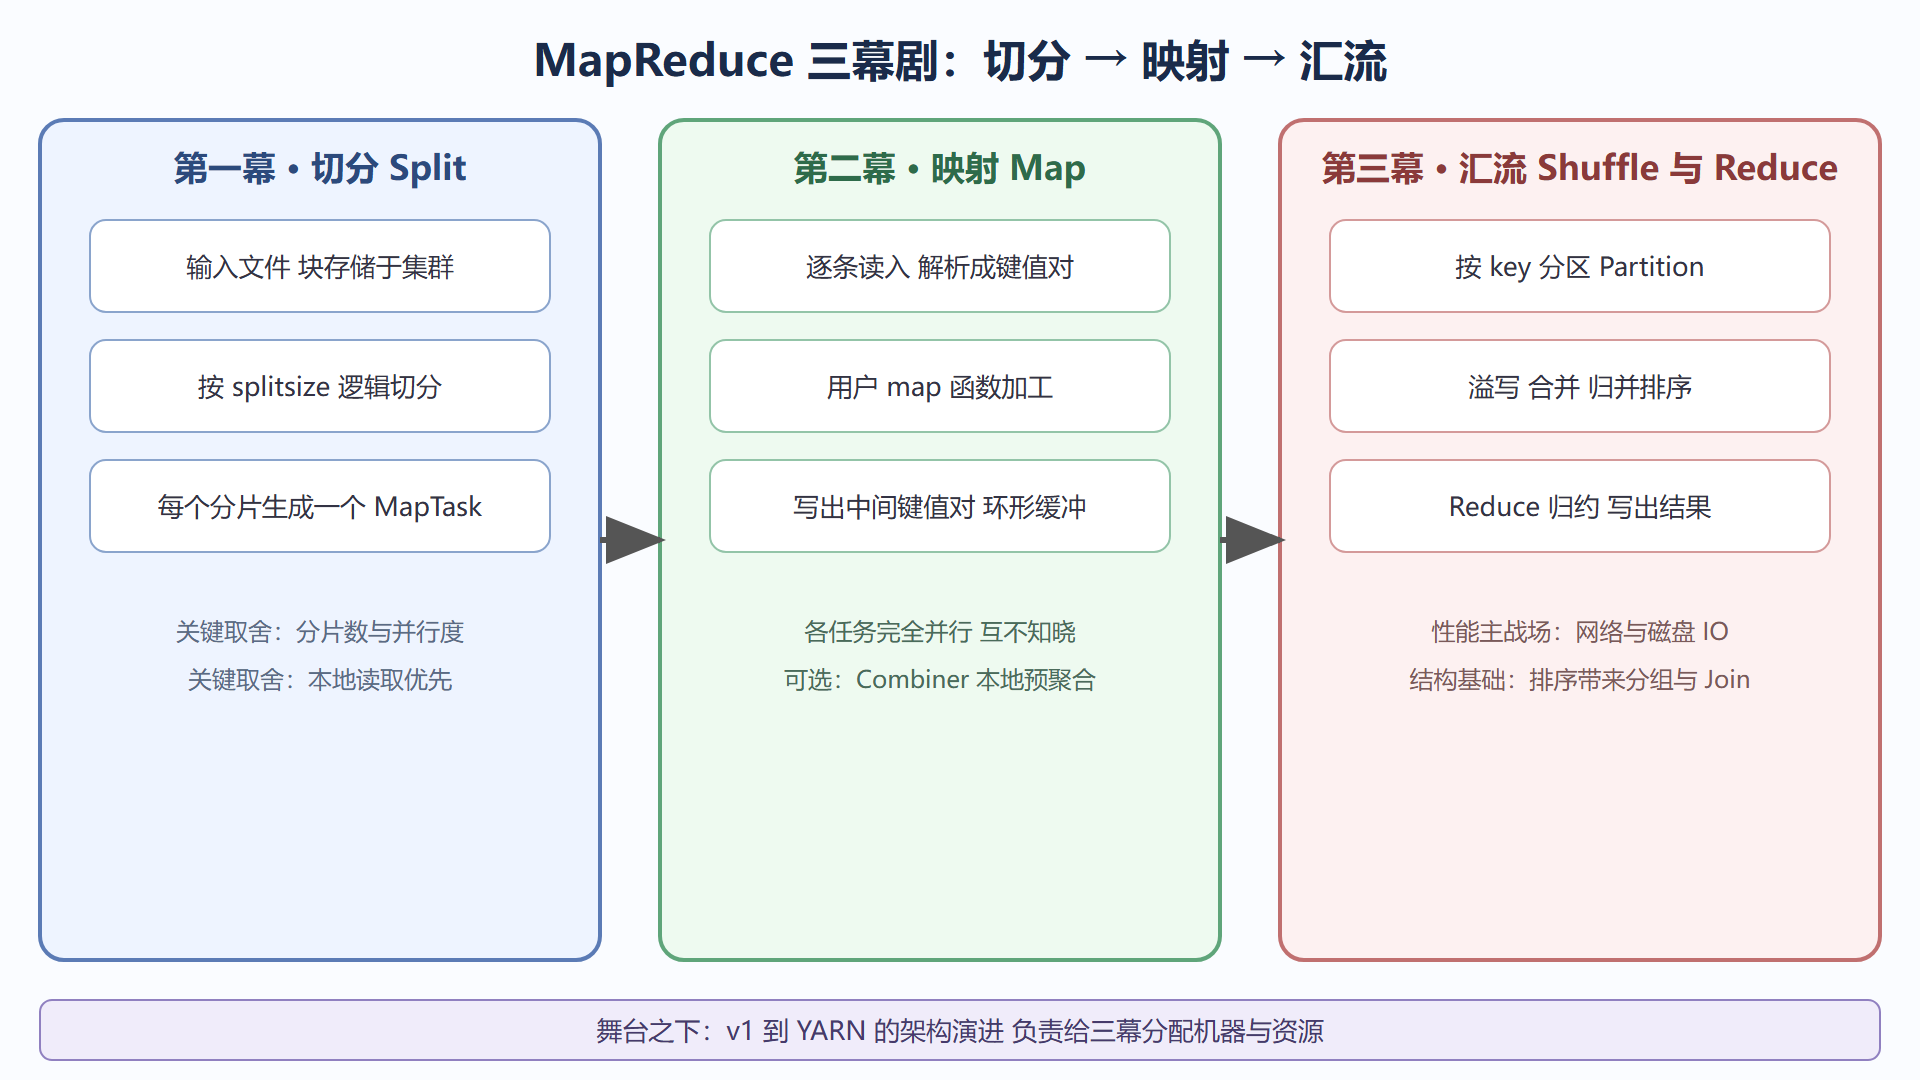
- 第一幕,切分(Split):输入数据被切成若干分片,每个分片对应一个 Map 任务。切多细、在哪台机器上切,直接决定了并行度和网络开销。
- 第二幕,映射(Map):每个 Map 任务独立地把自己的分片加工成一批中间键值对。这一幕里各任务互不知晓、完全并行,是"分而治之"中"分"的完成态。
- 第三幕,汇流(Shuffle 与 Reduce):中间结果按键分区、排序、汇聚到 Reduce 端,相同键的值被归并成列表交给用户归约函数,最终写出结果。这一步既是性能主战场,也是很多经典模式(Join、二次排序、TopN)得以成立的结构基础。
三幕之前有序幕(范式从哪来、为什么长这样),三幕之后有谢幕(范式哪里不够用、被谁接替)。所以本教程的结构就是一场完整的戏剧:序幕讲思想,三幕讲机制,中间插一场"舞台与调度"讲 v1 到 YARN 的架构演进,再用一整章"用范式解题"把 WordCount、Join、TopN 一道道真实计算题算给你看,最后幕落,谈局限与传承。
三幕剧全景一图
图 0-1 MapReduce 范式三幕剧全景
各章导览
第 1 章 序幕:分而治之的范式。回答两个问题:MapReduce 到底是什么、为什么 2004 年 Google 那篇论文能开创一个时代;以及三幕剧范式的优劣取舍——它把并行、容错、负载均衡全部收进框架,代价是计算模型被严格约束。读完这章你会明白:写 MapReduce 程序,本质上是把业务问题"翻译"成 map 和 reduce 两个函数。
第 2 章 第一幕:切分。输入分片是三幕剧的开场锣。分片不是物理切块,而是逻辑规划;分片大小如何影响 Map 任务数、毛刺与整体吞吐;数据本地性为什么是"移动计算比移动数据便宜"的落地;压缩如何同时作用于存储与 Shuffle 传输。
第 3 章 第二幕:映射。Map 任务的执行机制(InputFormat、RecordReader、环形缓冲区);类型系统与序列化的设计逻辑——为什么框架宁可用啰嗦的 Writable 也不用 Java 原生对象;Combiner 作为"本地 Reduce"的适用边界与典型误用。
第 4 章 第三幕:汇流。全书最重的一章。Shuffle 的六个步骤逐一拆解(Map 端环形缓冲、溢写、合并,Reduce 端拷贝、归并、分组);Partition 决定数据归属;排序不只是排序,更是分组与 Join 的结构基础;最后是 Reduce 与 Output 的收尾机制。
第 5 章 舞台与调度:架构。三幕在什么舞台上演出:经典 v1 的 JobTrack 与 TaskTrack 为何成为瓶颈,YARN 如何把资源管理与计算框架解耦,以及容错机制(重试、备份任务、推测执行)如何让三幕剧在中途翻车时还能演完。
第 6 章 用范式解题:实战。范式学完了,来做题。WordCount 全流程逐行复算(输入怎么流过三幕、每个阶段的中间结果长什么样);Reduce Join 与 Map Join 的两种实现及倾斜对策;TopN 与倒排索引;计数器、日志与常见的性能调优手段。这一章的每一道题都给出可复算的代码与数据。
第 7 章 幕落之后:局限与演进。范式边界在哪里:迭代计算为何低效、Shuffle 为何昂贵、流式场景为何不适合;Spark 与 Flink 如何在内存计算与执行模型上接棒;以及 MapReduce 在今天的数据栈里仍值得学的原因——它仍是理解分布式批处理的"最小完整样本"。
适合谁读
- 后端或数据方向工程师,写过单机程序,想理解"一段代码如何在上千台机器上跑起来";
- 正在学 Hadoop 生态的读者,需要一个以 MapReduce 为主线、能串起 HDFS/YARN/Hive 背后共性的专题讲解;
- 面试备考者:Shuffle、数据倾斜、二次排序、推测执行这些高频考点,本教程全部给出机制层的解释而非背诵版答案;
- 计算机专业学生:把 MapReduce 当作分布式系统课程的一个完整案例,并行、容错、一致性、调度四大主题都能在里面找到实例。
阅读前提:会 Java 基础语法,知道 Linux 命令行怎么用,对 HDFS"文件切块存多副本"有大体印象即可。不需要先修分布式课程——需要的地方我会现场补。
怎么读效率最高
第一遍按章节顺序读,重点跟住第 4 章的 Shuffle 拆解,它是全书的枢纽。第二遍直接进第 6 章,把 WordCount 和 Join 的代码亲手跑一遍(哪怕是本地伪分布式),对照每一步输出与教程里的中间结果。第三遍带着自己的业务问题回来:你想算的那个东西,切分边界在哪、map 输出什么键、reduce 怎么归并——能回答这三个问题,你就已经会用这个范式思考了。
三幕剧的启示在于:框架替你扛下了并行的全部脏活,你只需回答两个问题——怎么把问题拆开,怎么把结果合上。这就是 MapReduce 留给后来所有计算引擎的思想遗产。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...