- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
XGBoost梯度提升算法实战教程
XGBoost 是一棵接一棵地"补残差"的机器:每一轮迭代,模型都盯着上一轮还没消除的误差,种下一棵新树去修正它,直到残差收敛到可以接受的水平。 本教程沿着"残差收敛"这条主线,从预测误差的直觉出发,经过目标函数推导、参数调优、完整实战,最终抵达六个行业的真实案例。
这本教程讲什么
梯度提升的本质可以用一句话概括:模型当前还不够好的部分,就是下一棵树要学习的目标。XGBoost 把这个朴素想法推到了工程与算法的双重极致——它在目标函数里写进了正则项,在分裂查找里用上了二阶导数信息,在系统层面做了并行与缓存优化,因此成为过去十年表格数据任务上最常被提起的名字之一。
本教程不满足于罗列 API。我们把 XGBoost 拆成六个阶段去讲:为什么需要它(第 1 章)、它的数学骨架如何搭起来(第 2 章)、参数背后的物理含义(第 3 章)、一次完整实战怎么走通(第 4 章)、高阶问题怎么处理(第 5 章)、真实行业怎么用它(第 6 章)。六个阶段前后咬合:没有第 2 章的分裂增益公式,第 3 章的 gamma 与 lambda 就只是玄学参数;没有第 4 章的实战套路,第 6 章的案例就成了空中楼阁。
全册知识地图
XGBoost 全册知识地图:残差收敛之路
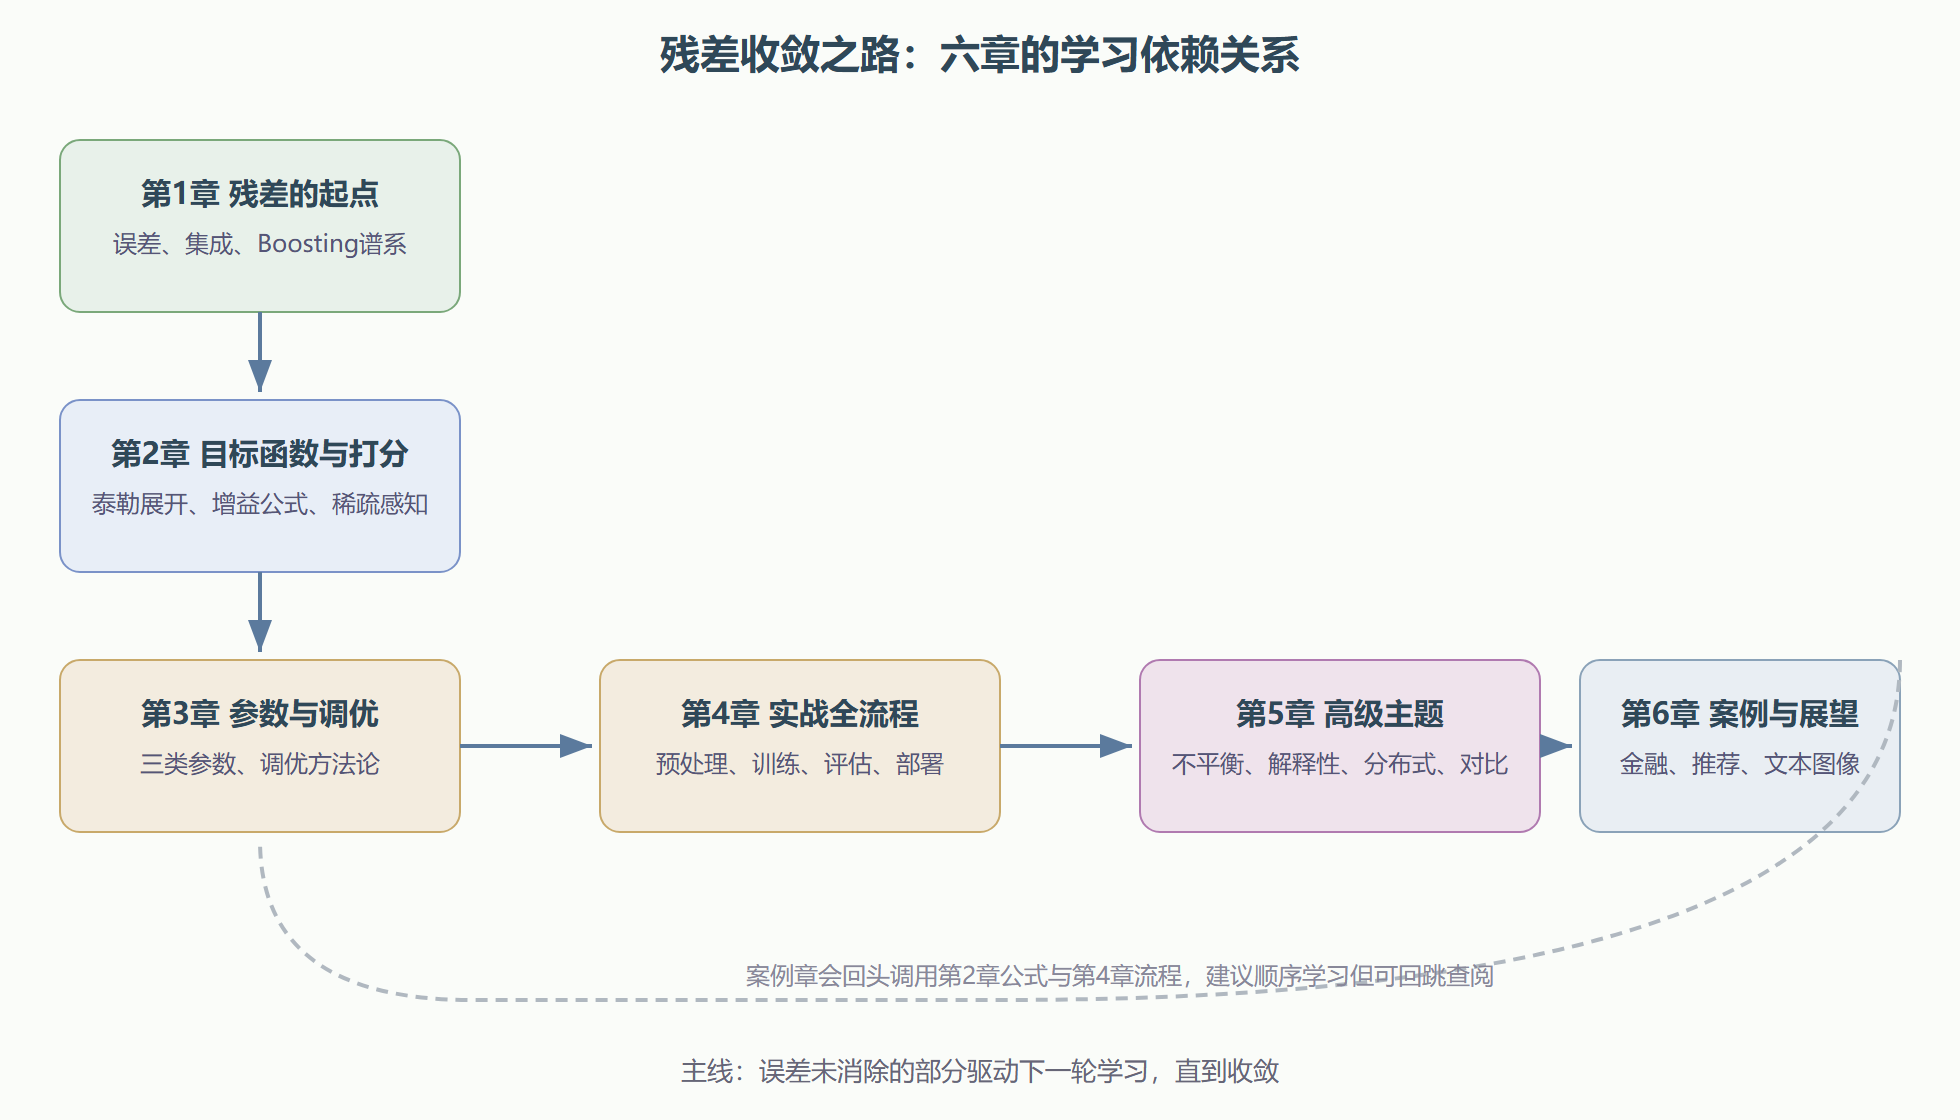
各章一句话导读
第 1 章 残差的起点:从一个预测房价的错误出发,理解"残差"为什么能成为学习目标,再看 Bagging 与 Boosting 两条集成路线的分野,最后把 XGBoost 放回 Boosting 家族谱系里定位。
第 2 章 目标函数与树的打分:全教程的数学核心。目标函数如何被泰勒二阶展开改写,叶子权重为何有闭式解,分裂增益公式如何同时决定树的生长与剪枝,稀疏值如何被默认方向吸收。
第 3 章 参数与调优:把第 2 章公式里的每一个符号对应到一个可调参数,讲清参数的物理含义、优先级与调优顺序,避免无头苍蝇式的网格搜索。
第 4 章 实战全流程:从环境安装到模型上线的完整走查,两套接口(原生与 sklearn 风格)的差异、交叉验证、早停、特征重要性、模型存取与部署形态。
第 5 章 高级主题:真实数据不会干净。不平衡样本、特征工程、模型解释性(SHAP)、分布式训练,以及与随机森林、LightGBM、神经网络的选型对比。
第 6 章 应用案例与展望:金融风控、推荐与广告、文本与图像三类场景的完整案例拆解,收束到 XGBoost 的优势边界与未来趋势。
适合谁读
有 Python 基础、了解一点机器学习概念(知道训练集和测试集的区别)的读者都能跟上。数学部分只要求会求导;每一步推导都配了代码验证,公式看不完也可以先跑代码建立直觉,再回头补推导。有 GBDT 经验的读者可以直接从第 2 章切入。
一句话总结本册的主张:理解 XGBoost 的钥匙不是背参数表,而是理解"每一轮都在修正上一轮的残差"这个循环里,损失、正则、增益三者如何互相牵制。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...