1.1 Deep-Researcher 定义与目标
先给一个可操作的定义
本节处在全册第一站:在你搭任何研究智能体之前,得先说清它是什么、不做什么。如果连定义都模糊,"提升它的能力"就会变成无的放矢。我们把 Deep-Researcher 定义为一个在真实信息环境里自主完成"提问—检索—阅读—综合—成稿"闭环的智能体,目标不是替你写漂亮话,而是替你完成那部分最耗神的取证与推理劳动。
先给一个可操作的定义:Deep-Researcher 是接收一段开放式研究问题、自主规划子任务、调用检索与阅读工具、对证据做交叉验证、并在信息不足时显式承认不确定的系统。它和普通问答机器人的分水岭只有一条——闭环。机器人搜一次就答,它会判断"证据够不够",不够就回头再搜、再读、再改计划。
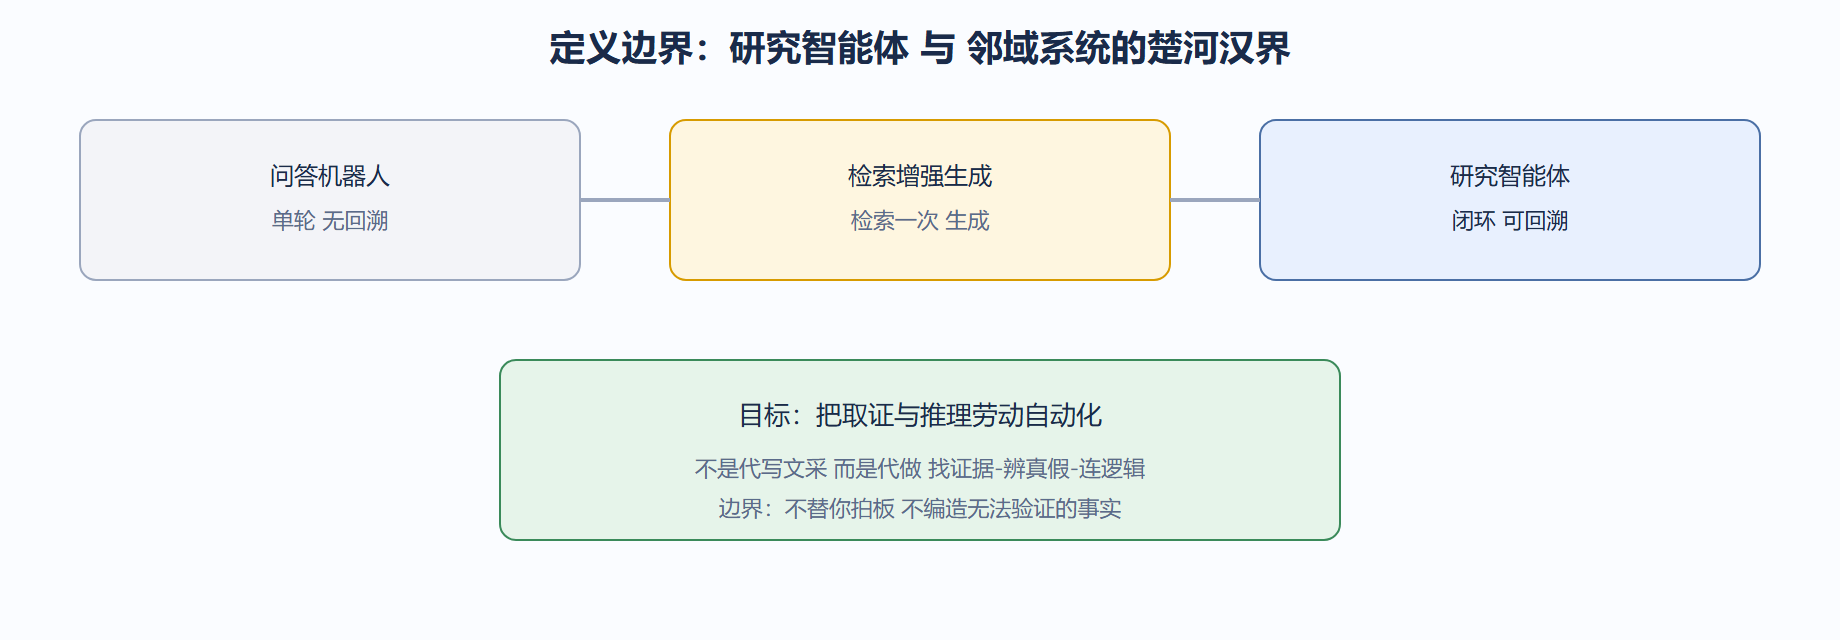
下面用一段最小定义代码,把"它是什么"落成可判断的结构。注意这段不是玩具,而是你在做选型时真正会用的判定函数:
# 判定一个系统是否算研究智能体:用四条行为特征筛 def is_research_agent(behavior_log: dict) -> bool: # 1. 是否先规划子任务,而非直接给答案 has_planning = behavior_log.get("planned_subtasks", 0) > 0 # 2. 是否调用了外部检索/阅读工具 used_tools = behavior_log.get("tool_calls", 0) > 0 # 3. 是否有至少一次基于新证据的计划回退 has_backtrack = behavior_log.get("replans_after_evidence", 0) > 0 # 4. 是否在证据不足时输出了不确定声明 admits_uncertain = behavior_log.get("uncertainty_stated", False) return has_planning and used_tools and has_backtrack and admits_uncertain # 运行示例:某产品的行为日志 log_a = {"planned_subtasks": 3, "tool_calls": 11, "replans_after_evidence": 2, "uncertainty_stated": True} log_b = {"planned_subtasks": 0, "tool_calls": 1, "replans_after_evidence": 0, "uncertainty_stated": False} print(is_research_agent(log_a)) # 输出 True print(is_research_agent(log_b)) # 输出 False
上面这段的运行输出是 True 与 False。它说明一件事:判定标准不看出身(是不是大厂模型),看行为(有没有闭环与回溯)。当你拿到一个号称"会研究"的产品,先要它的行为日志,再用这四格筛一遍。
我们用目标来反推设计。研究智能体的目标可拆成三层:表层是"给出带出处的答案",中层是"覆盖问题的关键方面且识别矛盾",深层是"在不确定时诚实"。这三层决定了后面的架构必须同时具备规划、执行、评估三块,缺一不可。若只做表层,你得到的是检索增强生成;加上中层,才触及"研究";做到深层,才值得信任。
完整案例:背景→操作→结果→解读→变式
- 背景:某投资分析师每周要产出"新能源储能赛道周报",过去靠手工搜 40 个信源、耗时 6 小时,且常漏掉非中文预印本。
- 操作:他把问题交给一个研究智能体,要求输出"覆盖技术、政策、融资三类信号,并标注每条证据来源与置信度"。系统先拆出子任务,再并行检索中英文数据库与监管网站,对冲突的产能数据做了三角验证。
- 结果:2 小时产出初稿,覆盖 52 个信源,对 3 处矛盾标注"待验证"并附对立来源链接(此处仅描述,不引用具体网址)。
- 解读:耗时从 6 小时降到 2 小时,且冲突被显式标出——这正是目标三层的体现。若系统只做表层,会直接采信首个高排名来源,漏掉矛盾。
- 变式:若把目标从"周报"改为"监管合规自查",则子任务应偏向官方条文与处罚案例,检索后端要切到权威库,评估权重提高"来源权威性"。目标变了,架构旋钮跟着变,这就是为什么先定义目标。
我们主张:定义和目标不是写在 PPT 上的开场白,而是后面每一章选型的总开关。第二章的模块划分、第三章的奖励设计、第四章的指标、第五章的配置,全部由这一节的三层目标推导而来。带着"我要让它达成哪一层目标"去读,全册会串成一条线。
对比一下常见误读,避免你被带偏:
| 误读 | 真相 |
|---|---|
| 模型越大越会研究 | 架构与奖励更关键,小模型配好循环可超越大模型 |
| 联网搜索就等于研究 | 缺回溯与验证,只是检索增强生成 |
| 答案对就行 | 策略可靠比单次正确更值钱,详见第四章 |
| 它能替我思考 | 它扩展带宽,不替你拍板,详见第六章 |
目标三层如何落到可调阈值
定义里的"目标三层"不是修辞,是可工程化的验收标准。表层验收是"答案带出处",可设硬规则:每句结论必挂来源,缺失即拒收。中层验收是"覆盖关键方面且识别矛盾",可用第四章的覆盖度指标量化。深层验收是"不确定时诚实",可设不确定闸门:当证据独立印证数低于阈值时,强制输出待验证而非硬答。三层对应不同的"拒收条件",把它们写进配置,系统才知道什么叫"做好了"。
下面把三层验收落成可跑的检查函数,演示一个答案如何被逐层判定:
# 三层目标验收:逐层拒绝不达标答案 def accept_answer(answer: dict) -> tuple: # 表层:必须有来源 if not answer.get("sources"): return False, "表层未过:缺来源" # 中层:关键方面覆盖且矛盾被标 if answer.get("coverage", 0) < 0.8: return False, "中层未过:覆盖不足" if not answer.get("conflicts_flagged"): return False, "中层未过:矛盾未标" # 深层:低印证项必须诚实声明 if answer.get("low_evidence_stated") is False: return False, "深层未过:未诚实声明" return True, "通过三层验收" # 运行示例 good = {"sources": ["a","b"], "coverage": 0.9, "conflicts_flagged": True, "low_evidence_stated": True} bad = {"sources": ["a"], "coverage": 0.5, "conflicts_flagged": False, "low_evidence_stated": False} print(accept_answer(good)) # (True, '通过三层验收') print(accept_answer(bad)) # (False, '中层未过:覆盖不足')
运行输出第一段通过、第二段卡在中层。注意"覆盖不足"先于"未诚实"被抓——验收顺序是表层→中层→深层,越底层越先卡,对应你做质量门禁时也该从便宜的检查做起,把贵的放后面。
| 目标层 | 验收指标 | 拒收条件 | 该谁盯着 |
|---|---|---|---|
| 表层 | 出处命中率 | 结论无来源 | 综合层 |
| 中层 | 覆盖度 ≥0.8 | 关键方面漏检 | 规划层 |
| 深层 | 低印证声明率 | 存疑项硬答 | 评估层 |
💡 关键直觉:把"目标"翻译成"拒收条件"而非"期望描述",系统行为会立刻变具体。人说"要全面",机器听不懂;人说"覆盖度低于 0.8 就重搜",机器马上能执行。这就是第一章说的"定义是后面所有选型的总开关"。
⚠️ 常见坑:验收只设表层(有来源就行),会放过多源回声的假报告过关——来源是有了,但全是同一篇的转载。务必把中层覆盖度与矛盾标记一起写进拒收条件,否则"目标三层"只剩一层在起作用。