第一章:Deep-Researcher 概述与核心概念
本章是全册的地基。我们不急着画架构图,而是先把"研究智能体"这个词的边界划清楚:它和普通问答机器人、和普通检索增强生成系统到底差在哪,为什么非得在真实互联网里用强化学习训练,以及它真正替你省下的那部分认知劳动是什么。读完这一章,你应当能用一句话向同事说清 Deep-Researcher 的定位,也能在别人拿一个号称"会研究"的产品忽悠时,指出它缺了哪块。
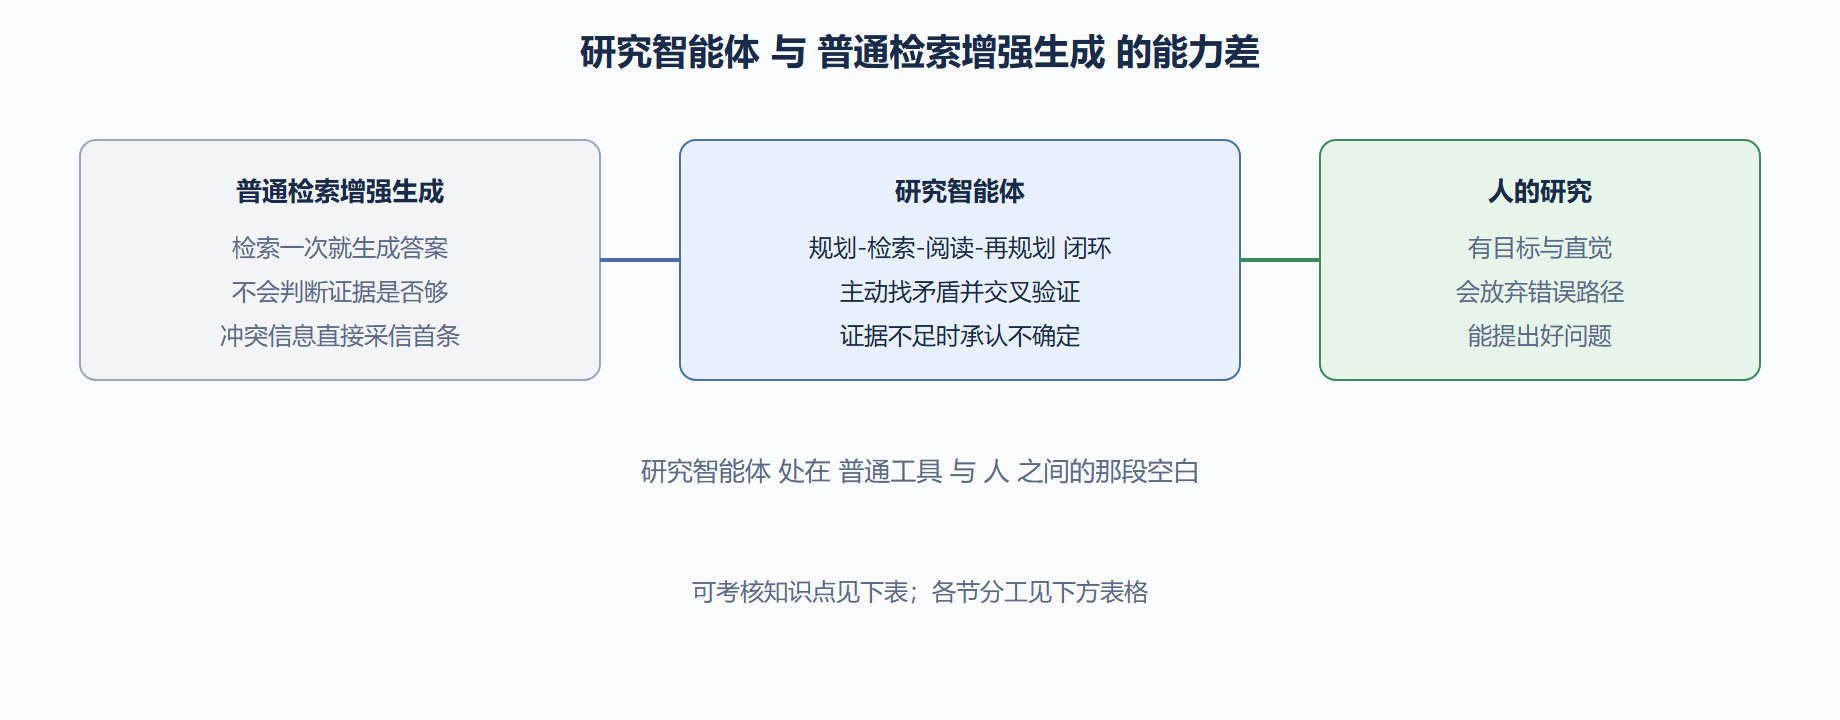
可考核知识点(读完你应能回答)
- 给出一个研究任务,能区分它属于"检索型"还是"研究型",依据是是否需要多轮判断与回溯。
- 能口述"规划自主性、执行自主性、评估自主性"三者分别解决什么问题。
- 能解释为什么在静态维基切片上训出的策略,迁移到真实网络会失效。
- 能举出一个"诚实性"被奖励信号塑造的例子。
- 能说清本地小模型方案与云端大模型方案各自适合什么场景。
各节分工
| 节 | 解决的问题 | 读完你会 |
|---|---|---|
| 1.1 定义与目标 | 它到底是什么、目标边界在哪 | 写出一段不踩坑的定义 |
| 1.2 核心理念 | 真实环境交互与强化学习为何关键 | 说清训练场选择的影响 |
| 1.3 发展历程 | 从工具辅助到认知自主的脉络 | 讲出三个里程碑 |
| 1.4 独特价值 | 它替你省下的认知劳动是什么 | 向业务方论证投入 |
我们这一章刻意压住了代码量,因为概念没对齐就去调参,只会把错误放大。等第二章你把模块认全了,第三章再上算法,那时每一行代码你都知道它在闭环的哪一步。先决条件很低:只要你知道大语言模型能读一段文字、再产出一段相关文字即可。下一章我们从"系统由哪些块拼成"切入。
为什么必须有这一章(再展开)
第一章不急着画图,是因为概念没对齐就去调参,只会放大错误。我们在工程里反复见到:团队跳过"定义与目标",直接堆模块,结果做出一个"会搜但不知何时停"的怪物。先统一心智模型,后面每一章的选型才有锚点。这一章解决的不是"怎么实现",而是"怎么想"——想清楚,实现才有方向。
读完这一章你能拿走的具象能力:
- 能用四格行为判定(规划/工具/回溯/诚实)区分真研究智能体与伪装品。
- 能向非技术同事一句话讲清它和检索增强生成、问答机器人的边界。
- 能解释"为何真实环境训练不可省",在选型争论里站稳。
- 能列出三个发展里程碑,给任何新论文定位历史坐标。
各节分工(补产出列):
| 节 | 解决的问题 | 读完你会 | 产出 |
|---|---|---|---|
| 1.1 定义与目标 | 它是什么、边界 | 写不踩坑定义 | 三层目标验收清单 |
| 1.2 核心理念 | 真实环境RL为何关键 | 说清训练场影响 | 奖励塑形草图 |
| 1.3 发展历程 | 脉络与拐点 | 讲三里程碑 | 技术谱系归类法 |
| 1.4 独特价值 | 省下哪部分认知劳动 | 向业务方论证 | 价值论证话术 |
本章常见误区:把"联网搜索"等同于"研究";以为模型越大越会研究;认为训练场可以随便用静态库替代。这三条在 1.1、1.2 已被逐项拆穿。
与邻章边界:第一章只回答"是什么、为什么",不碰"怎么拆模块"(那是第二章)、"怎么训"(第三章)。若你读第一章就想调代码,说明跳太快——定义没定,后面全是空中楼阁。
本章速查清单
读完第一章,应能勾选:□ 能用四格筛区分真假研究智能体;□ 能解释泳池海洋论断;□ 能列出三里程碑;□ 能向非技术同事讲清边界。四勾全满,说明第一章心智模型已对齐,可进第二章。少任一项,先回对应节补,别带着模糊进架构章。
评论区
(0)
U