2.4 数据流与工作机制
一张证据生命周期图
本节是架构章的收口:用一张证据生命周期图,把"网页上的字"怎么一步步变成"报告里带出处的句子"讲透。在全册里,这是第二章最该动手的一节——我们建议读到这里拿一张真实问题,在图上把数据走一遍,卡住处就是你还没吃透的环节。数据流顺了,第三章的算法才知道作用在哪些字段上。
一条证据的生命周期大致是:原始网页 → 抽取正文 → 抽命题(主张、证据、置信度、来源)→ 进知识库去重 → 综合层连成论证 → 质量评估(置信度够否)→ 够则成稿、不够回 planner 补搜。注意每一步都产生结构化字段,而非只留一坨文本。字段化是可验证、可回溯的前提。
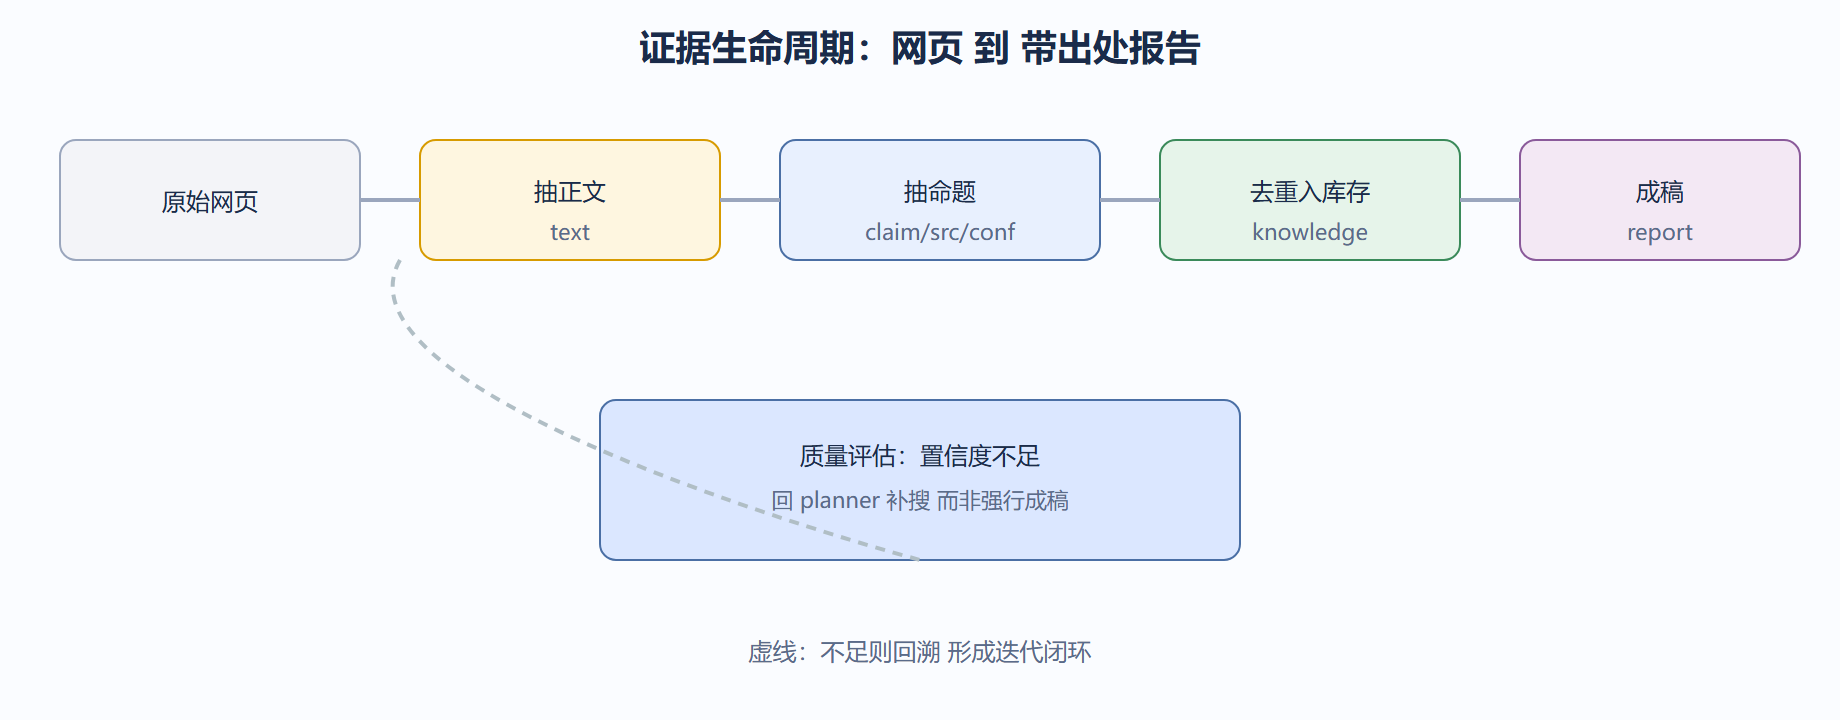
下面用代码实现这条链的最小版,重点看字段如何随步骤变化。每一行都在制造或消费结构化字段:
# 证据生命周期最小实现:观察字段随步骤变化 def extract_proposition(raw_page: dict) -> dict: # 从正文抽命题:主张 + 证据 + 置信度 + 来源 return {"claim": raw_page["text"][:20], "evidence": raw_page["text"], "conf": 0.7, "src": raw_page["url"]} def dedupe(store: list, prop: dict) -> list: # 按来源去重,避免重复证据占带宽 if any(p["src"] == prop["src"] for p in store): return store return store + [prop] def synthesize(store: list) -> dict: # 综合:置信度取平均,来源汇总 avg = sum(p["conf"] for p in store) / len(store) if store else 0 return {"report": "综合结论", "conf": round(avg, 2), "sources": [p["src"] for p in store]} # 运行示例 pages = [{"text": "A公司产能翻倍", "url": "s1"}, {"text": "B厂扩产", "url": "s2"}, {"text": "A公司产能翻倍", "url": "s1"}] store = [] for p in pages: store = dedupe(store, extract_proposition(p)) print("去重后条数:", len(store)) # 2(s1 重复被去掉) print(synthesize(store)) # 平均置信 0.7 来源 [s1, s2]
运行输出 去重后条数: 2 与综合字典。注意第三步重复的 s1 被 dedupe 拦掉——若不去重,报告会夸大"s1 说了两次"的权重。字段化让"去重、加权、溯源"都变成可计算操作,这正是数据流的工程意义。
我们主张:工作机制的本质是"字段驱动的状态机"。每一步只读上一步产出的字段、写下一步要的字段,模块间就天然解耦。反过来,若某步只吐文本不产字段,下游就只能用大模型硬猜,错误会累积且无法回溯。第三章的算法,其实就是在这个状态机上决定"何时转移、何时回溯"。
完整案例:背景→操作→结果→解读→变式
- 背景:某报告出现同一来源被引用七次、显得"多源一致",实则是抓取重复。
- 操作:在
dedupe阶段按(src, claim)联合去重,并统计每源被引次数。 - 结果:报告来源数从"看起来 12 个"还原为真实 5 个,并在脚注标"其中 3 处来自同一源"。
- 解读:数据流漏掉去重字段,下游综合就被假多样性骗了。字段化是诚信的第一道闸。
- 变式:若任务鼓励"同源多证",可改去重键为
claim仅,保留同源不同表述,但必须显式标注来源集中度。
第二章到此收口:定位(2.1)、模块(2.2)、工具(2.3)、数据流(2.4)已齐。进第三章,我们看状态机上的"转移与回溯"到底怎么算。
状态机上的转移与回溯:何时该回头补搜
2.4 说工作机制是"字段驱动的状态机"。状态怎么转移、何时回溯,是这一节的算法核心。一个可操作的规则:综合层算出的"整体置信度"低于阈值(如 0.6)时,不急着成稿,而是回 planner 补一个子任务,专攻置信最低的那条命题。这把 3.2 的迭代细化落到数据流的字段上——回头的触发条件不再是拍脑袋,而是置信度这个可算的字段。
下面演示带回溯的状态机:每轮综合后检查置信度,不够就生成补搜任务并回到检索态:
# 证据状态机:置信度不足则回溯补搜 def research_loop(pages: list, threshold=0.6): store = [] for p in pages: store = dedupe(store, extract_proposition(p)) conf = synthesize(store)["conf"] if conf < threshold: return {"state": "backtrack", "action": "补搜低置信方向", "conf": conf} return {"state": "draft", "conf": conf} # 复用 2.4 的 dedupe/extract_proposition/synthesize(此处简写) def extract_proposition(p): return {"claim": p["text"][:6], "conf": 0.5, "src": p["url"]} def dedupe(s, p): return s if any(x["src"] == p["src"] for x in s) else s + [p] def synthesize(s): return {"conf": sum(x["conf"] for x in s)/max(len(s),1)} # 运行示例:两页都只 0.5 置信 print(research_loop([{"text":"A产能","url":"s1"},{"text":"B扩产","url":"s2"}])) # {'state': 'backtrack', 'action': '补搜低置信方向', 'conf': 0.5}
运行输出 backtrack,因为平均置信 0.5 低于 0.6 阈值。注意回溯不是推倒重来,而是带着已有 store 回到检索态——这正是数据流"字段化"的好处:之前抽好的命题不丢,只补缺口。
| 字段 | 产生环节 | 消费环节 | 作用 |
|---|---|---|---|
| claim | 抽取 | 综合/验证 | 论证单元 |
| conf | 抽取/综合 | 回溯判定 | 触发回头 |
| src | 抽取 | 去重/溯源 | 可审计 |
| cites | 抓取 | 三角验证 | 破回声 |
💡 关键直觉:回溯触发条件一旦可计算(置信度字段),"研究得够不够"就从主观感受变成工程阈值。你可以把 0.6 调到 0.75 让系统更较真,也能按 5.3 场景降门槛换速度——阈值即旋钮,这就是字段驱动的力量。
⚠️ 常见坑:回溯没有上限,系统可能"补搜→仍不足→再补搜"无限循环,token 和时延爆掉。务必给回溯设最大轮次(如 3 轮),超限仍不足就转人工闸门并诚实标"证据不足"。这呼应 5.2 的早停阈值配置。