第三章:核心技术原理与算法
前面两章建立了心智模型和零件清单,这一章钻进齿轮里。为什么在真实互联网上做强化学习能训出"规划、反思、交叉验证"这些行为?一个模糊问题怎么被递归拆成子任务树?零散网页怎么变成可信报告?这些不是魔法,是一组可以被讲明白的算法选择。我们主张:看懂算法,你才配谈"调参"——否则只是在凭手感拧旋钮。
可考核知识点
- 能写出分层奖励塑形的形式:最终奖励加若干里程碑辅助奖励,并说清每个里程碑对应什么行为。
- 能解释"诚实性奖励"如何用负向信号抑制编造。
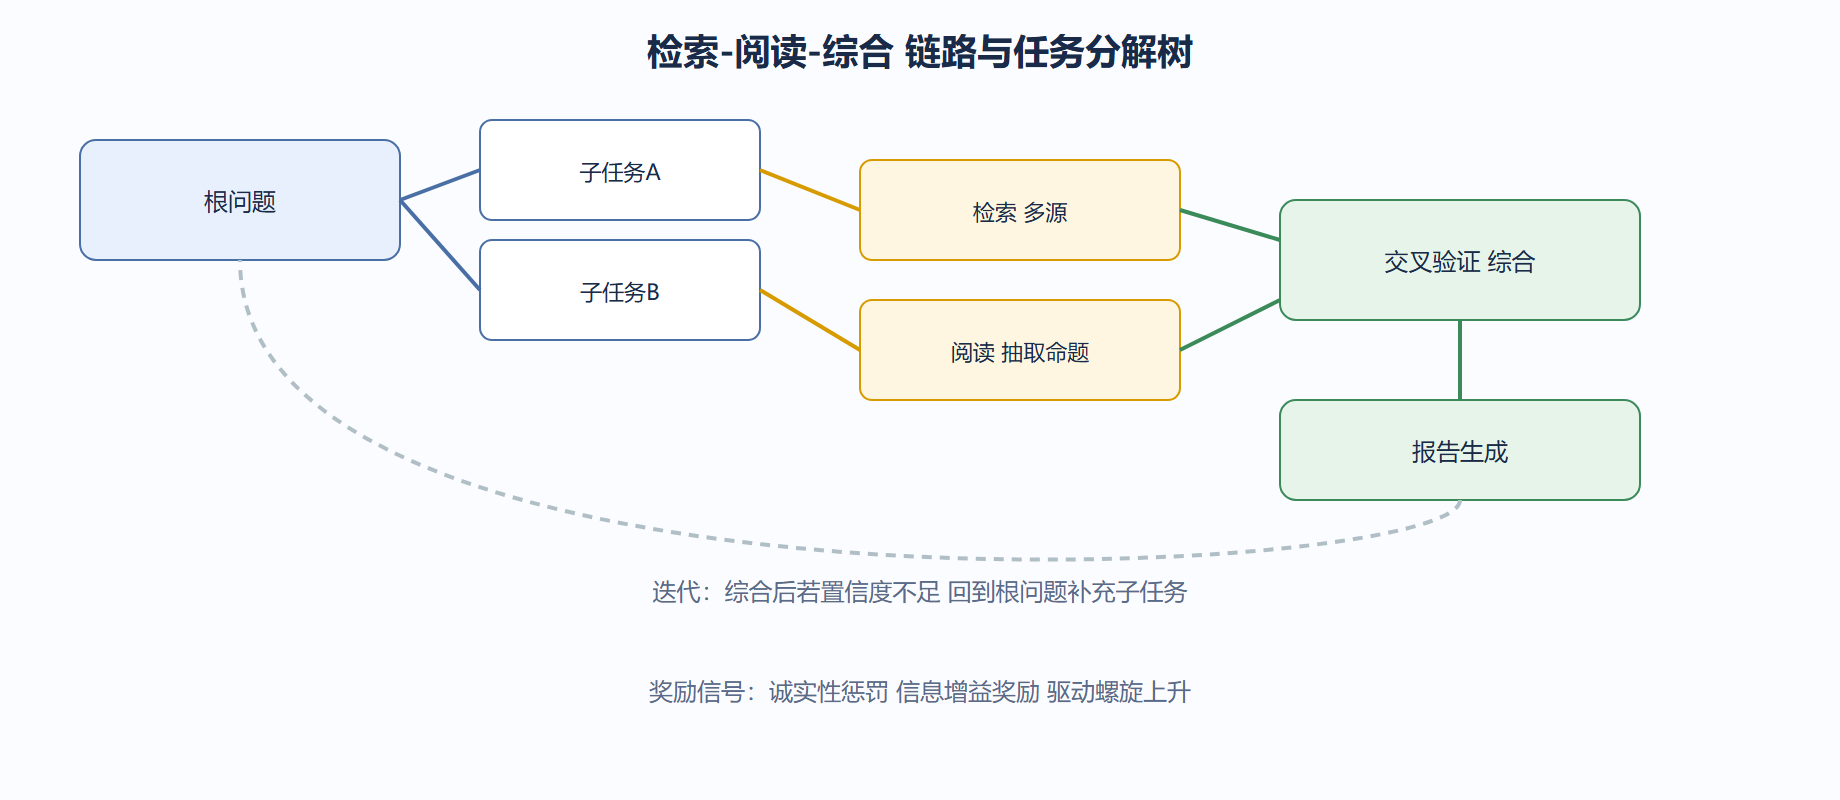
- 能描述任务分解图(子任务为点、依赖为边)及其优化目标。
- 能说明迭代式研究循环为何用贝叶斯更新建模,而非固定步数。
- 能讲出信息检索阶段的"来源可信度"与"交叉验证"具体怎么做。
各节分工
| 节 | 解决的问题 | 读完你会 |
|---|---|---|
| 3.1 强化学习 | 真实环境训练难在哪、奖励怎么给 | 设计最小奖励函数 |
| 3.2 任务分解 | 模糊问题怎么拆 | 画出子任务树 |
| 3.3 检索验证 | 信息怎么取、真假怎么辨 | 实现去重与三角验证 |
| 3.4 知识合成 | 碎片怎么成稿 | 写报告生成流水线 |
| 3.5 模型集成 | 大模型在什么位置出力 | 选模型与上下文策略 |
我们这一章代码密度明显上升。建议每个算法先读"它解决什么工程麻烦",再看代码,最后自己改一个参数观察行为变化。先决条件是第二章的模块职责已经清楚。读完进第四章,那里给这些能力一把尺子,避免你"觉得它变强了"这种无法复现的感觉。
为什么必须有这一章(再展开)
第三章钻进齿轮,把"自主行为"落成可算的算法。没有它,第一章的理念只是主张、第二章的模块只是空壳——你知其然不知其所以然,调参全凭手感。这一章让"看懂算法才配谈调参"从口号变常识。
读完这一章你能拿走的具象能力:
- 能写出分层奖励塑形形式,并说清每里程碑对应什么行为。
- 能实现最小任务分解器(贪心/预算封顶)与迭代细化。
- 能实现三角验证与查询进化,区分独立印证与回声。
- 能写报告生成流水线,矛盾不强行统一、存疑明说。
各节分工(补产出列):
| 节 | 解决的问题 | 读完你会 | 产出 |
|---|---|---|---|
| 3.1 强化学习 | 真实环境怎么训 | 设计最小奖励 | 训练骨架 |
| 3.2 任务分解 | 模糊问题怎么拆 | 画子任务树 | 拓扑执行序 |
| 3.3 检索验证 | 真假怎么辨 | 实现三角验证 | 来源评分器 |
| 3.4 知识合成 | 碎片怎么成稿 | 写报告流水线 | 结构化报告 |
| 3.5 模型集成 | 模型在哪出力 | 选模型分档 | 上下文选择器 |
本章常见误区:以为模型越大算法越灵(实则奖励与架构更关键);把最终奖权重设过高掩盖过程;把"来源计数"当"独立印证"。
与邻章边界:第三章讲"算法怎么算",不讲"能力怎么量"(第四章)也不讲"怎么部署"(第五章)。若你开始想"这算法到底研究得好不好",那是第四章的尺子该出场了。
本章速查清单
读完第三章,应能勾选:□ 写得出分层奖励形式;□ 实现最小分解与拓扑序;□ 实现三角验证与来源评分;□ 写结构化报告且矛盾不统一。四勾全满,算法已能落地成代码,可进第四章量能力。少一项,回去补,否则调参是盲拧旋钮。
读这一章的两个提醒
第一,别跳着读。3.1 奖励、3.2 分解、3.3 检索、3.4 合成、3.5 集成是顺序依赖的:看不懂 3.1 的奖励,就不知道 3.2 分解评估用的"信息增益"为何要奖励;看不懂 3.3 的验证,就不知道 3.4 综合的"证据等级"从哪来。建议连读,遇到公式回看上一节的对应代码。
第二,代码要自己跑一遍。本章每段代码都是最小可跑骨架,改一个参数(如 gamma、预算、阈值)观察行为变化,比只读说明理解深十倍。这也是 3.5 说的"模型选型看位置"——你亲手改一次权重,就知道奖励比模型影响大。
| 想理解 | 先读 | 再看 |
|---|---|---|
| 综合为何标等级 | 3.3 验证 | 3.4 合成 |
| 分解为何迭代 | 2.4 数据流 | 3.2 分解 |
| 模型为何分档 | 3.2-3.4 出力点 | 3.5 集成 |