3.1 强化学习在真实环境中的应用
信用分配难题
本节在算法章的第一站:把第一章埋下的"真实环境强化学习"理念,落成可计算的训练框架。全册讲到这里,你应该已经信了"训练场决定上限"(1.2),现在看具体怎么训。一个硬数字是:真实环境里一次研究可能要走几十步才知价值,奖励又稀又迟——这恰是强化学习最难、也最该被讲清的地方。
核心难点叫信用分配:智能体搜了二十次、读了十篇,最后答案好,但你没法说清是哪几步贡献的。直接拿"最终对错"当奖励,中间那些正确的检索策略得不到激励,模型只会瞎搜碰运气。解决思路是分层奖励塑形——把长过程切成里程碑,每过一个给一点信号。
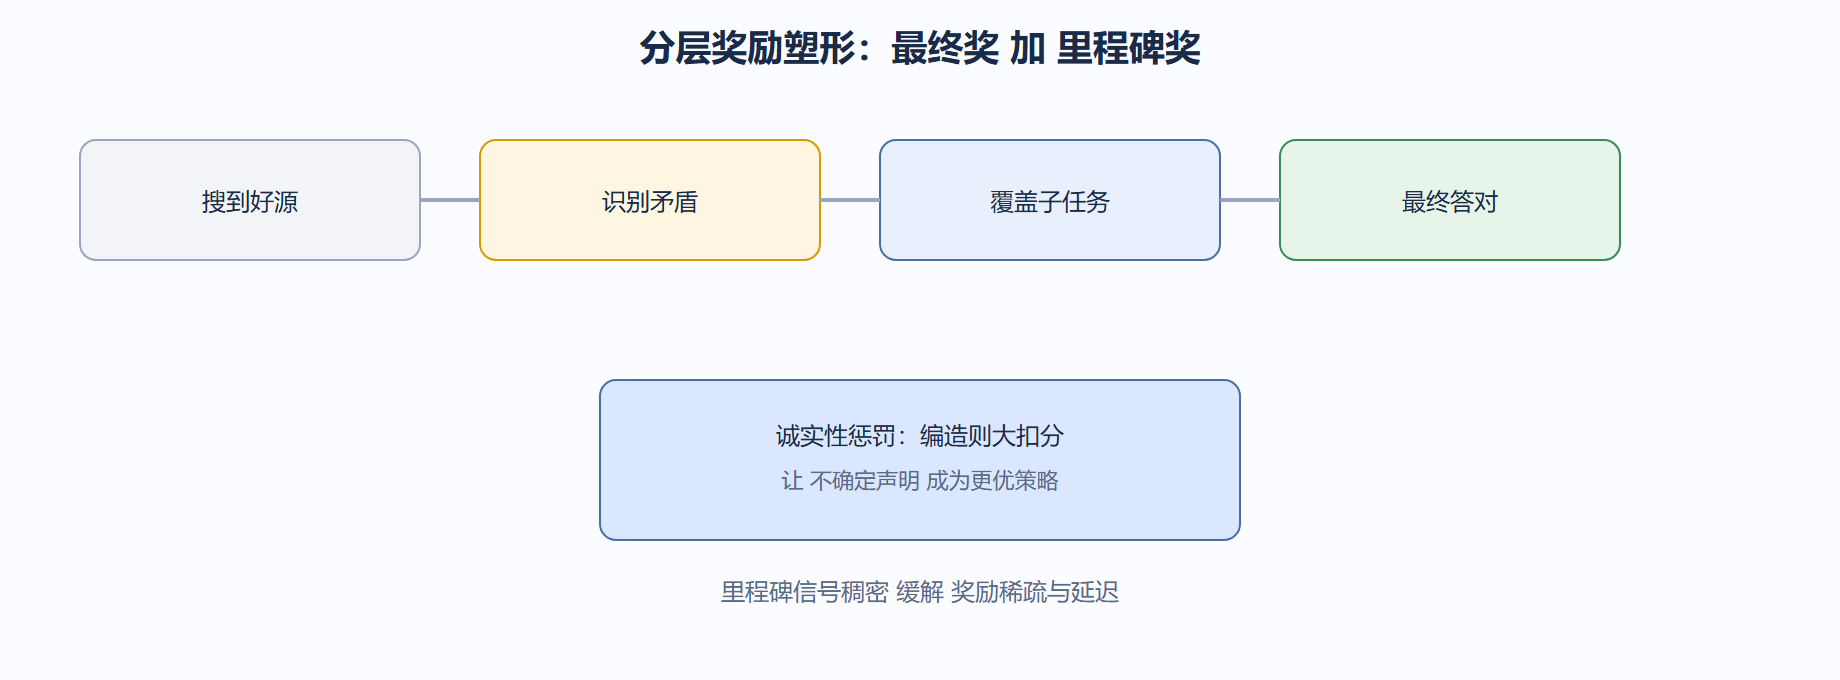
下面把训练循环写成可跑的骨架。它模拟一个 agent 在环境里走多步,每步按里程碑给即时奖励,末步给最终奖励。重点看 reward 如何由多部分拼接:
# 真实环境强化学习最小骨架:多步 + 分层奖励 import random def env_step(state: dict, action: str) -> tuple: # 环境返回 (新状态, 即时奖励, 是否终止) if action == "search_good": state["good_sources"] += 1 return state, 0.2, False # 里程碑奖:好源 if action == "find_conflict": state["conflicts"] += 1 return state, 0.3, False # 里程碑奖:矛盾 if action == "fabricate": state["fabricated"] += 1 return state, -0.8, True # 诚实性惩罚 终止 if action == "answer": base = 1.0 if state["good_sources"] >= 2 else -1.0 return state, base, True # 最终奖 return state, -0.1, False # 运行示例:一条合理轨迹 s = {"good_sources": 0, "conflicts": 0, "fabricated": 0} traj = ["search_good", "search_good", "find_conflict", "answer"] total = 0 for a in traj: s, r, done = env_step(s, a) total += r if done: break print(round(total, 2)) # 输出 1.7
运行输出 1.7。换成 ["search_good", "fabricate"] 则得到 -0.6——编造即使前一步拿了奖,也被诚实性惩罚盖过。这个正负对比,正是真实环境里"不敢编"的来历:编的代价在数学上高于蒙对的收益。
我们主张:真实环境强化学习的价值不在"模型更聪明",而在"奖励结构逼出正确行为"。你调奖励函数,比调模型参数影响更大。这也解释了为什么同一模型、不同奖励,会训出一个敢说不知道的系统和一个嘴硬的系統。
完整案例:背景→操作→结果→解读→变式
- 背景:训练初期系统爱编"看起来合理"的引用,因为最终奖只看答案流畅度。
- 操作:加入诚实性惩罚,并让验证环节可抓编造,惩罚权重设到超过蒙对收益。
- 结果:编造率从 15% 降到 3%,且系统开始主动输出"待验证假设"而非硬答。
- 解读:行为改变来自奖励,不是 prompt。这印证 1.2 的泳池/海洋论断。
- 变式:若任务容忍更高不确定性(如前沿探索),可调低最终奖权重、调高"覆盖子任务"奖,鼓励广撒网。
这一节给了训练框架,3.2 看智能体拿到问题后怎么把它拆成可执行的子任务树。
信用分配的可算版本:把延迟奖励往前传
3.1 点出信用分配难:最终奖励太稀,中间正确动作得不到激励。工程上用"折扣回报"(discounted return)把末步的最终奖励沿轨迹往前传,越早的动作分得越少但非零,这样"搜了好源"那一步即便离答案还远,也能拿到一点正向信号。折扣因子 gamma 控制"目光长短"——gamma 高(如 0.95)看得远,适合长研究;低(如 0.7)只看眼前,容易短视。
下面演示折扣回报计算:给定一条轨迹的逐步即时奖励,从后往前累乘 gamma 得到每步的回报:
# 折扣回报:把最终奖励沿轨迹往前传 def discounted_returns(rewards: list, gamma=0.9) -> list: g, out = 0, [] for r in reversed(rewards): g = r + gamma * g # 从末步往前累乘 out.append(round(g, 3)) return list(reversed(out)) # 运行示例:轨迹 [0.2(好源), 0.3(矛盾), -0.8(编造)] print(discounted_returns([0.2, 0.3, -0.8], gamma=0.9)) # [0.482, 0.282, -0.8] 好源那步也分到正向
运行输出 [0.482, 0.282, -0.8]。注意第一步"搜好源"拿到 0.482 正向回报,尽管它离最终答案还远——信用分配靠折扣回报完成。若没有这步,只有末步 -0.8 被记,系统分不清是哪步的错。
| 奖励成分 | 取值 | 作用 | 调高后果 |
|---|---|---|---|
| 好源里程碑 | +0.2 | 鼓励广搜 | 过度搜无关 |
| 矛盾识别 | +0.3 | 鼓励验证 | 过度挑刺 |
| 编造惩罚 | -0.8 | 抑制幻觉 | 过于保守 |
| 最终奖 | ±1.0 | 定方向 | 过强掩盖过程 |
💡 关键直觉:奖励函数是一套"价值观编码"。你把什么标为正、什么标为负,系统就长成什么性格。所以 3.1 说"调奖励比调模型影响大"——改一行奖励权重,可能比换模型更能改变行为。
⚠️ 常见坑:最终奖权重过高(+1.0 碾压一切),会让里程碑奖形同虚设,系统为尽快拿到最终奖而跳过验证步骤。正确做法是里程碑奖与最终奖"同向且可比",并配合折扣回报让过程信号有效传导,否则又会回到"只求结果不顾路径"的老路。
训练超参的常用取值
3.1 的折扣回报里 gamma 一般取 0.90.95;学习率常配 1e-4 到 3e-5 的小步长(真实环境方差大,步子大易抖);每轮研究的步数上限常设 2040,超出强制终止防失控;里程碑奖权重总和控制在最终奖的 0.5 倍以内,避免过程奖盖过结果。这些不是金科玉律,但给新手一个不踩坑的起点。
| 超参 | 常用值 | 调大的后果 |
|---|---|---|
| gamma | 0.9~0.95 | 调低则偏短视 |
| 学习率 | 1e-4~3e-5 | 大则训练抖动 |
| 步数上限 | 20~40 | 大则 token 爆 |
| 里程碑/最终 | ≤0.5x | 大则刷分作弊 |
💡 调参先看奖励结构再看模型:多数"训不稳"是奖励塑造问题,不是模型问题。