第六章:性能优化与故障排查
第六章:性能优化与故障排查
本章要回答的三个问题
-
转换慢到底慢在哪个环节
-
有哪些立竿见影的提速手段
-
出问题时从哪几处日志下手
为什么单独设这一章
前面把功能讲全了,但跑得动和跑得快是两回事。大表一上,性能问题必然来。这一章把瓶颈定位和优化手段系统化,是老手与新人的分水岭。
读完能解决什么
读完后你能用监控定位瓶颈步骤、套用一批优化手段把吞吐提上去,并在出错时沿着日志快速还原现场。
各节分工
| 节 | 关注点 | 交付能力 |
|---|---|---|
| 6.1 | 瓶颈分析 | 定位慢点 |
| 6.2 | 优化策略 | 提速手段 |
先决条件
需要第三章转换和第四章作业基础,最好有一个真实的大表转换可以压测。
往下走到哪
性能打底后,第七章集群能把单机优化再乘上节点数,规模问题才算真正解决。
本章常见误区
误区一:遇到慢就无脑加并行副本。有状态步骤(如排序、分组、去重)并行会出错或结果错乱,并行只适合无状态、可独立分片的数据流。
误区二:把本该下推到数据库的过滤、聚合写进 Kettle 内存步骤。数据库在存储层做这些远快于把全量拉到内存再算。
误区三:不先定位瓶颈类型就乱调。CPU 型、IO 型、内存型瓶颈解法完全不同,盲目加内存反而触发 GC 抖动。
与邻章边界
第六章给提速手段,但「哪些步骤该下推 SQL」的设计在第三章,「哪些连接会拖慢整体」在第五章,「集群横向扩展」在第七章。性能是系统工程,单点优化有上限。
速查清单
- 瓶颈定位:看步骤「读行/写行/速度」指标,区分 CPU/IO/内存型
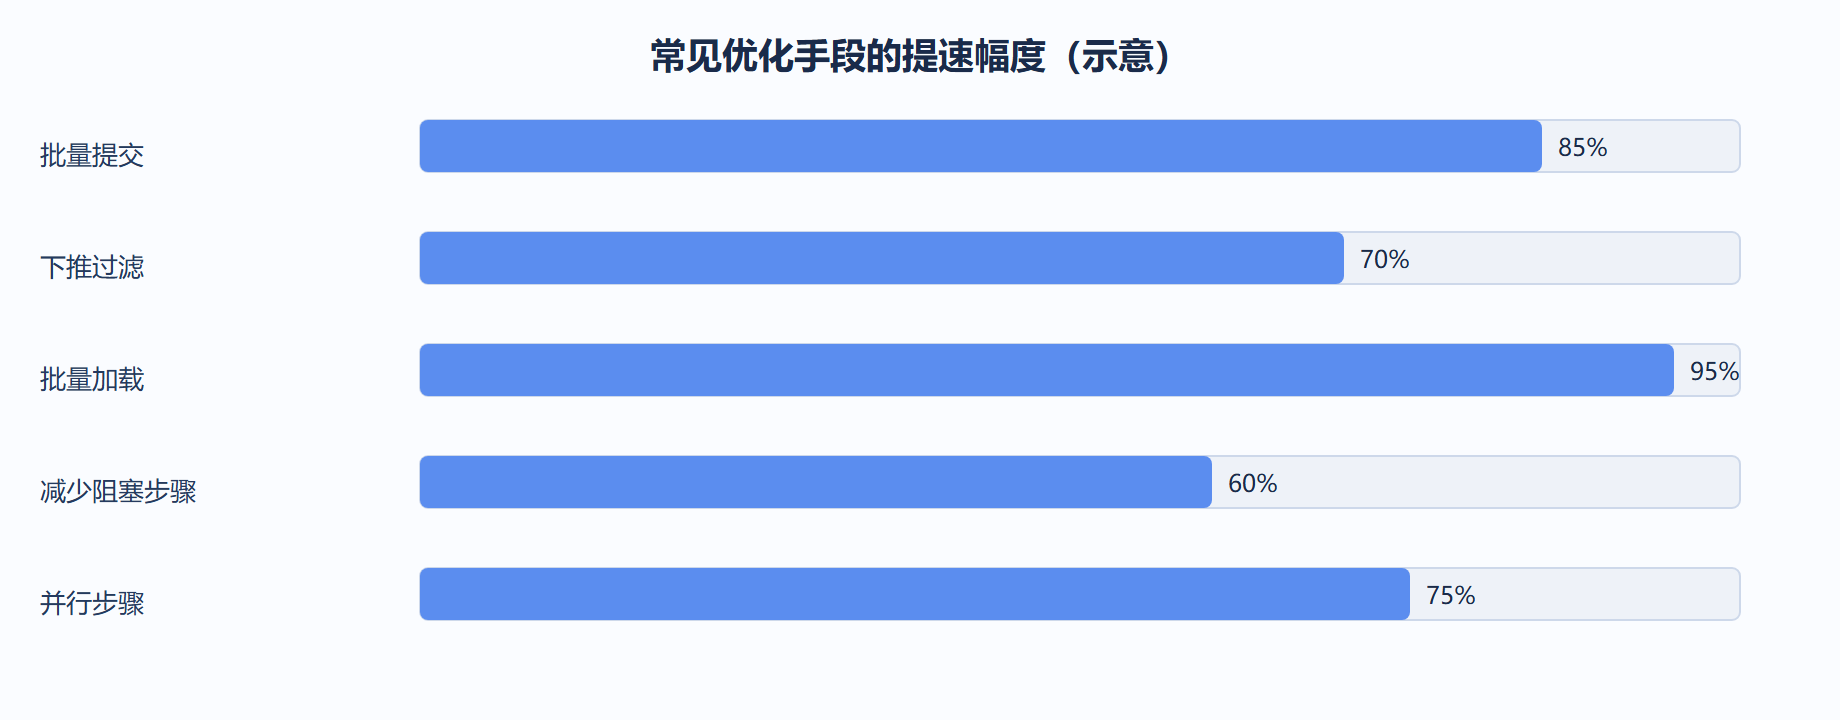
- 下推:过滤、聚合、排序尽量下推 SQL
- 批量:表输出开批量提交、关索引与约束后再建
- 内存:调 JVM 堆、用行集缓冲、避免一次性加载全表
- 日志:把性能日志导出做前后对比,量化优化效果
本章能产出的能力
读完你能用步骤级指标判断瓶颈属于哪一类,并套用一批按性价比排序的提速手段:先下推 SQL,再开批量,最后才动集群与内存。你还会养成「改前量基线、改后量收益」的习惯,让优化不再靠蒙。
为什么这一章不能跳过
性能问题不会因为你「感觉该快了」就消失。我们见过一条转换跑三小时,根因只是没把聚合下推 SQL——下推之后三分钟搞定。不懂瓶颈定位,优化就是蒙眼开枪。本章给你一套按性价比排序的手段,让提速可量化。
本章最小上手练习
挑一条你已有的慢转换,导出步骤性能日志,标出读/写行数与速度最低的步骤;尝试把其中一个过滤或聚合改成源端 SQL,再导一次日志对比。前后两次数对比,就是一次完整的性能诊疗。
自测:你真的懂了吗
- 能否用步骤指标判断瓶颈是 CPU/IO/内存型
- 能否背出提速手段的性价比顺序
- 能否解释为什么「改前量基线、改后量收益」是铁律
本章在你项目里的落点
落地第一件事:挑一条你最慢的转换,导出步骤性能日志,标出最慢步骤,先尝试把它的过滤或聚合下推成源端 SQL——这一招在多数项目里就能解决大半性能问题。第二件事:给表输出开批量提交、关索引后再建。这两步零架构改动、收益却最高,是性能优化的「先手棋」,不要一上来就堆机器。
一页交付清单
本章读完后,你应能在团队里独立承担这些事:
- 用步骤性能日志定位瓶颈属于 CPU / IO / 内存哪一类;
- 把过滤、聚合、排序下推到源端 SQL,而非在内存硬算;
- 给表输出开批量提交并合理管理索引;
- 在动手加机器前,先量化「改前基线 vs 改后收益」。
这四件事构成性能优化的标准动作,顺序固定、不可颠倒。