6.2 性能优化策略
6.2 性能优化策略
定位之后,这几招最常用
本篇是第 6 章第 2 节,也是性能章收尾,给出可落地的优化手段清单,按性价比排序。
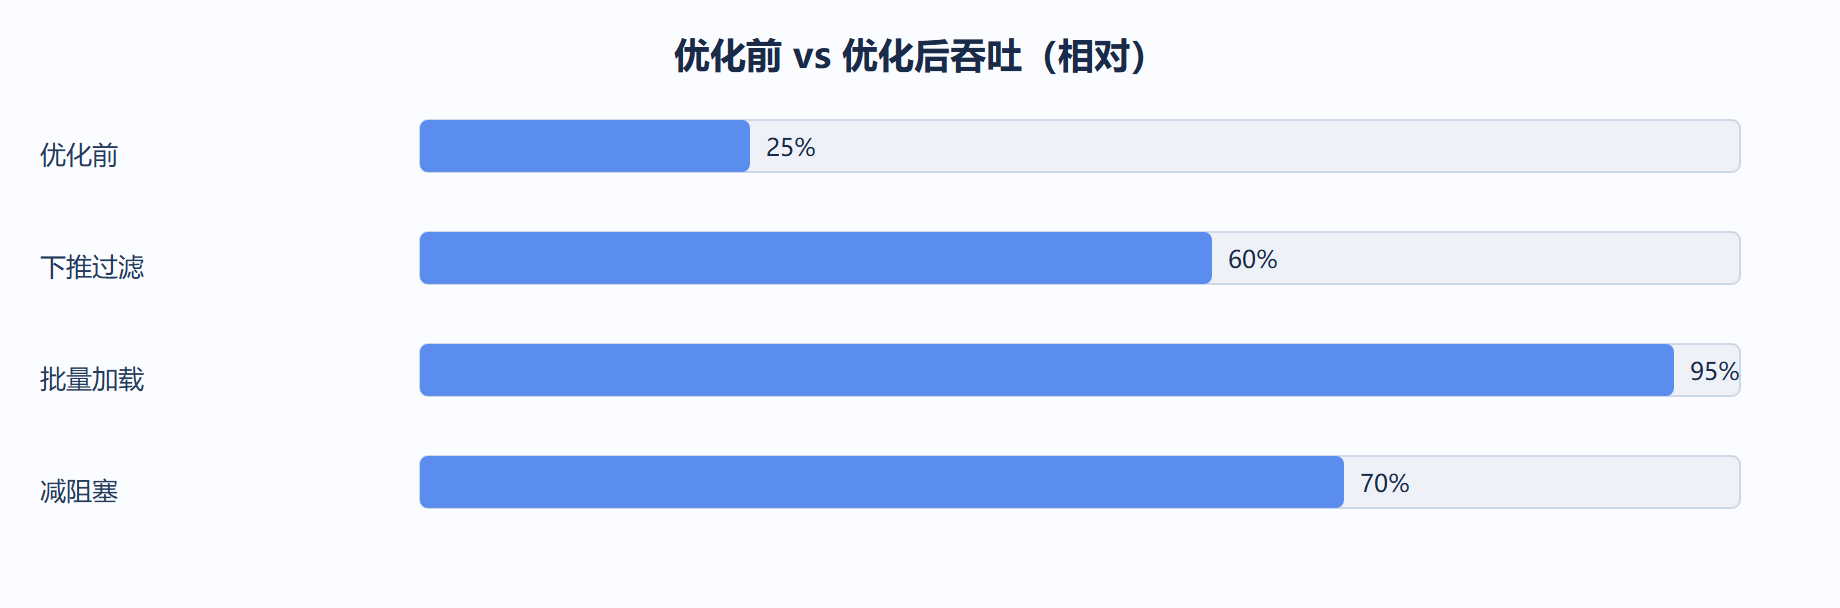
第一招:下推过滤与投影。把 WHERE、需要的列交给源库做,Kettle 少搬数据。我们禁止 SELECT * 进转换,这一招对 IO 型瓶颈几乎总是第一有效。
第二招:批量。表输出开批量+合理 commit(1000~5000),大装载改批量加载(LOAD/COPY),速度可差一个数量级。这是我们在 6.1 案例里验证过的,commit 太小提交频繁、太大锁久,要测拐点。
第三招:减少阻塞步骤。排序、分组、去重会断流水,能下推库端就在库端做;实在要 Kettle 内做,就靠后放并单独给足内存。我们把「排序」能换成「数据库查询」有序读的就换掉。
第四招:并行步骤。无依赖的步骤可设并行复制(如按关键字分片,多份副本各处理一段)。但这会增加行集与内存,要配合 6.1 的水位监控,避免并行反成负担。我们只在明确 CPU 瓶颈且内存充裕时开。
第五招:调 JVM 堆与行集大小。给 Pan 足够堆,行集上限调高让上下游更顺;但堆过大引发 GC 停顿反而慢,我们按数据体积阶梯配置,并监控 GC 日志。优化是系统工程,单点改未必全局快。
关键代码与配置
下面这段 xml 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
<step><name>表输出</name><type>TableOutput</type> <commit>3000</commit><use_batch>Y</use_batch> </step> <!-- 大装载改用批量加载步骤,绕开逐行插入 --> <step><name>装载</name><type>MySQLBulkLoader</type> <table>dwd_orders</table><field>id,amount,created_at</field> </step>
小增量走批量表输出、大装载走批量加载器,是写端的提速双选。我们按数据量切换,commit 值固定压测得出。
# 小转换 export PENTAHO_DI_JAVA_OPTIONS="-Xmx2g" # 大转换 export PENTAHO_DI_JAVA_OPTIONS="-Xmx8g -XX:+UseG1GC" pan.sh /file:huge.ktr
堆不是越大越好,过大 GC 停顿反伤吞吐。我们按体积分档,并开 G1 降低停顿。
背景
一个转换在 Kettle 内对千万行排序再做关联,单步耗时 25 分钟,整条作业超时。
操作
把排序和关联下推到仓库 SQL(建好索引的有序表),Kettle 改为直接读有序结果。
-- 库端完成排序+关联,Kettle 只搬运结果 SELECT o.id, c.name FROM src_orders o JOIN dim_customer c ON o.cid=c.id ORDER BY o.created_at;
结果
排序步骤消失,单步从 25 分降到 2 分,整条作业稳稳在窗口内完成。
解读
根因是阻塞步骤断流又吃内存。下推到擅长集算的引擎后,Kettle 回归搬运本职,吞吐自然上来。
变式
若必须 Kettle 内排序,可改「排序+分组」为按关键字分片并行排序再归并,但要评估复杂度,通常不如下推划算。
常见误区与工程取舍
误区:并行一定快。无依赖才并行,且要监控行集水位。
误区:堆越大越好。过大 GC 停顿反伤,按体积分档。
取舍:优化按性价比——下推 > 批量 > 减阻塞 > 并行 > 调堆。
深入:提速手段的性价比排序
我们按性价比给提速手段排个序:第一,下推 SQL(过滤、聚合、排序尽量在库内),零成本高收益;第二,开批量提交与关索引后重建,写库提速明显;第三,调 JVM 堆与行集缓冲,缓解内存瓶颈;第四,才考虑集群横向扩展。绝大多数「慢」在前两步就解决了,直接上集群往往是过度设计。还要养成习惯:每次改动都量一遍基线,用数据证明有效,而不是「感觉快了」。
<step> <name>表输出</name> <type>TableOutput</type> <use_batch>Y</use_batch> <commit_size>20000</commit_size> <!-- 批量提交,写库提速关键 --> <batch_size>20000</batch_size> </step> <!-- 配合目标表先 drop 索引、装载完再 create,整体可快数倍(输入:清洗行集;输出:目标表) -->
⚠️ 常见坑(优化策略)
- 直接上集群:忽略下推与批量,成本翻倍收益甚微。
- 盲目加内存:内存型瓶颈不对症,反引 GC 抖动。
- 不改前量基线:无法证明优化有效,容易「负优化」。
💡 关键直觉
- 优化有顺序:下推 > 批量 > 内存 > 集群,前面的便宜且往往够用。
- 性能是工程不是玄学:每次改动前后都导出指标对比,量化才可信。
| 手段 | 成本 | 收益 |
|---|---|---|
| 下推 SQL | 极低 | 高 |
| 批量提交 | 低 | 高 |
| 调内存 | 中 | 中 |
| 集群 | 高 | 视情况 |
工程实录:批量提交提速写库
表输出逐行提交,大表写到天亮。
开批量提交,目标表先 drop 索引装载完再建。
<step><name>表输出</name><type>TableOutput</type> <use_batch>Y</use_batch><commit_size>20000</commit_size> </step>
整体快数倍,且事务可控。
下推 > 批量 > 内存 > 集群,顺序别乱。
每次改动导出指标对比,量化收益防负优化。
参数与阈值速查
| 手段 | 成本 | 收益 |
|---|---|---|
| 下推 | 极低 | 高 |
| 批量 | 低 | 高 |
| 集群 | 高 | 视情况 |
现场口诀
性能优化记住顺序:下推 > 批量 > 内存 > 集群。前两步零成本且往往够用,盲目上集群既贵又常无效。每次改动都量一次基线,用数据证明提速,别靠「感觉快了」——感觉是最不可靠的优化指标。