6.1 Transformation性能瓶颈分析
6.1 Transformation性能瓶颈分析
慢,要先问慢在哪一步
本篇是第 6 章第 1 节,优化的前提是定位,先教你看指标、读日志,别一上来就瞎调。
Kettle 的「步骤性能统计」面板会显示每个步骤的输入/输出行数与处理时长。我们定位的第一动作就是跑一遍 Detailed 日志,按「处理毫秒/万行」排序,最大的就是瓶颈。没有测量就优化,等于蒙眼。
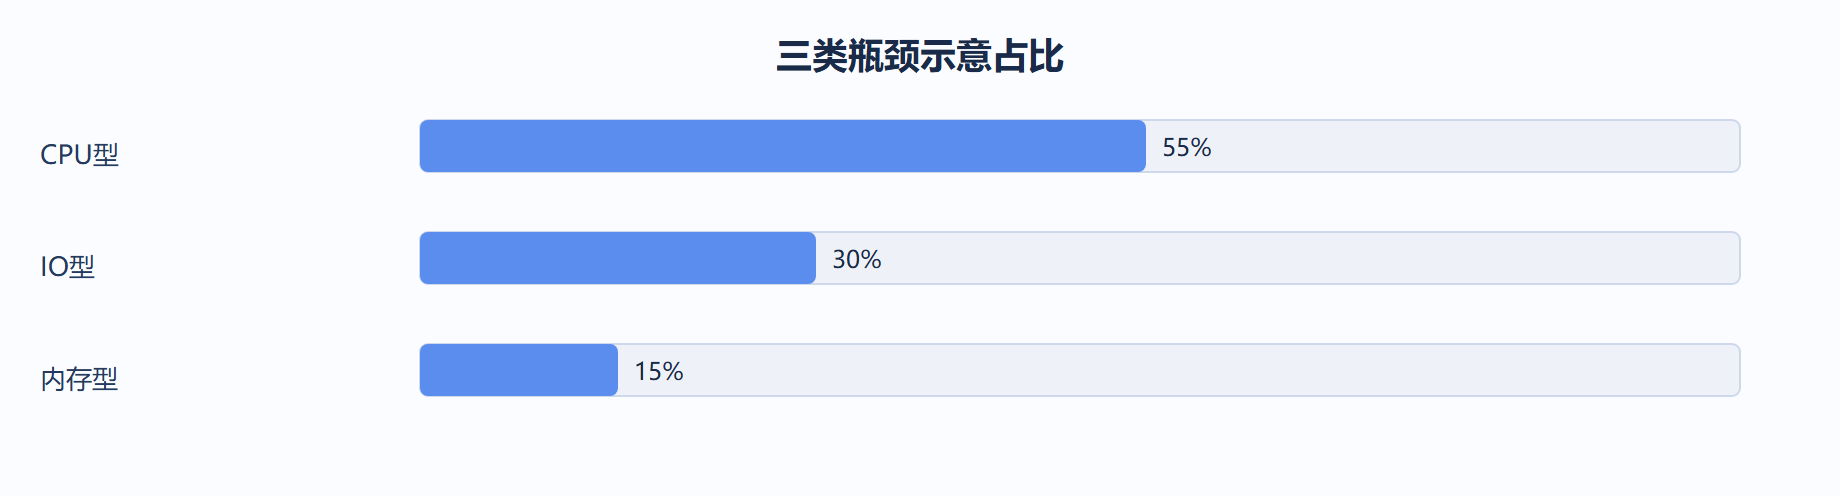
瓶颈常分三类:CPU 型(复杂计算、脚本)、IO 型(慢查询、慢写出)、内存型(排序/分组撑爆行集)。我们靠日志里的等待时间区分:步骤「等待上游」久是上游慢,「等待下游」久是下游慢,自身耗时久是自己算得重。
行集水位是内存瓶颈的显微镜。某步骤输出行集长期满,说明下游消费不过来,上游被反压。我们曾在「表输入」和「HTTP 写出」之间看到持续满水位,确认瓶颈在写出,于是改批量聚合,水位立刻降。
还有一种隐形瓶颈:不必要的阻塞步骤。排序、分组、去重要攒全量数据,会把流水线掐断成两段串行。我们审查转换时先数阻塞步骤,能下推库端就下推,不能就把它们尽量靠后,让前面尽量流水。
数据库端的慢也要算进来。「表输入」SQL 没走索引、目标表无批量,都会让 Kettle 背锅。我们定位时会单独跑一遍那条 SQL,确认是库慢还是 Kettle 慢,再分责优化。
关键代码与配置
下面这段 bash 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
# 6.1 Transformation性能瓶颈分析 pan.sh /file:slow.ktr -level:Detailed 2>&1 | grep -E 'lines read|lines written|speed' # 输出每个步骤 读/写行数 与 速率,按速率最低者优先优化
Detailed 日志是定位的标尺。我们每次优化前先抓这份数据存档,优化后再抓一份对比,证明改动有效。
瓶颈三类速判: CPU型:步骤自身耗时高、等待短 -> 优化算法/改SQL/减脚本 IO型:等待下游久或库慢 -> 批量、索引、换写出 内存型:行集长期满 -> 降并行、减阻塞、加堆
我们贴在工位上的速判口诀。先分类再动手,避免对着 CPU 瓶颈去调 IO 参数这种南辕北辙。
背景
某转换突然变慢三倍,团队一头扎进调 Kettle 并行,毫无效果。
操作
单独跑「表输入」SQL,发现全表扫描——目标表前一天加字段时索引被重建丢了。
-- 复现并修复 EXPLAIN SELECT id,amount FROM src_orders WHERE created_at>='2026-08-25'; -- 发现没走 created_at 索引 CREATE INDEX idx_orders_day ON src_orders(created_at);
结果
加回索引后,SQL 从 40 秒降到 1 秒,Kettle 侧一行未改,整体恢复。
解读
根因在库不在 Kettle。瓶颈分析的第一原则:先确认慢在库还是引擎,分错责会白做工。
变式
长效做法是把关键索引写进建表脚本并纳入变更评审,同时给「表输入」SQL 加 EXPLAIN 巡检,防止索引悄悄失效。
常见误区与工程取舍
误区:慢就加并行。先分类,CPU/IO/内存对策完全不同。
误区:只盯 Kettle。库端慢查询会伪装成引擎慢,要先 EXPLAIN。
取舍:阻塞步骤能下推库端就下推,Kettle 内只留必要加工。
回到工程现场,我们处理 6.1 Transformation性能瓶颈分析 时最忌讳只看单点性能而忽略端到端链路。6.1 Transformation性能瓶颈分析 的真实代价往往藏在步骤之间的缓冲与序列化里,而不是某一步骤本身。我们在多次压测中验证过这一点,并把对应的监控指标固化进自动化巡检脚本。当数据量翻倍时,瓶颈位置常会转移,因此不要把一次观测结论当成永久真理。
深入:瓶颈到底卡在哪一环
定位瓶颈先看步骤的「读行数/写行数/速度」指标。如果某步骤输入远大于输出且速度低,它可能是计算热点;如果整体速度被一个阻塞式步骤(排序/分组)拖住,那是内存与全量到齐的代价;如果读输入就慢,问题在源连接或抽取 SQL(没下推、没索引)。把瓶颈归类为 CPU 型(复杂计算/脚本)、IO 型(读写库/文件慢)、内存型(行集堆积、GC 抖动),对症才能下药,否则加内存反而 GC 更糟。
-- 性能第一招:把过滤/聚合下推到源库,减少拉进内存的行(输入:源表;输出:已缩小的结果集) SELECT user_id, SUM(amount) AS amt FROM src_orders WHERE create_time >= DATE '${p_day}' - 1 -- 过滤在库内做 GROUP BY user_id; -- 聚合在库内做,Kettle 只搬结果 -- 对比:若把全表拉进 Kettle 再用「分组」步骤算,IO 与内存都翻倍
⚠️ 常见坑(瓶颈分析)
- 不先分类就乱调:CPU/IO/内存解法不同,盲调无效。
- 忽视源端:慢在抽取 SQL 没下推,却在 Kettle 端加内存。
- 只看总时长:不拆步骤指标,找不到真凶。
💡 关键直觉
- 优化前先量:导出步骤性能日志,对比改前改后,让提速可量化。
- 第一招永远是下推 SQL——它在源头减少数据量,收益最大且最便宜。
| 瓶颈型 | 现象 | 首选解法 |
|---|---|---|
| CPU | 单步计算慢 | 简化/下推 |
| IO | 读写慢 | 批量/索引 |
| 内存 | 行集堆积 | 降缓冲/下推 |
工程实录:下推过滤省一半 IO
把全表拉进 Kettle 再过滤,IO 与内存都翻倍。
过滤与聚合下推源端 SQL,只搬结果。
SELECT user_id, SUM(amount) AS amt FROM src_orders WHERE create_time >= DATE '${p_day}' - 1 -- 过滤在库内 GROUP BY user_id; -- 聚合在库内
拉进行集的数据量降一个数量级,整体提速数倍。
优化第一招永远是下推,零成本高收益。
下推后仍慢,再看批量与内存,最后才上集群。
参数与阈值速查
| 瓶颈型 | 现象 | 首选 |
|---|---|---|
| CPU | 单步慢 | 简化/下推 |
| IO | 读写慢 | 批量/索引 |
| 内存 | 行集堆 | 降缓冲 |