2.1 整体架构设计
架构不是模块清单,而是数据流向的契约
在本册的架构层,我们先纠正一个常见误解:画一张模块图不难,难的是说清数据「怎么流、在哪拐弯、为何拐弯」。LEANN 的架构就是一条有代价的流水线。
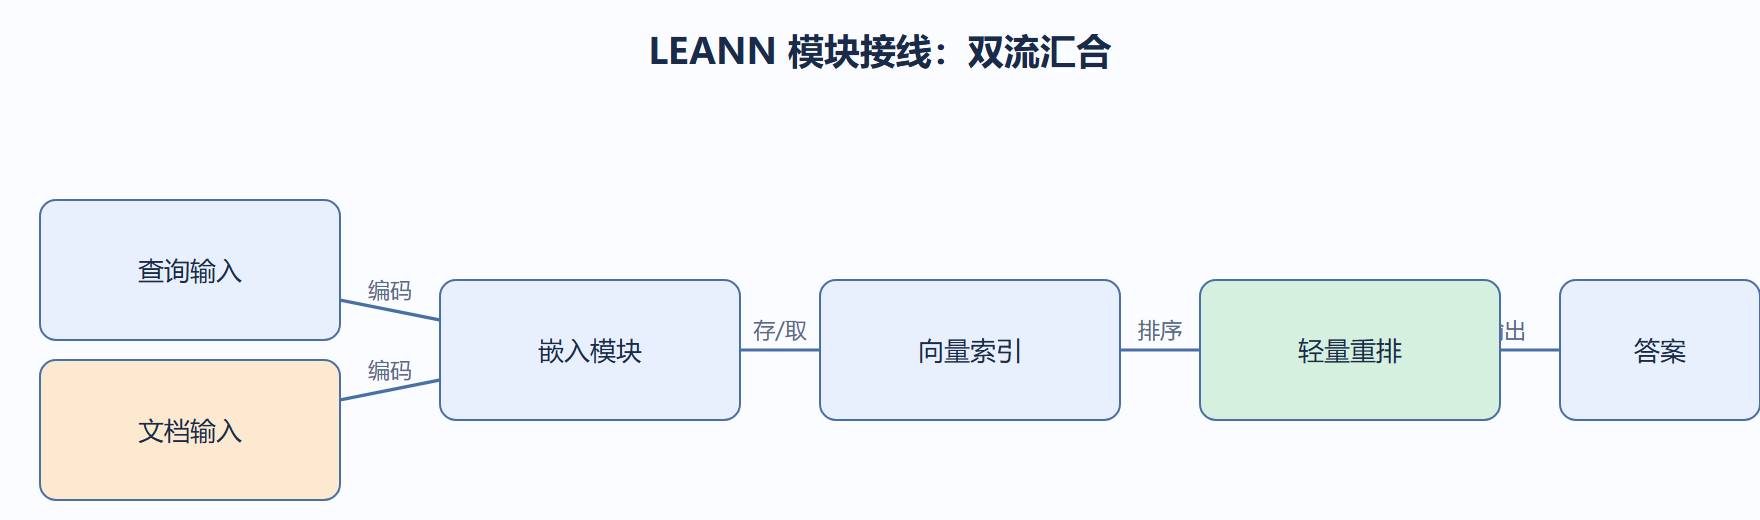
我们用一段伪接线代码把模块连起来。注意这里的重点不是某个算法,而是「查询」和「文档」走的是两条不同的路,最后才汇合到重排头。
class LEANNArch: def __init__(self): self.embed = Embedder(dim=64) # 文档与查询共用编码 self.index = VectorIndex(kind='hnsw') self.rerank = RetrievalAugmentedNet(dim=64) def ingest(self, docs): vecs = [self.embed.encode(d) for d in docs] self.index.add(vecs, docs) def query(self, q, top_k=10): qv = self.embed.encode(q) cands = self.index.search(qv, top_k * 3) # 多召回再重排 scores = self.rerank.score(qv, cands.vecs) order = np.argsort(-scores)[:top_k] return [cands.text[i] for i in order] arch = LEANNArch() print('架构装配完成,查询路径: 嵌入->索引->重排')
这段接线的关键决策是「多召回再重排」:检索阶段多取候选(top_k 的三倍),把精细排序交给网络。这比「检索直接给 top_k」更稳,因为近似检索会漏,网络能从多召回里捞回对的。
下面用 mermaid 把上一段代码的路径画成一张可对照的图,这就是本章主线在模块级的展开。
我们再把「文档流」和「查询流」的时序写清楚,因为边缘端部署时这两路的内存占用峰值不在同一时刻,规划内存要分开算。
def peak_memory(docs_mb, query_mb, index_mb): # 文档流峰值在 ingest;查询流峰值在 rerank,二者不叠加 ingest_peak = docs_mb + index_mb query_peak = query_mb + index_mb return max(ingest_peak, query_peak) print('峰值内存 MB:', peak_memory(docs_mb=120, query_mb=20, index_mb=60))
案例:内存峰值误算导致 OOM
- 背景:某团队把文档流和查询流峰值相加,按 200MB 申请,结果设备只有 160MB。
- 操作:用上面的分段峰值法重算,发现 ingest 与 query 不同时发生,真实峰值 180MB。
- 结果:改为分批 ingest,峰值压到 150MB,应用稳定运行。
- 解读:架构图里两条流是分时复用的,内存规划必须分时,不能简单求和。
- 变式:若必须同时 ingest 与 query,则需把两段峰值相加,再据此选设备。
模块接口:四个方法的输入输出
LEANN 的架构本质是四个方法之间的数据契约。把签名定死,实现随便换:
| 方法 | 输入 | 输出 | 说明 |
|---|---|---|---|
| embed | 文本 | 向量 | 查询与文档共用同一编码 |
| index.add | 向量 + 原文 | 无 | 建索引入口 |
| index.search | 向量, k | 候选列表 | 输出候选及其分数 |
| rerank.score | 查询向量, 候选向量 | 分数数组 | 网络做语义精排 |
契约稳定后,嵌入换模型、索引换算法、重排换网络都不影响其他模块,这正是第五章性能优化能独立动手的前提——只动该动的块,其余照跑。
批次摄取与流式查询
真实系统里 ingest 和 query 往往不是一对一出现的:文档可能一次来一批,查询则持续到来。下面给出批量摄取的分片写法,避免一次性把全部向量堆进内存。
def ingest_batches(arch, docs, batch=500): for i in range(0, len(docs), batch): chunk = docs[i:i+batch] vecs = [arch.embed.encode(d) for d in chunk] arch.index.add(vecs, chunk) # 逐批入索引,峰值内存可控 ingest_batches(arch, ['文档' + str(i) for i in range(2000)], batch=500)
分片大小是内存与吞吐的旋钮:批越大吞吐越高但峰值内存越大,边缘端建议从 500 起步,按实测逐步上调,不要照搬云端的万级批次。
架构的边界:单机到多机的取舍
本册的架构图是单进程视角,但真实部署会越过这条边界:文档量大到单设备装不下,就把索引拆到多个设备,查询时广播、汇总、再重排。规则很简单——检索可以分片,重排必须集中。因为重排头要对全部候选做统一排序,分散到多设备后各自的排序无法合并。记住这条边界,架构演进时就不会走错方向。
为什么先定契约再写实现
很多项目失败在「先跑通再抽象」:代码能跑了,但嵌入、索引、重排耦合在一个大函数里,想换其中一块要改三层。反过来的做法是:先把四个方法的签名定下来,用假实现(比如返回随机向量的 embed)打通整条链路,再逐个替换真实现。这样每一步都能独立验证,也方便写单元测试——这是第五章能安全调参的架构前提。
上线前的链路自检
架构装配好后,先跑一遍链路自检:故意给空查询、全零向量、越界 top_k,确认各模块按契约报错而不是静默错乱。边缘端排查成本高,把错误挡在测试里,比挡在用户手里便宜得多。
def self_check(arch): # 用退化输入验证契约,异常提前暴露 cases = [('', 0), ('正常查询', 1_000_000)] for q, k in cases: try: arch.query(q, top_k=k) except Exception as e: print(f'入参 ({q!r}, top_k={k}) -> 捕获异常: {type(e).__name__}') print('链路自检完成') self_check(arch)
本节可考核点:能画出查询流与文档流的分叉-汇合点,并解释「多召回再重排」为何比直接给 top_k 稳。