5.1 组装生产线:HCLG 解码图的构建工艺
5.1 组装生产线:HCLG 解码图的构建工艺
本节摘要:解码图把语言模型、发音词典、上下文规则、声学拓扑四张转换器自右向左组合成一张统一的搜索地图,是三块知识源的物理接口。本节讲清四张图的职责、组合顺序、消歧符号的用途、规模来源与瘦身手段,给出构建与验收命令。承接第 4 章的训练产物,是出炉的第一道工序。
总装车间里的四张图纸
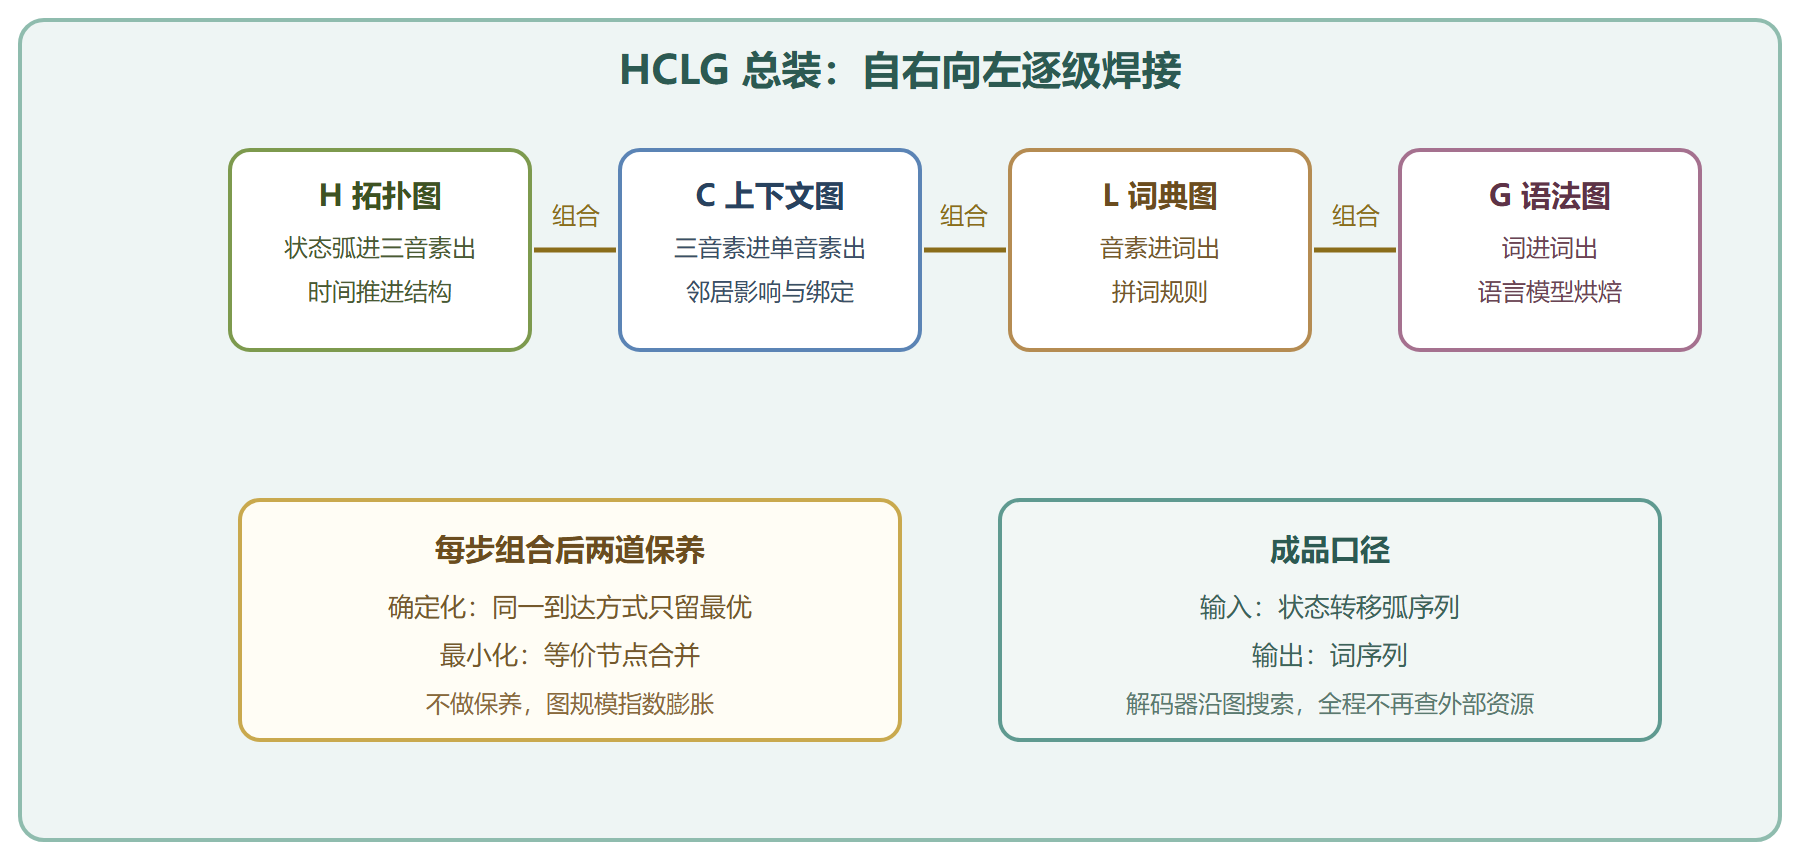
解码图的名字就是四张图纸的缩写:H、C、L、G。G 是语法图,由语言模型转来,输入输出都是词,管"词序像不像人话";L 是词典图,输入音素、输出词,管"音素怎么拼成词";C 是上下文图,把单音素展开成三音素并带上决策树的绑定信息,管"音素在邻居影响下怎么变";H 是声学拓扑图,把三音素再展开到隐马尔可夫状态与转移弧,管"状态怎么随时间推进"。组合完成后,输入端是"声学状态序列",输出端是"词序列"——解码器拿到每帧的状态打分,就能沿着这张图走到词。
组合顺序有讲究:先组语言图与词典图(词这一层的接口对齐),再叠加上下文展开,最后焊接声学拓扑。每一步组合后都要做确定化(同一输入只留一条最优到达方式)与最小化(合并等价节点),否则图的规模会失控。成品图动辄几十万节点、几百万条弧,这就是解码器"预编译"的产物——把语言知识与词典知识全部烘焙进图里,解码时不必再查任何外部资源。
# 四张图纸的输入输出对照 图纸 输入符号 输出符号 职责 G 词 词 词序概率 L 音素 词 拼词规则 C 三音素 单音素 上下文展开与绑定 H 状态转移弧 三音素 时间拓扑 # 组合后成品:输入状态转移弧,输出词
图 自右向左的总装顺序
消歧符号:总装时的防呆销钉
组合过程中有个技术暗礁:词典图里不同的词可能有相同的音素序列开头,组合算法需要知道"走到哪里才算确定拼出了一个词"。消歧符号就是为此埋进的特殊标记——在词条之间插入编号符号,让等价路径可区分,总装完成后它们在输入端,解码时无感。你不需要亲手处理它们,但见到语言目录里那几个带编号的特殊音素名,要知道是干这个的。
消歧符号还牵出一个常见误解:有人看到语言目录里两套词典图(一套带消歧一套不带),以为是冗余。其实一套是总装用的原料(带销钉),一套是留给人工检查与对齐工具用的成品视图(不带销钉)。两套图职责不同,删掉任何一套都会让某条工具链断掉。
动手构建与验收
构建由一条命令完成,产物落在实验目录的图子目录:
# 为三音素模型构建解码图(在食谱目录内) utils/mkgraph.sh data/lang exp/tri1 exp/tri1/graph # 参数:语言目录 模型目录 图输出目录 # 预期输出:多阶段日志,末尾打印图的规模统计 # 验收一:看成品 ls exp/tri1/graph # 预期输出(节选): # HCLG.fst disambig_tid.int words.txt num_pdfs # HCLG.fst 是成品,words.txt 是词编号账本
验收二看规模与健康度。转换器信息工具能打印节点数、弧数与连通性:
# 用信息工具体检成品图(示意) fstinfo exp/tri1/graph/HCLG.fst | head -n 8 # 预期输出(节选): # fst type vector # # of states 7xxxx # # of arcs 2xxxxxx # ... # 看点:状态数十万级、弧数千万级属正常量级; # 连通性报错或弧数为零,说明上游某张图纸坏了
规模从哪来?主要来自三处:语言模型的阶数与词表(G 的规模)、词典的音素组合(经 C 展开)、上下文窗口的宽度。瘦身材也就对症下药:小任务用小语言模型或限制词表;把词拆成子词单元压缩词典组合;调整剪枝阈值丢掉低概率弧。图规模与解码速度直接挂钩,在线场景尤其敏感。
从 G 到图:语言模型那头的水龙头
四张图纸里,唯一经常被替换试验的是 G。换一份领域语言模型重建图,其余三张图纸与模型都不动,这是"换语言不换声学"的标准操作。反过来也要清楚:图一旦重建,此前的解码目录全部作废,错误率要重测——图是编译产物,不是运行时可插拔的组件。
G 的选择本身有三个旋钮。词表范围:用全量词表还是按任务词频截取,词表越全图越大;阶数:三到五元是常规范围,阶数高一档,图与语言模型都胖一圈;平滑配比:由语言模型训练工具决定,图构建阶段只是消费者。经验路径是先小后大:小图跑通全流程、确认指标正常,再上大图冲指标,避免"图建了半小时、结果发现词典漏词"的返工。
物理形态上,成品图是二进制转换器文件,规模从几十兆到上吉字节不等,跟随模型目录存放。它只认编号不认文本,所以图目录里总要陪着一份词编号账本——丢了账本,图就是一堆无法解读的字节。多人协作时图目录要跟着模型版本一起归档,光存模型不存图,复原时还要重新踩一遍构建的坑。
总装车间问答
问:图能不能离线建好直接给别人用? 可以,图与模型成对打包交付是常规做法。注意对方的解码器版本要与图的转换器格式兼容,跨大版本交付前先拿几句样例音频验证。
问:为什么我建的图比别人大十倍? 三个最常见原因:语言模型用了全量词表、词典没做子词压缩、语言目录的上下文窗口开宽了。逐项对照检查,通常一项就能解释大半。
问:构建到一半断了要重来吗? 图构建脚本内部有阶段缓存,从中断阶段续跑即可;但若中断发生在组合早期,缓存目录可能不完整,直接清掉输出目录重来一遍更省心。
问:同一份语言资源能配不同模型吗? 语言目录(词典与语法)是模型无关的,换模型只需重跑组合与焊接;但不同模型树的叶子状态数不同,图的输入端随之不同,所以"语言目录共享、图各建各的"才是正确姿势。
⚠️ 常见坑一:模型换代后忘了重建图,解码一启动就报维度不匹配——图与模型必须成对更换。坑二:语言目录与词典目录不是同一套生成的,消歧编号对不上,组合阶段报错且信息晦涩。坑三:图构建到一半磁盘写满,留下半张坏图,后续解码结果全错,构建日志务必看到"成功"字样再往下走。
总装验收单
- 四图各管一段:语法管词序、词典管拼词、上下文管变形、拓扑管时间,组合后一图通吃。
- 顺序与保养不可省:自右向左组合,每步确定化加最小化,否则规模失控。
- 图与模型成对:换模型必换图,图目录跟着模型目录走。
- 规模是解码速度的先手棋:在线任务先掂量图的体量,再谈解码器优化。
生产线装好了,下一节开炉放料:同一张图,离线整批开与在线逐帧开,两种炉法的门道各有一套。