5.2 开炉放料:离线与在线解码的两种炉法
5.2 开炉放料:离线与在线解码的两种炉法
本节摘要:同一张解码图,离线整批开炉追求质量与吞吐,在线流式开炉追求延迟与稳定。本节讲清离线解码的流程与并行调度、在线解码的流式架构与延迟预算、两者的实现差异与选型依据,并给出实时率的测量方法。承接 5.1 的解码图,通往 5.3 的打分评估。
开炉前的最后检查
开炉前照例过一遍检查单:解码图与模型是否同一代产物、测试数据的特征口径是否与训练一致、解码参数(束宽、语言模型权重)是否记录在案。三项都绿,才点火。这份仪式感不是矫情——出炉环节的问题九成能追溯到这三项,开炉前花一分钟,好过开完炉对着满屏错词发呆。
离线炉:整批投料,质量优先
离线解码的形态是"批量作业":整批测试语音提好特征,按份数切给多个并行进程,各自沿着解码图搜索,产出词格文件。质量优先体现在两处:一是可以用更宽的束(算力换准确),二是产出词格而不是单一句子,为 5.4 节的二次加工留足原料。
# 离线解码(在食谱目录内,图已建好) steps/decode.sh --nj 8 --cmd "run.pl" \ --beam 15.0 --lattice-beam 8.0 \ exp/tri1/graph data/my_dev exp/tri1/decode_my_dev # 参数解读: # 并行八份;主束宽十五,词格束宽八 # 解码图 测试数据目录 输出目录 # 预期输出:八份进度走完,输出目录生成词格与日志
并行调度是离线炉的效率引擎。份数取机器核数与内存的较小约束;任务队列器(食谱里的执行器配置)可以换成本地跑、集群跑、显卡队列跑,主脚本一字不改——这是脚本层"调度与计算分离"的设计红利,多人共用服务器时尤其顺手。
在线炉:边进边出,延迟为王
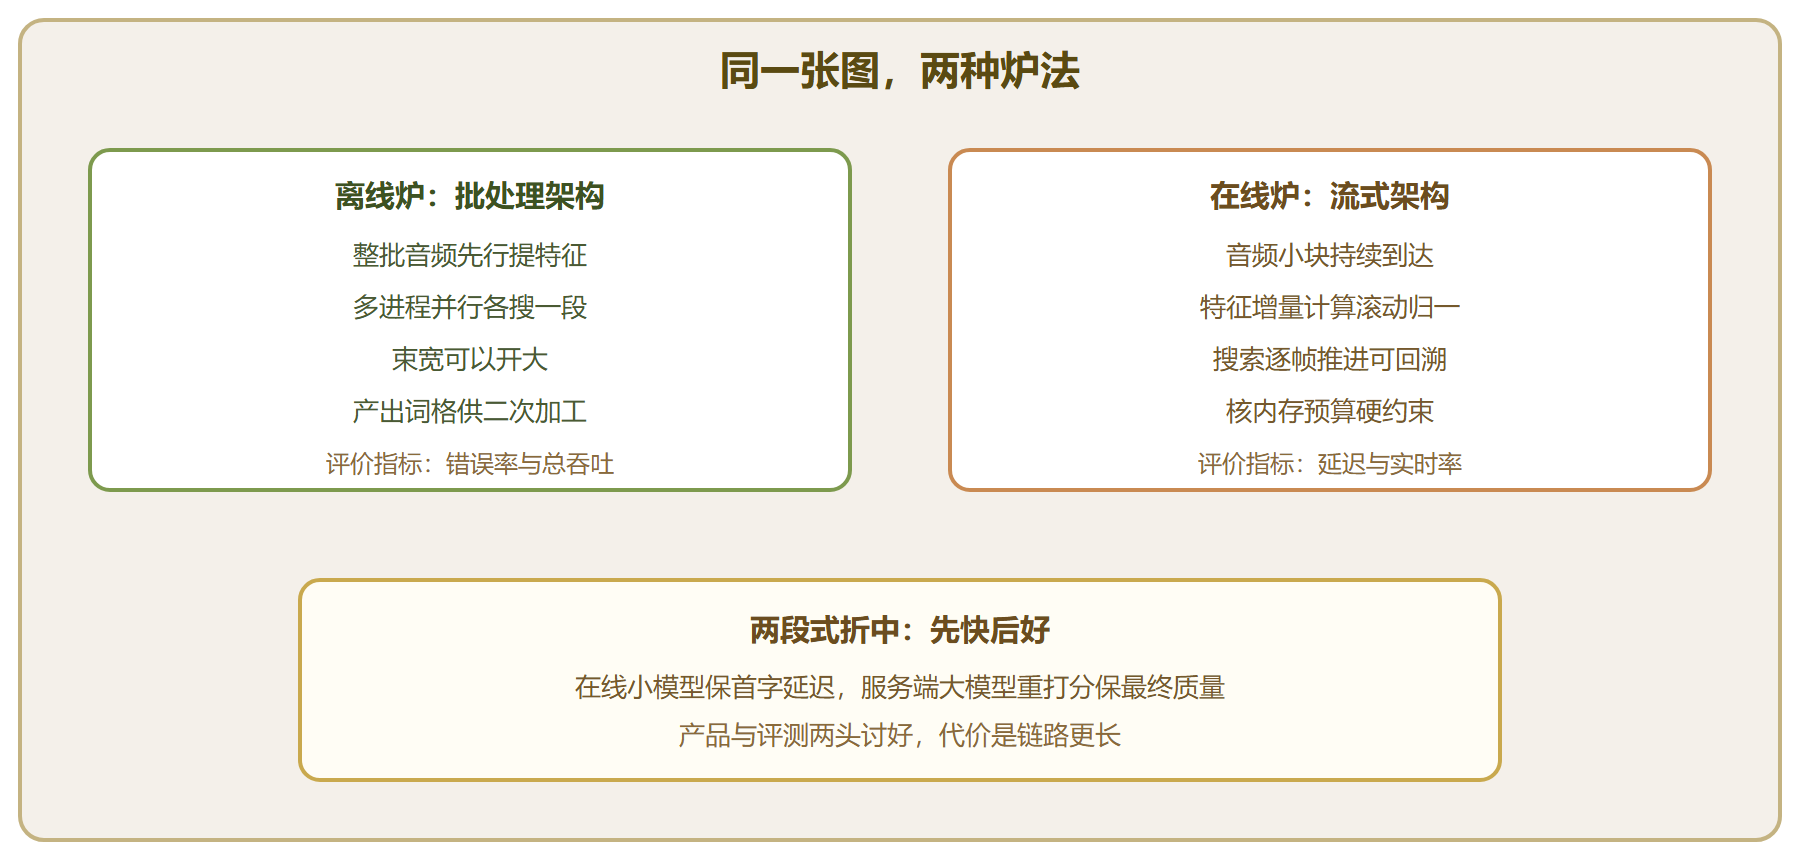
在线解码的产品形态是流式:音频按小块(比如几百毫秒一段)持续到达,解码器增量推进,用户说完半秒内出字。实现上的关键差异有三处。特征要在线算:不能等整句到齐,分帧、归一化都要支持增量模式,说话人归一化退化为"用初始几秒的统计量起步、随后滚动修正"。搜索要可回溯:束搜索逐帧推进,已经吐出的词不轻易反悔,但内部保留少量候选等待后文裁决。资源要预算:解码线程独占一个核、内存有硬上限,实时率必须稳定小于一(处理一秒音频耗时必须少于一秒),否则延迟越滚越大。
# 在线识别示意(流式命令行工具,模型与图换成在线版产物) online2-wav-nnet3-latgen-faster --endpoint=true \ --frame-subsampling-factor=3 \ exp/chain_online/final.mdl exp/chain_online/graph/HCLG.fst \ utterance_id wav_file # 预期输出:随音频推进逐段打印部分结果,末尾给整句与耗时 # LOG 输出:识别文本 + 实时率统计(约零点几)
两类炉法的适用边界一句话可断:评测、实验、批量转写用离线炉;产品、助手、实时字幕用在线炉。工程上常见的"两段式"是折中案:第一段在线小模型快速出初始结果,第二段等服务端更强的模型重打分修正——首字延迟由第一段保证,最终质量由第二段托底。
补一个容易被忽略的对照实验:同一批测试音频,离线与在线各跑一遍,错误率的差值就是"流式化的代价"。这个差值应当被持续监控——它随模型更新、参数改动悄悄变化,某次改动后差值突然拉大,说明改动在流式路径上水土不服。把它做成例行的回归指标,等于给在线链路配了一位专属质检员。
图 双炉对照:批处理与流式的架构差异
实时率:在线炉的生命线
实时率定义为"处理耗时除以音频时长",零点六表示一秒音频零点六秒处理完。测量要连端到端一起算:特征提取、搜索、输出渲染全在内,单测解码器核心会得到虚好看的数字。写个十行的计时脚本,把三类耗时分开记录,瓶颈在哪一目了然。
延迟的另一面是"首字延迟"——从用户开口到屏幕出第一个字的等待。它与整体实时率是两个独立指标:整句实时率达标但首字延迟大,用户体验照样糟糕。压低首字延迟的手段包括缩短第一段模型的出字粒度、对话音端点检测做提前触发。端点检测本身也值得单独认识:它判断"用户说完了没有",误判早了切掉尾音,误判晚了空等半秒,是在线链路里性价比很高的调优点。
解码参数在两种炉法下的侧重也不同。离线炉可以宽束大图慢慢搜;在线炉的参数要为"最坏情况"设防——束宽、活跃路径数、词格深度都按峰值负载设上限,宁可平均质量降一点,不能让长句把延迟拖爆。这份"为最坏情况设计"的思路,是在线工程与离线实验最大的心智差异。
# 端到端实时率测量(示意) start=$(date +%s.%N) for wav in dev_wavs/*.wav; do online2-wav-nnet3-latgen-faster ... "$wav" > /dev/null done end=$(date +%s.%N) audio_secs=$(sox dev_wavs/*.wav -n stat 2>&1 | grep Length | awk '{print $3}') echo "实时率: $(echo "($end - $start) / $audio_secs" | bc -l)" # 预期输出(示例): # 实时率: 0.58 # 解读:小于一达标;留出系统余量,线上峰值才不翻车
⚠️ 常见坑一:离线评测用了在线模型的图,或反之,错误率无故偏高——图、模型、特征三件套必须同源同代。坑二:在线场景只测了安静办公室音频,换到嘈杂环境实时率翻倍(束宽自适应变宽),压测要覆盖真实噪声。坑三:并行度照搬离线经验,在线进程互相抢核,延迟毛刺出现在多用户并发时。
💡 关键直觉:离线与在线的差异,本质是"质量预算"与"延迟预算"的换算。所有在线优化技术,做的都是同一件事——在延迟红线内尽量少丢质量。
开炉记录
- 三件套同源:图、模型、特征口径,换代同步换。
- 调度与计算分离:执行器配置决定在哪跑,主脚本不动。
- 实时率端到端测:只测核心等于没测,线上按峰值预算。
- 两段式是正解之一:延迟与质量分头包干,别指望单炉全赢。
金锭出炉,下一道工序称重打分:词错误率怎么算、报表怎么读、数字背后的病灶怎么定位。