6.4 改造工具:脚本扩展与 C++ 代码定制
6.4 改造工具:脚本扩展与 C++ 代码定制
本节摘要:改造分三级——改食谱脚本是日常、写本地脚本是进阶、动 C++ 内核是重手术。本节给出三级的改造姿势、命令行工具的管道约定、源码目录的地图与新增可执行文件的流程,最后用"加一道静音过滤工序"的完整案例串起来,并给出改与不改的评估清单。
改造你的工具
用别人的矿场,迟早有你自己的工序要加。改造的第一原则是"改动半径最小":能用参数解决的不改脚本,能改脚本的不动内核,能加新文件的不改旧文件。半径越小,将来同步社区更新的成本越低——这在与开源上游共存的工程里是生死线。
脚本扩展有三种姿势,由轻到重。姿势一:不改文件,只传参——绝大多数需求(换语言模型、调参数、加阶段开关起点)在命令行就能解决。姿势二:在食谱目录的主脚本里加一个阶段,插进你自己的工序,沿用阶段开关约定,断点续跑的习惯不被破坏。姿势三:把可复用的工序写成脚本放进本地目录,主脚本只调用它——工序成熟后甚至能被别的食谱借走。
# 姿势三示例:本地目录里的静音比例过滤脚本 # 用途:剔除静音占比过高的录音(常见于无人值守采集) # 输入:数据目录;输出:过滤后的数据目录加一份剔除清单 #!/usr/bin/env bash set -euo pipefail in_dir=$1; out_dir=$2; threshold=${3:-0.8} mkdir -p "$out_dir" # 逐条算静音比例:能量低于阈值的帧占比(示意实现) while read -r utt wav; do ratio=$(compute-silence-ratio "$wav") # 概念性调用 if (( $(echo "$ratio < $threshold" | bc -l) )); then echo "$utt $wav" >> "$out_dir/wav.scp.new" else echo "$utt $ratio" >> "$out_dir/removed.lst" done < "$in_dir/wav.scp" mv "$out_dir/wav.scp.new" "$out_dir/wav.scp" # 其余清单按同一批话语标识过滤后拷贝, # 最后过一遍数据校验脚本再交付
命令行工具的管道约定
内核产出的上百个命令行工具遵循统一的输入输出约定,学会约定,工具就能像积木一样随意拼接。核心是两样:档案与索引——索引是文本清单(每行"键 路径"),档案是二进制数据;工具接受"索引文件或标准输入"作为输入,产出写到"档案或标准输出"。另一个约定是表格式的选项前缀,声明你想读文本还是二进制、读全部还是读一段。掌握了这两条,常见的"取一段特征看看""把模型转成文本检查"都是一行命令的事。
C++ 内核:重手术的流程
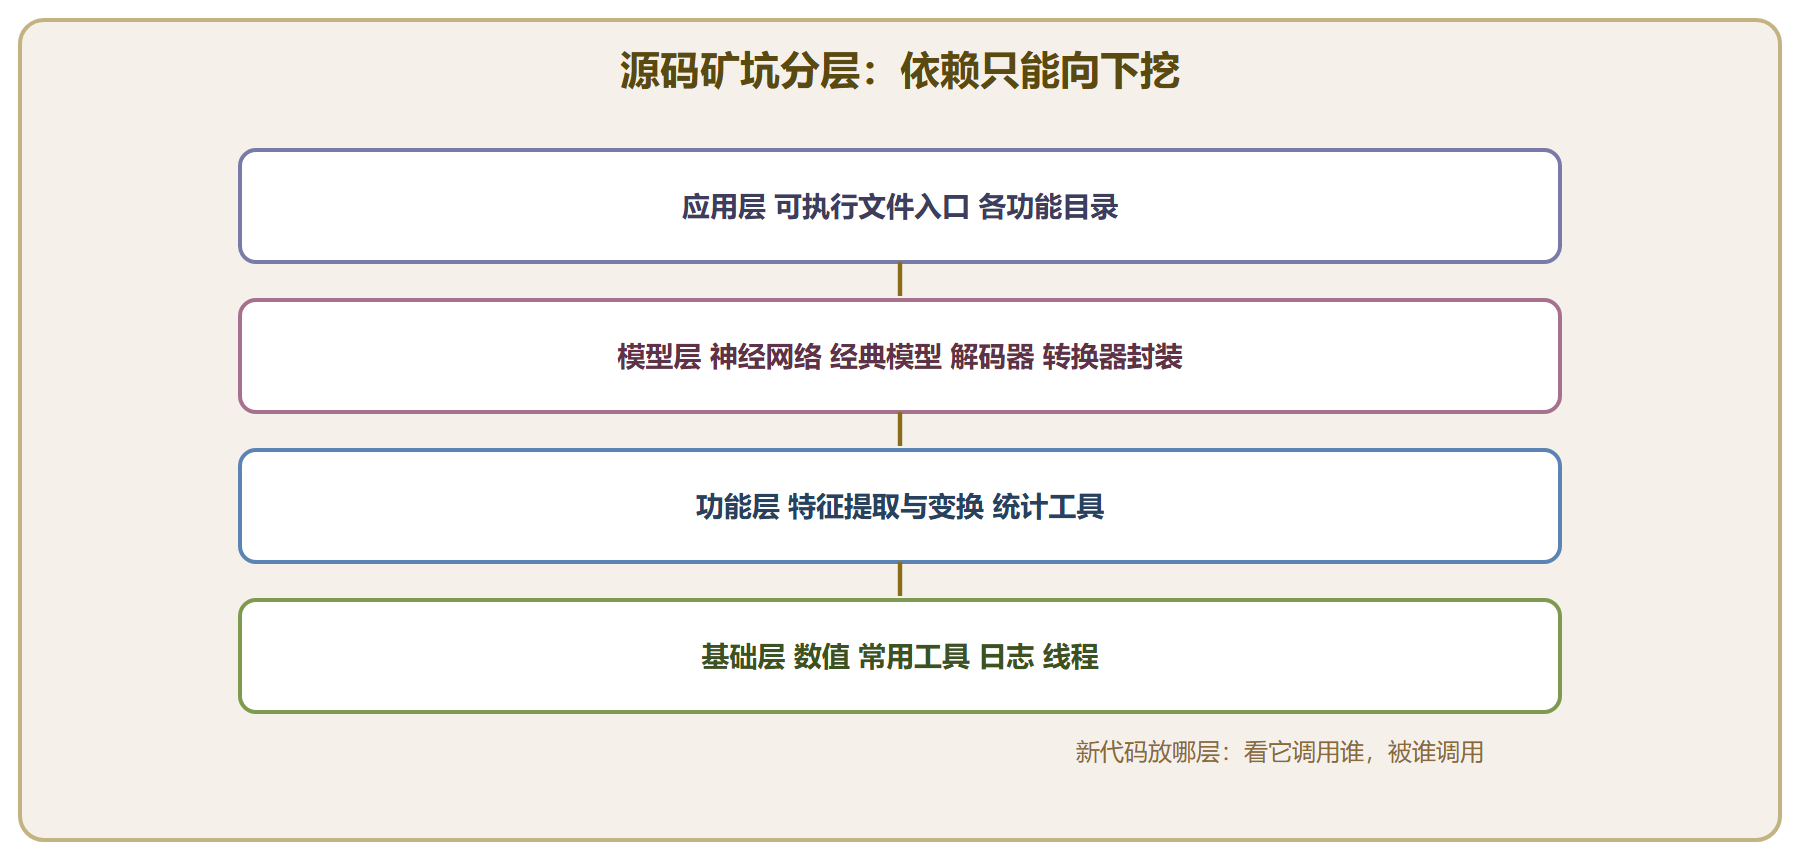
脚本层搞不定的需求(新算法、新目标函数、性能瓶颈在内层循环)才动内核。动之前先看地图:源码区按模块分层,最底层是基础库(数值、日志、线程),往上依次是工具库(档案读写、命令行解析)、特征模块、经典模型模块、神经网络模块、转换器与解码器模块。依赖只能自下而上,你新加的代码该放哪层,看它依赖谁。
图 源码区分层地图与依赖方向
新增一个可执行文件的流程四步走:挑一个功能模块目录放源码文件;在模块的构建清单里登记;写主体函数(命令行解析、读输入、算逻辑、写输出,全按工具库的现成设施来);重编该模块。挑个现成的类似工具照葫芦画瓢,是最快的入门路径——内核里每个可执行文件的主函数都很短,长的逻辑都在库里。
// 新工具骨架:只列结构,逻辑省略(示意) // 主体函数四段式:解析命令行、读输入、算逻辑、写输出 int main(int argc, char *argv[]) { try { using namespace kaldi; const char *usage = "概念示例:读特征算统计写文本\n"; ParseOptions po(usage); // 命令行解析走现成设施 po.Read(argc, argv); if (po.NumArgs() != 2) { po.PrintUsage(); return 1; } std::string feat_rxf = po.GetArg(1); // 输入:特征档案 std::string out_wxf = po.GetArg(2); // 输出:文本报告 // 读输入 → 逐句计算 → 汇总写出(略) KALDI_LOG << "处理完成"; return 0; } catch (const std::exception &e) { KALDI_ERR << e.what(); // 统一错误出口 return 1; } }
# 单模块重编与验证(在源码区) cd ~/kaldi-field/kaldi/src/featbin make -j 4 # 预期输出:只重编受影响的目标,速度远快于全量编译 ls . | grep your-new-tool || echo "未生成,检查构建清单登记"
案例:加一道静音过滤工序
背景:远场录音设备每天产出几万条音频,两成是环境音触发误录的"全静音"或"近全静音",直接进训练会稀释有效数据。操作:按姿势三写本地过滤脚本(上面那份骨架),阈值先定保守的零点八,挂进主脚本数据准备阶段之后、特征提取之前,作为独立阶段可开关。结果:首月剔除清单里九成八确实是静音误录,有效时长占比从七成九升到九成六;后续训练在同一套参数下开发集错误率小幅下降。解读:过滤的价值在"减负"而非"加料"——坏数据稀释的是好参数的证据权重。变式:阈值按采集时段分档(夜间环境音多,阈值收紧),剔除清单每月人工抽查一次防漂移。
⚠️ 常见坑一:直接改通用脚本库里的公共脚本,升级时冲突到无法合并——自定义逻辑永远放本地目录。坑二:新内核代码没走统一的错误出口,崩了不留栈信息,排查全靠猜。坑三:改完模块忘了别的模块还链接旧库,运行时行为不一致,全量重编一次可解。
💡 关键直觉:判断"改脚本还是改内核"只看一条——你的逻辑需要逐帧逐状态的内部数据吗?需要就进内核,不需要就留在脚本层拼积木。九成的定制需求停在脚本层。
工具房清单
- 改动半径最小:参数优于脚本、本地优于公共、新文件优于改旧文件。
- 管道约定是积木接口:索引加档案、表格选项,学会约定就能自由拼装。
- 内核分层看依赖:新代码放哪层,看它调用谁。
- 九成需求停在脚本层:动内核前先自问是否真需要内部数据。
工具齐活了,最后一节交给矿场运营:算力怎么配、任务怎么排、事故怎么查——长跑的功夫全在运营。