6.5 矿场运营:性能调优、并行计算与排障手册
6.5 矿场运营:性能调优、并行计算与排障手册
本节摘要:矿场长跑靠运营:算力怎么配、任务怎么排、日志怎么读、事故怎么查。本节给出算力与调度的配置方法、显卡内存与并行度的换算经验、按工序定位的诊断路径、四类高频事故的速查表与四条预防纪律。全教程的收官一节,把前面各章散落的运维线索拧成一股。
矿场事故记录本
每个老矿工都有一本事故记录本。翻开一页看看:某次链式训练在第八小时崩了,日志只说显存不足,一查发现并行度是照着上一张卡设的,新卡显存小一半;某次全量重跑后错误率涨了两个点,折腾两天才发现是新同事改了特征配置没同步,新旧特征混了目录。事故各有花样,但病因翻来覆去就那几类——记录本的价值是把"惊喜"变成"套路"。
事故本怎么记也有讲究。推荐四栏格式:症状(日志原文截一句)、根因(一句话说透)、处方(具体到命令或参数)、预防(归到四条纪律的哪一条)。第四栏最值钱——它把单次事故折算成流程改进,下次同类问题在萌芽期就被拦住。坚持记一个月你会发现,八成的事故能归到"版本、校验、试跑、对账"四条纪律的缺口上,这比任何教程里的事故列表都更贴合你自己的矿场。
一、算力配置与任务调度
先说算力账。高斯混合训练吃 CPU 与内存,多核并行几乎线性加速,内存按"语料小时数乘每小时的峰值占用"粗估;神经网络训练吃显卡,吞吐由卡数与卡型决定,显存决定单卡能开的模型宽度与批大小。两段训练的算力画像完全不同,采购与排队都要分开规划。
调度层的开关在食谱目录的执行器配置里。同一套主脚本,改两行配置就能从"本机串行"切到"集群排队",这是脚本层调度与计算分离的设计红利:
# 执行器配置的两种形态(在食谱目录内切换) # 形态一:本机并行(调试期) export train_cmd="run.pl" export decode_cmd="run.pl" # 形态二:集群排队(正式跑) export train_cmd="queue.pl --mem 8G --gpu 1" export decode_cmd="queue.pl --mem 4G" # 切换后主脚本一个字不用改; # 并行度由脚本参数另行传入,两处配置各管各的
# 正式跑之前的小样试跑纪律(三分钟省三小时) # 第一步:从训练集切两百分之一做小样 subset_data_dir.sh data/my_train 200 data/tiny_train # 第二步:全流程在小样上过一遍(图、训练各一段、解码、打分) ./run.sh --train-dir data/tiny_train --stage 0 # 预期输出:全流程走通,产物齐全; # 任何环节的小样失败都是全量失败的前兆
显卡并行度有个朴素换算:先按"显存占用约等于批大小乘模型宽度加常数"估单卡上限,再用"样本生成、卡间通信、计算"三段耗时各占三分之一的目标去配生成进程数。并行度不是越大越好——通信开销随卡数上升,八卡之后的边际收益明显变薄,这是常见经验。
二、日志分级与诊断路径
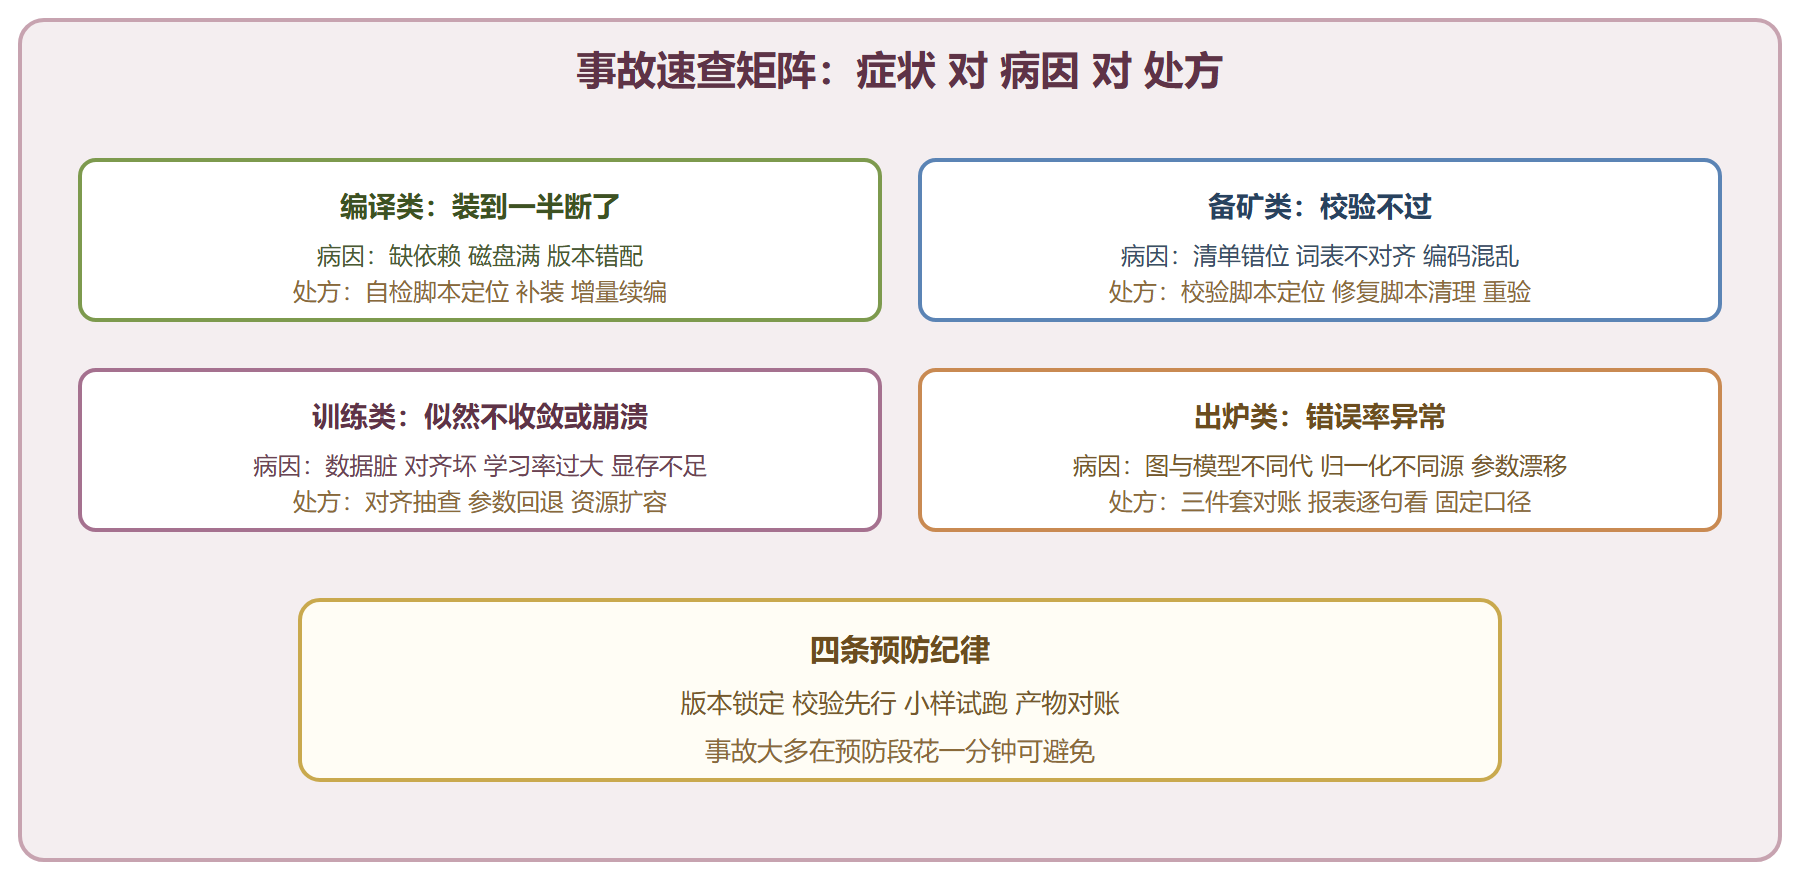
日志三级各有含义:常规信息是流水账,偶看无妨;警告是"没坏但不健康",要归类统计(同一句警告刷屏,通常指向同一处配置);错误是"已经坏了",直接定位。诊断的路径纪律只有一条:按工序定位,不按报错字面乱搜。先判断事故属于哪道工序(编译、备矿、训练、出炉),再进对应工序的日志目录看最后几十行,最后才去查这个报错的具体含义。
# 一次典型的排查动作序列 # 第一步:全目录扫错误,锁定出事的工序 grep -rn "ERROR" exp/*/log | head -n 20 # 第二步:进事发日志看尾部上下文 tail -n 60 exp/tri3/log/align.1.1.log # 第三步:确认是哪类资源问题(内存或磁盘) df -BG . | awk 'NR==2 {print "磁盘余量", $4}' free -g | awk 'NR==2 {print "内存余量", $7 "G"}' # 预期输出:错误行会指向具体文件与行号, # 资源余量为零时,先解决资源再谈代码
图 四类高频事故的速查矩阵
三、预防纪律与运营节奏
四条纪律展开说。版本锁定:代码版本、依赖版本、配置文件统一入版本库,任何"顺手一改"都要留痕——第 5 章那句"参数组合没记录就换目录"的坑,根子就是没锁定。校验先行:每道工序的产物先过校验闸门再进下一道,闸门便宜,返工昂贵。小样试跑:全量任务前用两百分之一的小样走通全流程,三分钟换三小时。产物对账:每道工序结束后对照"应产清单"清点文件(模型在不在、对齐全不全、报表出没出),缺件的流程等于没跑完。
运营节奏上,建议每周固定三件事:看一眼磁盘与产物的增长(实验目录是沉默的磁盘杀手);把本周新踩的坑按四类矩阵归档进自己的事故本;跑一遍关键指标回归(开发集错误率、在线实时率),确认没人悄悄动了口径。矿场的稳定不是不出事,是出了事都在预案里。
多人共坑的场景再补几句。共用服务器上,约定"实验目录带人名前缀、队列任务写清联系方式、超长任务提前打招呼"三条公德,能消掉八成协作摩擦。交接项目时按第 5 章的四份交付物清单打包(图目录、解码目录、报表、词格),配上版本锁定的配置快照,接手的人半天能复现你的指标——能复现,才谈得上维护与迭代。这两件事都不难,难的是把它们变成习惯。
⚠️ 常见坑一:多任务共用同一输出目录,后启动的任务覆盖先启动的产物,对账时才发现少了文件——输出目录必须按实验编号隔离。坑二:排队长任务占着队列表却已挂掉,后面任务干等,设置合理的超时与心跳检查。坑三:把"警告刷屏"当背景噪音忽略,多数警告是慢性病的早期症状。
💡 关键直觉:运维的目标不是"能解决难题",而是"让问题在发生前就被四条纪律拦住"。事故本越厚,说明预防越薄。
本节要点回顾
- 算力分开画像:高斯段吃内存与核,网络段吃显卡,规划排队分开算。
- 调度与计算分离:执行器两行配置切本机与集群,主脚本不动。
- 按工序定位:先判工序再看尾部最后查含义,别被报错字面带跑。
- 四条纪律兜底:版本锁定、校验先行、小样试跑、产物对账。
全教程到这里收官。从第 1 章的勘矿建场到本节的运营排障,六座矿区连成一条完整产线——愿你自己的语音淘金场,早日出金。