1.1 NLP发展历程与Transformer的历史地位
1.1 NLP发展历程与Transformer的历史地位
本节摘要:自然语言处理(NLP)的目标是让计算机理解、解释与生成人类语言,其方法脉络依次走过基于规则、基于统计、浅层机器学习与深度学习四个阶段。2017 年 Transformer 的出现是这条脉络上的分水岭:它取代 RNN 与 LSTM 成为序列建模的主流架构,并催生了 BERT、GPT、T5 等大规模预训练模型,是当前整个 NLP 技术栈的基石。本节以阶段演进为线索,说明每一代方法解决了什么、又留下了什么债,最后定位 Transformer 的历史坐标。
学习目标
阅读完本节,你应当能够:
- 按顺序说出 NLP 四个发展阶段及各自的代表性技术;
- 解释规则方法为何必然让位于统计方法,统计方法又卡在哪里;
- 说明词向量(Word2Vec、GloVe)对深度学习时代的奠基意义;
- 描述 RNN、LSTM、GRU 到 Seq2Seq 加注意力的演进逻辑;
- 阐述 Transformer 的历史地位:它改变了什么,又依赖哪些前人积累。
一、从规则到统计:前深度学习时代
上世纪五十年代到八十年代,NLP 的主流是符号主义。语言学家手工编写语法规则与词典,计算机按规则解析或生成句子,代表工作包括乔姆斯基的转换生成语法与各类专家系统,早期机器翻译实验(如 Georgetown-IBM 实验)也属此列。这套路线的困境不难想象:自然语言充满例外与歧义,规则永远写不完;为英语写的规则搬到中文上几乎要推倒重来,迁移成本高昂。
八十年代末起,随着大规模语料库可用与算力提升,统计方法登场。人们不再教机器"什么是主语",而是让它数频率:N-gram 模型做语言建模与机器翻译,隐马尔可夫模型做词性标注,条件随机场做命名实体识别,统计机器翻译在九十年代末到二十一世纪初占据主导。统计方法的优势是鲁棒、能从数据中自动学习、对未见数据有一定泛化能力;但它的天花板同样明显——严重依赖人工设计的特征,难以捕捉长距离依赖,对深层句法与语义的理解力不从心。
| 阶段 | 代表技术 | 主要优势 | 核心局限 |
|---|---|---|---|
| 规则方法(1950s-1980s) | 转换生成语法、专家系统 | 可解释、无需数据 | 规则难穷尽、迁移性差 |
| 统计方法(1990s) | N-gram、HMM、CRF | 从数据自动学习 | 依赖特征工程、长程依赖弱 |
| 浅层学习(2000s) | SVM、最大熵、词向量 | 分类性能提升 | 特征工程仍是瓶颈 |
| 深度学习(2010s) | RNN、LSTM、注意力、Transformer | 端到端表示学习 | 算力与数据需求剧增 |
浅层机器学习阶段是两者之间的过渡:支持向量机、最大熵模型配合人工特征完成文本分类、情感分析这类任务。这个阶段埋下了一颗重要的种子——词向量。Word2Vec 与 GloVe 把离散的词映射到低维连续向量空间,语义相近的词在空间中彼此靠近,"国王减去男人加上女人约等于女王"这类现象第一次让从业者看到,语言可以变成可运算的几何对象。词向量是后续一切深度 NLP 的基础设施。
二、循环网络时代与注意力的萌芽
二十一世纪一零年代,深度学习全面接管 NLP。循环神经网络(RNN)用带记忆的结构处理变长序列,理论上能记住历史信息;但梯度消失与爆炸让朴素 RNN 在长句面前力不从心。长短期记忆网络(LSTM)与门控循环单元(GRU)通过遗忘门、输入门、输出门等门控机制控制信息流动,显著缓解了梯度问题,成为此后数年的标准配置。
真正的转折来自两项组合创新。其一是 Seq2Seq 框架:编码器读入整个句子压缩成一个向量,解码器据此逐词生成译文,神经机器翻译(NMT)借此全面超越统计机器翻译。其二是注意力机制:人们很快发现,把整句话压进一个固定长度的向量,长句信息必然溢出,于是让解码器在生成每个词时"回头看"编码器的各个位置,按相关度加权取用信息。注意力最初是 LSTM 的外挂组件,却为 Transformer 埋下了直接的伏笔。
技术演进里程碑
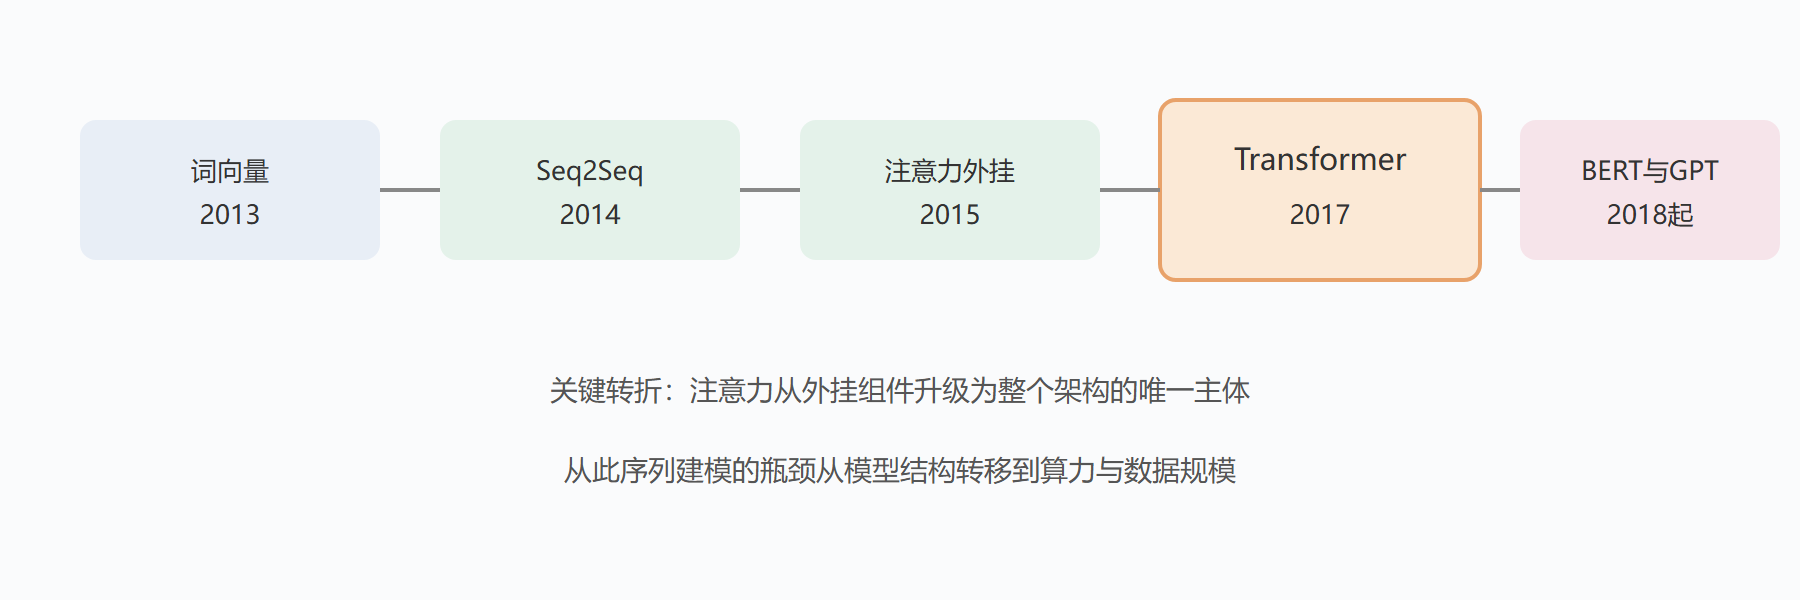
三、Transformer 的横空出世
2017 年,Vaswani 等人的论文《Attention Is All You Need》提出 Transformer。标题本身就是宣言:去掉循环与卷积,只靠注意力。这个决绝的选择换来了两样东西——任意两个位置之间的信息路径从随距离增长缩短为一步直达,以及整个序列的计算可以完全并行展开。前者解决长距离依赖,后者释放了 GPU 的算力,让训练前所未有的大模型在工程上变得可行。
值得注意的是,Transformer 并非凭空出现。词向量提供了表示基础,RNN 与 LSTM 积累了序列建模的经验与教训,Seq2Seq 时代的注意力机制更是直接的技术前身。它是站在巨人肩膀上的集大成者,而不是推翻一切的革命。
它的历史地位可以从三个层面看。其一,架构层面:Transformer 迅速取代 RNN 与 LSTM,在机器翻译等任务上取得当时最佳性能,并被迁移到计算机视觉(Vision Transformer)等领域。其二,范式层面:其并行性与扩展性使"海量文本预训练加下游微调"成为标准工作流,BERT、GPT 系列、T5 等模型由此覆盖了文本分类、问答、摘要、生成几乎全部子领域。其三,产业层面:今天的大语言模型技术栈,无论多复杂,底层堆叠的都是同一种 Transformer 块。
💡 一个值得记住的视角:NLP 七十年的历史,可以概括为"逐步减少对人工设计的依赖"——从人工规则到人工特征,再到自动学习的表示。Transformer 是这条曲线上的关键一跃,但不是终点。
四、为什么值得花一节讲历史
有人觉得历史是闲笔,直接学架构不就好了。我的经验相反:不知道 RNN 卡在哪里,就体会不到自注意力每处设计的分量;不知道注意力曾是 LSTM 的外挂,就理解不了"只用注意力"这个决定有多大胆。第 1.2 节将把 RNN 与 LSTM 的局限逐条拆开,那份"困境清单"正是 Transformer 设计动机的反面清单。
⚠️ 常见误解:把 Transformer 理解成"更快的 RNN"。两者的差异是结构性的——RNN 把历史压进一个随时间传递的隐藏状态,Transformer 让每个位置直接看见全部位置。计算方式的差异只是这个结构差异的副产品。
五、几个常被问到的问题
规则方法真的彻底失败了吗?
在通用语言理解上是的,但它没有被完全淘汰。领域极窄、错误代价极高、且完全无数据的场景(某些法律与航空术语的规范化处理),规则仍有用武之地;现代系统也常把规则当作神经模型外的校验层。演进叙事容易把旧方法描绘成一无是处,更准确的说法是:每一代方法都退守到它仍然最划算的生态位。
词向量与 Transformer 的表示有何本质区别?
词向量是静态的——每个词无论出现在什么句子,向量恒定不变,多义词只能取各义平均。"苹果"的向量悬在公司与水果之间,两头不靠。Transformer 产出的是动态表示:同一个词经过自注意力加工后,表示随上下文流动,在"苹果发布手机"里偏向公司义,在"吃一个苹果"里偏向水果义。这个"上下文相关表示"的跃迁,是深度时代相对词向量时代最关键的一步,也是 BERT 类模型表示能力强的底层原因,第 3 章编码器一节会展开。
为什么 2017 年之后没有再出现同等量级的架构更替?
一部分原因是 Transformer 的通用性太强:它把顺序信息、局部性等归纳偏置降到极低,能力主要靠数据与参数规模兑换,而"规模化"这条路在算力持续增长时几乎一直有回报。后来的大量创新(长上下文、稀疏注意力、混合架构)更像在 Transformer 骨架上的修补与扩展,而非另起炉灶。架构的稳定期未必是终局,但它的长寿本身就说明了"并行加全局交互"这个组合的设计质量。
学这段历史对面试或实战有帮助吗?
直接拿年代答题的机会不多,但历史脉络是组织知识的骨架。面试里被问"为什么用 Transformer 而不用 LSTM",答得出"顺序计算阻塞并行、长程依赖逐步衰减、固定隐藏状态是瓶颈"这三条因果,远比背架构图加分;实战中选型时,知道每代方法的适用生态位,才能在"新架构"的营销话术里保持判断力。
统计时代的遗产今天还能看到吗?
能看到,而且比你想象的多。分词、词性标注这些基础组件在许多生产管线里仍是统计模型的领地;搜索引擎的关键词匹配与排序逻辑里也残留大量统计思想。更根本的遗产是方法论:从数据中学习规律、用 held-out 数据评估泛化——这套科学流程贯穿至今。深度学习没有推翻它,只是把"人工设计特征"换成了"自动学习表示",实验方法论本身一脉相承。理解这一点,能避免把技术演进误读为推倒重来。
要点速记
- 四个阶段:NLP 依次走过规则方法、统计方法、浅层机器学习与深度学习,每一代都在减少对人工设计的依赖;
- 规则与统计的债:规则写不完、迁移差;统计依赖特征工程、长程依赖弱,这两笔债最终都由表示学习来还;
- 词向量是地基:Word2Vec 与 GloVe 让语言变成可运算的几何对象,是深度 NLP 的起点;
- 注意力的出身:注意力最初是 Seq2Seq 加 LSTM 体系里缓解固定向量瓶颈的外挂组件,后成为 Transformer 的唯一主体;
- 2017 年的转折:《Attention Is All You Need》去掉循环与卷积,换来一步直达的远距离连接与完全并行的计算;
- 三层历史地位:主流架构、预训练范式的使能者、大语言模型技术栈的公共底座;
- 承前启后:Transformer 集词向量、序列建模探索与注意力机制之大成,理解它的最佳方式是理解它 replaces 了什么。
下一节我们把镜头对准被取代者:RNN 与 LSTM 的五项固有局限,一份 Transformer 设计动机的对照清单。
常见疑问
问:为什么说 2017 年那篇论文是分水岭,之前之后差在哪?
答:之前的主流范式是「循环或卷积打底,注意力做点缀」——机器翻译系统里注意力只是架在 RNN 之上的一层加权技巧;之后注意力从配角升为主干,循环结构被整体抛弃。差别的实质是并行化能力:循环必须逐词推进,注意力可以一步算完全部词对,训练速度的数量级提升直接换来了模型规模的扩张,后面的预训练大模型时代由此才可能。
问:Transformer 只属于 NLP 吗?
答:早就不是了。视觉领域的视觉 Transformer 把图像切块当词元处理,语音、蛋白质结构预测、代码生成纷纷迁移。它真正提供的不是某个 NLP 技巧,而是一套通用的「集合元素间两两交换信息」的机制——凡是能表示成一组向量的数据,都能用。这也是它历史地位的核心:从 NLP 架构升格为深度学习的通用底座。