第1章 从序列困境到注意力思想
第1章 从序列困境到注意力思想
章节摘要:本章回答两个问题——Transformer 之前的世界是什么样的,以及注意力机制的核心抽象是什么。我们先纵览 NLP 从规则、统计到深度学习的四个阶段,再剖析 RNN 与 LSTM 在并行计算、长距离依赖、隐藏状态瓶颈上的固有局限;随后直接引入 Query、Key、Value 的检索式注意力模型,把它当作一个独立的数学对象讲透;最后回到 Transformer 全景,看它如何用一套完整的架构答卷回应前文列出的所有困境。读完本章,你手里的概念工具足以支撑后续任何一章的阅读。
先说结论
阅读完本章,你应当能够:
- 按时间线描述 NLP 四个主要发展阶段及各自的代表性技术与局限;
- 准确说出 RNN 顺序计算导致无法并行的原因,以及长距离依赖衰减的机理;
- 解释隐藏状态为何构成信息瓶颈,以及它与注意力机制的关系;
- 用图书馆检索的类比说清 Query、Key、Value 各自的角色;
- 写出缩放点积注意力的计算步骤,并解释缩放因子的作用;
- 列举 Transformer 相对 RNN 与 LSTM 的五项核心优势及其代价。
核心概念速览
注意力机制的本质,是把"信息检索"变成了一个可微分、可学习的运算。
章首概念地图
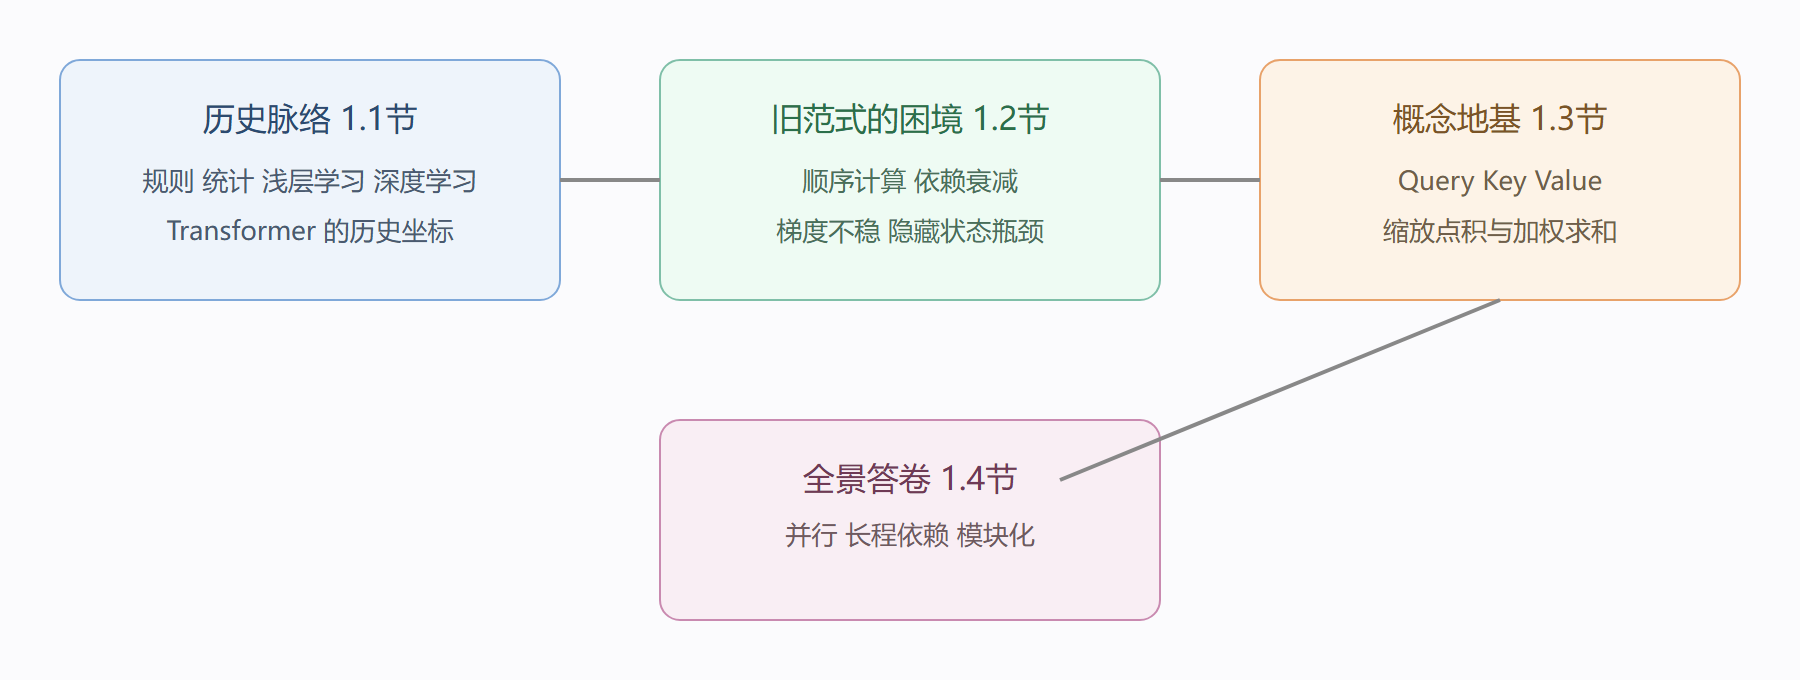
子章节导航
1.1 NLP发展历程与Transformer的历史地位
从乔姆斯基的转换生成语法讲到 Word2Vec、LSTM、Seq2Seq,再到 2017 年的转折点。这节的价值在于建立坐标系:Transformer 不是凭空出现的,它站在词向量与注意力机制多年积累之上。
1.2 传统序列模型RNN与LSTM的局限
逐条拆解顺序化处理、长距离依赖、梯度消失、固定隐藏状态、缺乏远距离直连这五个问题。每一条都对应 Transformer 设计中的一个直接回应,是理解后者的动机清单。
1.3 注意力机制总览:Query、Key与Value
本章的概念核心。用信息检索类比引入三个角色,再走完缩放点积注意力的完整计算流程。此节放在架构之前,是全书"概念筑基"路线的落点。
1.4 Transformer模型总览与核心优势
在概念就位后给出 Transformer 的整体图景:编码器-解码器骨架、并行计算、常数级路径长度的远距离连接,以及它为预训练时代铺路的结构性原因。
子章节之间的逻辑关系
一句话论点:1.1 与 1.2 列出"旧世界欠下的账",1.3 给出还账的核心工具,1.4 把工具装进整机。
1.1 历史坐标 1.2 困境清单 \ / \ / v v 1.3 注意力抽象模型(可微分的检索) | v 1.4 Transformer 全景与优势验证
1.3 节的 Query、Key、Value 会在第 2 章被反复引用——多头注意力无非是并行执行多组这样的检索,位置编码则是弥补检索本身"不识顺序"的缺陷。可以说,第 1 章的抽象程度最高,越往后越具体。
本章常见问题
学过一点深度学习,能不能跳过历史直接读第2章?
可以,但建议至少精读 1.2 与 1.3。1.2 的五项局限清单是全书动机的索引,跳过它,后面很多设计会退化成"论文就是这么写的";1.3 的 Query、Key、Value 检索模型则是第 2 章开头直接引用的工具,缺了它,自注意力六步流程会看得吃力。1.1 的历史内容可以快读,把四个阶段的名字和各自的天花板记住即可。
注意力机制是 Transformer 发明的吗?
不是,这是最常见的误解。注意力最早作为 LSTM 翻译系统的外挂组件出现,用来缓解固定上下文向量的信息溢出。Transformer 的贡献是"只用注意力"——把外挂升级为整台发动机,彻底去掉循环结构。1.1 节末尾与 1.3 节开头都会回到这条演化线。
为什么 RNN 的局限要用一整节来讲?
因为它们不是背景板,而是设计约束。Transformer 的每一项核心设计都能对应到一项局限:并行计算对应顺序依赖,一步直达对应信息衰减,残差连接对应梯度消失。把因果链的两端都握住,知识才不是孤立的名词。这份清单在第 3、4 章还会被反复引用。
本章的学习产出如何检验?
三个可操作的动作:其一,向没接触过的同事用五分钟讲清"RNN 为什么慢";其二,白纸默写缩放点积注意力的五步流程;其三,说出五项 RNN 局陷与 Transformer 设计的一一对应。三个动作全部完成,本章即可翻页——它们分别检验叙事能力、机制掌握与因果映射,是比做题更贴近真实工作的考核。
前置知识与后续延伸
- 前置:基本的线性代数(矩阵乘法、向量点积)、softmax 函数的概念、对神经网络训练流程的粗略了解。不要求读过 RNN 的实现细节,1.2 节会自带足够的铺垫。
- 为后续铺垫:1.3 节的缩放点积计算流程是第 2 章自注意力与多头注意力的直接前置;1.2 节的"困境清单"在第 3 章讲解码器掩码、第 4 章讲自回归推理时还会回头呼应;1.4 节的整体框架图则是第 3 章三节内容的导览图。
读完本章不妨自问:如果让你设计一个"任意两词一步直达、又能整批并行"的序列运算,你会从哪里下手?带着这个问题进入 1.3 节,体会 Query、Key、Value 设计的必然性。
本章自测表
| 自测问题 | 答不上来回看 |
|---|---|
| 长句翻译里 RNN 到底败在哪一步? | 1.2 梯度与瓶颈两小节 |
| Query、Key、Value 各自对应检索里的什么? | 1.3 |
| Transformer 相对前代的三条硬优势? | 1.4 |
| 注意力思想是 Transformer 发明的吗? | 1.1 与 1.3 的历史注 |
第一章的任务不是记住年代与名词,而是建立一条因果链:序列建模的真实困难,如何一步步逼出注意力,注意力又如何长成完整架构。因果链通了,后面三章的每个组件都只是这条链上的必然环节。