1.2 传统序列模型RNN与LSTM的局限
1.2 传统序列模型RNN与LSTM的局限
本节摘要:循环神经网络(RNN)及其变体 LSTM、GRU 通过维护隐藏状态按时间步顺序处理序列,曾长期是 NLP 的标准模型,但存在五项固有局限:顺序计算无法并行、长距离依赖随传递衰减、梯度消失与爆炸残留、固定维度隐藏状态构成信息瓶颈、相远位置缺乏直连通道。本节逐条剖析这些局限的机理,它们共同构成 Transformer 设计动机的"反面清单"——后文的每一项架构创新,都能在这份清单上找到对应的欠账。
本节目标
阅读完本节,你应当能够:
- 解释 RNN 隐藏状态的传递机制,说明"后一步依赖前一步"如何阻塞并行;
- 描述 LSTM 门控机制的思路,以及它为何只是缓解而非根治长程依赖问题;
- 从梯度传播角度分析信息随时间步衰减的原因;
- 说明固定大小隐藏状态为何构成信息瓶颈;
- 把五项局限与 Transformer 的对应设计一一挂钩。
一、顺序计算:并行的天堑
RNN 的核心是循环结构:时刻 t 的隐藏状态由前一时刻的隐藏状态与当前输入共同计算得出。这个设计朴素地贴合"逐词阅读"的直觉,却埋下致命的工程问题——想算第 t 步,必须先算完第 t 减一步。整个序列的计算是一条严格的串行链。
现代 GPU 的算力靠成千上万个核心同时工作来释放,串行链意味着任一时刻只有一个时间步在推进。批处理维度上固然可以并行处理多条序列,但序列内部的时间步始终无法展开。序列越长,训练时间线性增长,长文档、长对话场景下的代价难以承受。这不是实现优化能补救的问题,而是结构属性。
对比一目了然:Transformer 的自注意力把整条序列当作矩阵一次性相乘,所有位置同时更新。GPU 喜欢前者,讨厌后者。
二、长距离依赖:信息在接力中流失
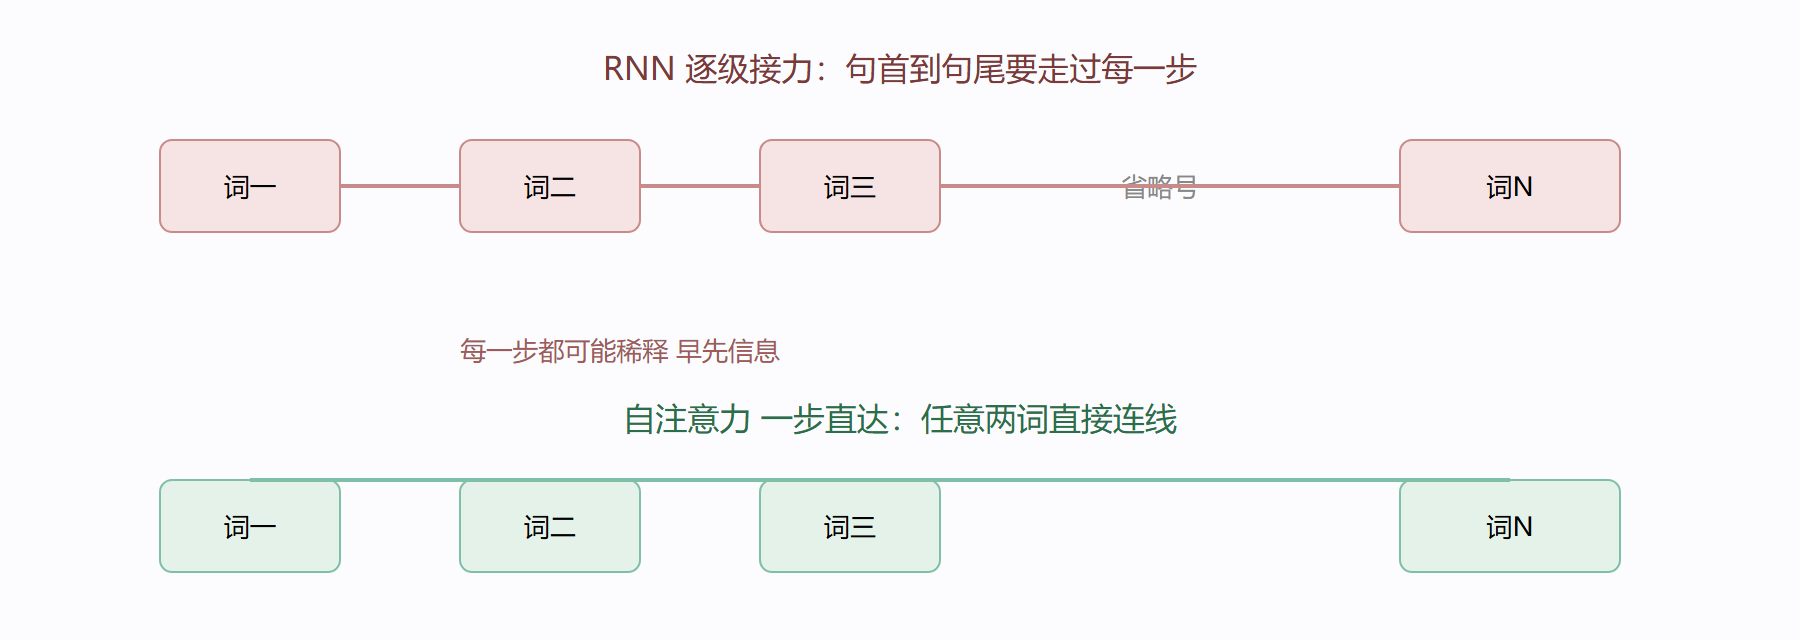
语言里充满远距离关联。"那只在院子里追了一下午蝴蝶的猫,最后趴在它最喜欢的垫子上睡着了"——"猫"与"睡着了"是主谓关系,中间隔着十几词。RNN 处理这句时,"猫"的信息要靠隐藏状态逐词接力传到句尾。
LSTM 与 GRU 的门控机制正是为这条接力路线设计的护轨。遗忘门决定保留多少旧信息,输入门决定写入多少新信息,输出门决定对外暴露什么。有了护轨,信息传递比朴素 RNN 稳得多。但护轨不能改变路线本身:信息仍要经过每一个中间时间步,每一步的写入与读取都可能稀释早先的内容。序列拉长到一定程度,句首信息对句尾的影响仍然会逐渐衰减。门控缓解了梯度消失,没有根除记忆衰减。
信息接力与一步直达的对比
三、梯度问题:训练信号的衰减与爆炸
从训练动力学看,反向传播要把损失信号从序列末尾传回首部。经过的每个时间步都是一次矩阵乘法,连乘的因子若普遍小于一,梯度指数级消失,网络前端学不到东西;普遍大于一则指数级爆炸,训练直接发散。LSTM 的门控让梯度有了"高速公路"式的直通通道,大幅缓解了消失问题,但在序列特别长或权重设置不当时,消失与爆炸仍可能发生。梯度不稳的另一面是工程上的小心翼翼:老一辈调 RNN 的人几乎都经历过小心翼翼配置梯度裁剪的日子。
四、固定维度隐藏状态:先天的信息瓶颈
换个角度看,隐藏状态像一本固定页数的笔记本,无论句子多长,都要把所有要点记进同一本。十词的句子绰绰有余,五百词的文档必然丢细节。更麻烦的是,这个瓶颈还要承担"随时可检索"的职责——解码时需要的某个数字、某个名字,可能埋在几百步之前的笔记里,模型没有一个定位取用的机制。
早期 Seq2Seq 翻译正是被这个瓶颈卡住:编码器把整句压成一个向量,解码器只看这一向量,句子一长译文质量骤降。注意力机制的最初使命,就是给解码器装上"翻回原稿"的能力——这也解释了为什么注意力一出生就与"按需检索"绑定。
五、缺乏远距离直连
把前几条串起来,根子在于 RNN 没有让相远位置直接对话的通道。任何两个词要交互,信息必须途经中间所有时间步,路径长度等于词距。人类阅读并非如此:读到代词时,我们会直接把目光跳回先行词,而不是在心里重读中间每一个词。模型的交互拓扑限制了它能高效表达的关系范围。
六、局限清单与 Transformer 的回应
| 局限 | 机理 | Transformer 的回应 |
|---|---|---|
| 无法并行 | 时间步串行依赖 | 自注意力矩阵运算,全序列同时更新 |
| 长程依赖衰减 | 信息逐步传递被稀释 | 任意位置一步直达 |
| 梯度不稳 | 连乘导致消失或爆炸 | 残差连接提供梯度旁路 |
| 隐藏状态瓶颈 | 固定向量装不下长序列 | 每位置保留独立表示,注意力按需取用 |
| 缺乏直连 | 交互须途经中间步 | 全连接的注意力图 |
⚠️ 提醒一个容易被忽略的事实:Transformer 并非全盘占优。自注意力的计算量随序列长度平方增长,RNN 则是线性——超长序列场景下,旧架构的这笔账反而划算。这也是后续稀疏注意力等研究方向的动力,详见第 3 章之后的延伸讨论。
💡 我的建议:把这张对照表当作后续章节的阅读地图。每学到 Transformer 的一个组件,就回来问一句"它还的是哪笔债"。这样学架构,记住的不是零件清单,而是因果链。
七、把局限放进具体场景检验
抽象列局限容易左耳进右耳出,放进三个真实场景就扎实了。
场景一,机器翻译。源句五十词,编码器读完压缩成一个向量,解码器逐词生成。句首的人名、数字在传递中衰减,译文里人名错拼、数字漏译——这是隐藏状态瓶颈与长程衰减的叠加表现。当年注意力机制正是为这个痛点而生:让解码器直接回看编码器各位置,绕开固定向量。场景二,长文档分类。一份几千词的文档判定情感倾向,LSTM 读到最后,开头的核心论据已被稀释,模型只凭结尾几段下判断,准确率肉眼可见地输给能全局检索的架构。场景三,训练吞吐。同样一块 GPU,RNN 因时间步串行,硬件利用率常年在低位徘徊;换成注意力架构后吞吐翻数倍,同等预算能喂进多一个量级的数据——规模红利的前提是并行,这正是第 1.4 节的核心论点。
再补一层训练动力学的细节。梯度消失不只是"学得慢":它对不同位置的影响不均匀——序列早期位置的梯度路径更长、衰减更重,导致模型对句首信息的更新系统性滞后,表现为"总是记不住开头"。门控机制缓解的正是这种不均匀。而梯度爆炸即使被裁剪控制住,频繁触发裁剪本身也意味着优化轨迹颠簸,有效学习率被迫压低。这些二阶现象共同构成了 RNN 时代调参的日常。
还有一条容易被忽略的账:双向性。理解任务里看到下文对判断上文至关重要,RNN 的因果结构天然单向,双向叠两个方向虽可行,但参数翻倍且仍受顺序计算束缚;注意力的全局连接则天然双向(不受掩码约束时),一词吸收上下文两侧信息毫不费力。Transformer 后来的编码器型模型全部受益于此。
⚠️ 语气上的提醒:批判旧架构不等于它们一无是处。在序列很短、数据很少、算力受限的场景(某些嵌入式与流式信号处理),LSTM 与 GRU 至今仍是合理选择——它们参数少、推理步进开销恒定、对硬件要求低。工程选型的成熟标志,是能说出每个选项的适用边界,而不是追逐新名词。
💡 动手建议:若时间允许,用开源框架各训一个小型 LSTM 与小型 Transformer 做同样的短文本分类。小数据下 LSTM 未必输;把数据量放大十倍再比一次,差距就会显形。亲手复现这条交叉曲线,比任何论述都更能建立"何时该用谁"的直觉。
五项局限里哪一项最致命?
若只能挑一项,我选"顺序计算"。长程衰减与隐藏状态瓶颈在工程上都有补丁——注意力外挂、更大隐藏维度——唯有串行结构是写死在计算图里的,补丁绕不开它,GPU 的并行算力始终闲置。Transformer 的历史机缘正在于此:硬件进步与模型结构的错配积累了多年,注意力架构一次性兑现了这笔算力存款。把"最致命"理解为"最堵住扩张路径",比理解为"最影响精度"更贴近当年业界的真实痛点。
一节小结
- 串行结构阻塞并行:RNN 后步依赖前步,序列内部无法展开到多核,GPU 利用率低下;
- 门控是护轨不是新路:LSTM 与 GRU 缓解了梯度消失,但信息仍需逐步传递,长序列下记忆照旧衰减;
- 梯度连乘的不稳定:消失让网络前端学不动,爆炸让训练发散,残余风险始终存在;
- 固定隐藏状态是先天瓶颈:定长向量装不下不定长序列的信息,也缺乏定位检索机制;
- 交互路径等于词距:缺乏远距离直连,模型能高效表达的关系范围受拓扑限制;
- 五项局限对五项设计:并行、直达、残差、逐位置表示、全连接注意力图,一一对应;
- 不是全盘占优:注意力平方复杂度对超长序列是新的债,架构选择永远在权衡。
局限清单列完了。下一节直接进入全书的概念核心:Query、Key、Value——看注意力如何把"信息检索"变成可学习的运算。
常见疑问
问:LSTM 不是解决了长期依赖吗,为什么还说不够?
答:门控机制缓解了梯度消失,让「记住」成为可能,但没有解决「高效记住」——信息仍要沿时间步逐格搬运,远距离的两词之间隔着上百次状态更新,每一次都可能失真。缓解不等于根治:百词以上的句子,LSTM 的首尾呼应能力仍明显衰减,而注意力是任意两词直连,一步到位。工程层面更致命的是逐步计算无法并行,训练随序列长度线性变慢。
问:既然有这些局限,RNN 是否已被彻底淘汰?
答:在研究前沿基本退场,但在工业角落仍有阵地:极低功耗设备上的流式语音识别、状态空间模型复兴前的某些时序任务,循环结构的低内存占用仍有吸引力。技术史很少出现彻底归零,「退出主流」与「彻底消失」是两回事——理解旧架构的存活生态,也是理解新架构边界的一种方式。