1.3 注意力机制总览:Query、Key与Value
1.3 注意力机制总览:Query、Key与Value
本节摘要:注意力机制的核心是把"信息检索"改造成可微分、可学习的运算:每个位置提出查询(Query),与所有位置的键(Key)逐一匹配,按匹配程度对值(Value)加权求和,得到融合了全局信息的新表示。Transformer 采用的缩放点积注意力,其流程为线性变换生成 QKV、点积打分、除以键维度的平方根缩放、softmax 归一化、加权求和五步。本节把这套抽象模型当作独立数学对象讲透,它是后续自注意力、多头注意力与交叉注意力一切变体的公共内核。
你能学到什么
阅读完本节,你应当能够:
- 用图书馆或数据库检索的类比说清 Query、Key、Value 各自的角色;
- 按顺序写出缩放点积注意力的完整计算步骤与各步矩阵形状;
- 解释缩放因子为何取键维度的平方根,不缩放会发生什么;
- 说明 QKV 三个投影矩阵是可学习参数、训练中如何被优化;
- 区分自注意力、掩码自注意力与交叉注意力三种用法对同一内核的不同调用方式。
一、从检索说起:三个角色的分工
设想你在图书馆找资料。你心里有个问题——"Transformer 怎么处理长句子",这是查询;每本书的书脊标题是键,用来和你的问题比对;书里的正文是值,才是你真正要取用的内容。检索的过程:拿查询逐一比对所有键,越匹配的键,其对应值被取用的比重越大。
注意力机制把这个过程翻译成向量运算:查询向量与每个键向量做点积得到匹配分数,分数经 softmax 归一化成一组和为一的权重,再用权重对所有值向量加权求和。与硬检索"只取最匹配的一本"不同,注意力是软检索——所有值都按权重贡献,权重由匹配度连续决定。正因如此,整个过程处处可微,可以被梯度下降优化。这就是"可微分的检索"的含义,也是注意力能被端到端学习的根本原因。
在 Transformer 中,序列的每个词向量都会通过三个不同的可学习权重矩阵分别投影出自己的查询、键、值向量。换句话说,每个词既是提问者(发出查询),又是被检索的对象(提供键与值)。训练的过程,就是让这三组投影矩阵学会"提出好问题、贴好标签、备好内容"。
💡 值得咀嚼的一点:查询、键、值三者不必来自同一序列。查询来自解码器、键值来自编码器,就是交叉注意力;三者同源,就是自注意力。内核不变,只换数据来源——这个统一性是 Transformer 架构简洁的来源。
二、缩放点积注意力:五步走完
Transformer 原论文采用的是缩放点积注意力(Scaled Dot-Product Attention)。设输入序列有 n 个词,模型维度为 d,键向量维度为 d_k,完整流程如下。
第一步,线性变换生成 Q、K、V。把整条序列的向量叠成矩阵,分别乘以三个投影矩阵,得到查询矩阵、键矩阵、值矩阵。一次矩阵乘法完成全部位置的投影,这一步已经是全并行操作。
第二步,点积打分。查询矩阵与键矩阵的转置相乘,得到 n 乘 n 的分数矩阵,第 i 行第 j 列的元素表示第 i 个位置的查询与第 j 个位置的键的匹配程度。点积衡量两向量的方向一致性,是成本最低的相似度度量。
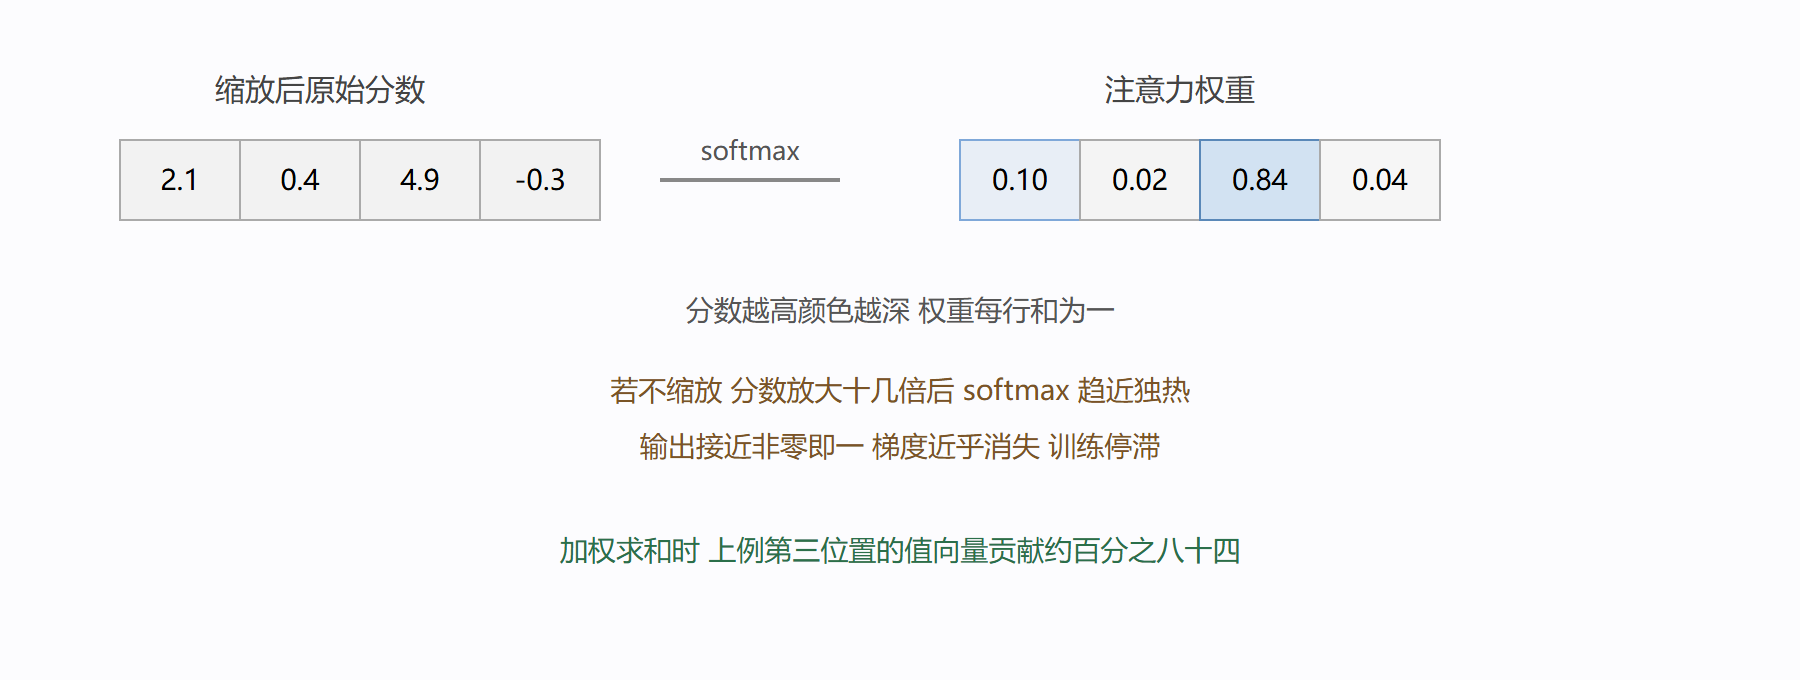
第三步,缩放。把分数除以键维度 d_k 的平方根。这一步容易被初学者跳过,却事关训练成败:维度越高,两随机向量的点积期望越大、方差越正比于 d_k,不缩放的话大维度下分数动辄几十上百,softmax 会进入饱和区——输出接近独热,梯度趋近于零,训练信号被掐断。除以平方根恰好把方差拉回一附近,softmax 保持在工作区间。
第四步,softmax 归一化。对分数矩阵逐行做 softmax,每行变成一组非负、和为一的权重,即注意力权重。第 i 行的权重分布,描述第 i 个位置对全序列各位置的"注意力预算"如何分配。
第五步,加权求和。权重矩阵与值矩阵相乘,每个位置得到一个新的表示——全序列值向量的加权和,权重就是它那行注意力权重。输出形状回到 n 行,每个词由此"读完全句"。
三、逐行看一个语义例子
抽象流程配一个具体例子会更扎实。句子"那只动物没过街,因为它太累了"里,模型要判断"它"指动物还是街。处理"它"时,其查询向量与"动物"的键向量点积出较高分数,与"累了"的键也有不错分数(语义上疲劳指向动物),softmax 后这两处拿到大头权重,于是"它"的新表示主要由"动物"与"累了"的值向量加权构成——指代消解在一次注意力计算里同步完成。
换个句子"那只动物没过街,因为街面太宽了",同样的"它",查询与键的匹配模式会随上下文改变吗?注意,投影矩阵在推理时已经固定,真正随句子变化的是各词的输入表示与匹配结果。注意力权重的可视化因此成为分析模型行为的重要窗口:把 n 乘 n 的权重矩阵画成热力图,能直观看到谁在关注谁。第 2 章会展示这类图。
打分到权重:softmax 的塑形作用
四、三种调用方式:同一个内核
注意力内核在 Transformer 里以三种方式被调用,区别只在 Q、K、V 的来源。自注意力:三者都来自同一序列,用于序列内部互相理解,编码器的主体。掩码自注意力:同为自注意力,但在 softmax 之前把未来位置的分数置为极大负值,使其权重归零,用于解码器保证生成因果性,详见第 3 章。交叉注意力:查询来自解码器上一层输出,键与值来自编码器最终输出,让生成中的每个词回头查阅输入序列。
| 调用方式 | 查询来源 | 键值来源 | 典型位置 |
|---|---|---|---|
| 自注意力 | 本序列 | 本序列 | 编码器各层 |
| 掩码自注意力 | 本序列 | 本序列 屏蔽未来 | 解码器各层 |
| 交叉注意力 | 解码器上一层 | 编码器最终输出 | 解码器各层 |
⚠️ 常见坑:把注意力权重直接当作因果解释。权重确实提供了可解释性线索,但它是学到的软匹配,不是逻辑推理的结论;单凭一张热力图断言"模型因为关注了词 X 所以输出 Y",在方法上站不住。把它当显微镜用,别当法庭证词用。
五、工程视角的取舍
点积注意力并非唯一选择,加性注意力(用小型前馈网络算匹配分)曾与它并存。原论文选点积的理由很工程:在硬件上可以完全归结为密集矩阵乘法,快且缓存友好,牺牲的只是理论表达力的一点弹性。另一个数字值得记:复杂度随序列长度平方增长,n 为一千时分数矩阵是一百万个元素,n 为十万时是一百亿——这是第 2 章末尾与后续效率讨论反复回头的约束。
💡 学习建议:这五步流程建议动手推一遍小例子,取三条三维向量手算点积、softmax、加权求和。注意力后面所有变体——多头、掩码、交叉——都只是这五步的不同编排,地基打牢,上面怎么盖都不慌。
六、几个值得想透的问题
查询、键、值为什么必须是三个不同的变换,而不是同一个向量?
因为三种角色对"相似"的定义不同。一个词作为查询时,它要找的是"能补全我语义的信息";作为键时,它要标榜的是"我能提供什么";作为值时,它交出的是实际内容。把三者绑成一个向量,等于强迫"我想找的"与"我能给的"完全重合,匹配的自由度大打折扣。拆成三个投影矩阵,模型可以为每种角色学出各自最优的几何空间——检索质量的上限由此抬高。这不是理论必然,而是被实践验证的高自由度设计。
加性注意力与点积注意力怎么选?
两者的差别在打分函数:加性用小型前馈网络算匹配分,表达力略强;点积直接算向量内积,快且能整体归结为矩阵乘法。序列长、批量大时点积的吞吐优势是压倒性的,Transformer 选它完全是工程理性。今天的绝大多数实现延续这个选择,加性方案基本退出了主流视野——快即是正义的典型案例。
注意力有没有"看不见"的信息?
有。点积只衡量向量间的线性对齐程度,维度固定的向量也只能承载有限信息。此外 softmax 的竞争结构意味着权重此消彼长:一个位置拿走高权重,其余位置必然被压低,模型无法同时"极高关注"两个远处位置而又保持分布和为一。这些结构性限制解释了为什么需要多头(分散多组预算)与多层(逐级精炼)来补足单一注意力的表达力——这也正是下一章两节的主题。
一个可供动手的小练习
取四个词的短句,手动设定三乘三的投影矩阵(随意填小数值),算出分数矩阵后逐行 softmax,观察权重分布;再把其中某个键向量改大两倍,看权重如何重新分配。这个十分钟的手算会留下肌肉记忆:注意力的一切复杂性,都建立在这页纸就能写下的运算之上。
核心回顾
- 软检索:注意力是可微分的检索,查询匹配键、按权重取值,全程可被梯度优化;
- 三重身份:每个词同时是提问者与被检索者,三个投影矩阵是可学习参数;
- 五步流程:投影生成 QKV、点积打分、按键维度平方根缩放、softmax 归一化、加权求和;
- 缩放的意义:抵消高维点积的方差膨胀,防止 softmax 饱和、梯度消失;
- 一次矩阵乘:打分与加权求和都是整批矩阵运算,为全序列并行铺平道路;
- 三种调用:自注意力、掩码自注意力、交叉注意力共用内核,仅数据来源不同;
- 平方复杂度:序列长度翻倍、计算量翻两番,这是注意力架构的核心代价。
内核已就位。下一节拉远镜头看 Transformer 全景——这台机器如何用同一个注意力内核,替换掉旧世界的整套循环装置。
常见疑问
问:Q、K、V 三个矩阵必须不一样吗,能不能共用一个?
答:共用(即自注意力的退化形式)会让「找谁」和「取什么」混在同一套表示里,一个词与自己点积永远最大,注意力退化成盯着自己看。分开投影的本质是让每个词能以三种身份参与检索:作为提问者发出 Query,作为被查者亮出 Key,作为内容提供者备好 Value。三种身份、一套权重,这是注意力表达力的来源。
问:注意力权重能直接当作「模型在看哪里」的证据吗?
答:要谨慎。权重确实反映了信息流的相对强度,但「重要」不等于「可解释」——已有研究表明注意力分布与输出归因并非严格对应,权重高的位置未必对决策贡献大。把它当调试线索可以(比如发现模型总盯着句首标点,多半有实现 bug),把它当因果解释写进论文则站不住。