1.4 Transformer模型总览与核心优势
1.4 Transformer模型总览与核心优势
本节摘要:Transformer 是 2017 年提出的序列建模架构,沿用编码器-解码器骨架,但两侧完全由堆叠的相同层构成,每层核心是多头自注意力与前馈网络,辅以残差连接、层归一化与位置编码。其核心优势包括:完全并行的计算、任意位置一步直达的长距离依赖建模、常数级的顺序计算步数、更简洁模块化的结构,以及由此带来的迁移学习能力——这些性质共同使大规模预训练成为可能。本节给出整机概览,为第 2 章的零件拆解与第 3 章的组装细节立好框架。
阅读收获
阅读完本节,你应当能够:
- 说出 Transformer 的五大组成要素及各自承担的职责;
- 从计算路径长度与并行度两个角度对比 Transformer 与 RNN 的本质差异;
- 解释"自注意力是位置盲的"这一性质及其与位置编码的关系;
- 说明并行性与扩展性如何转化为预训练时代的工程红利;
- 客观陈述 Transformer 的代价,避免把它当成无条件的银弹。
一、整机鸟瞰
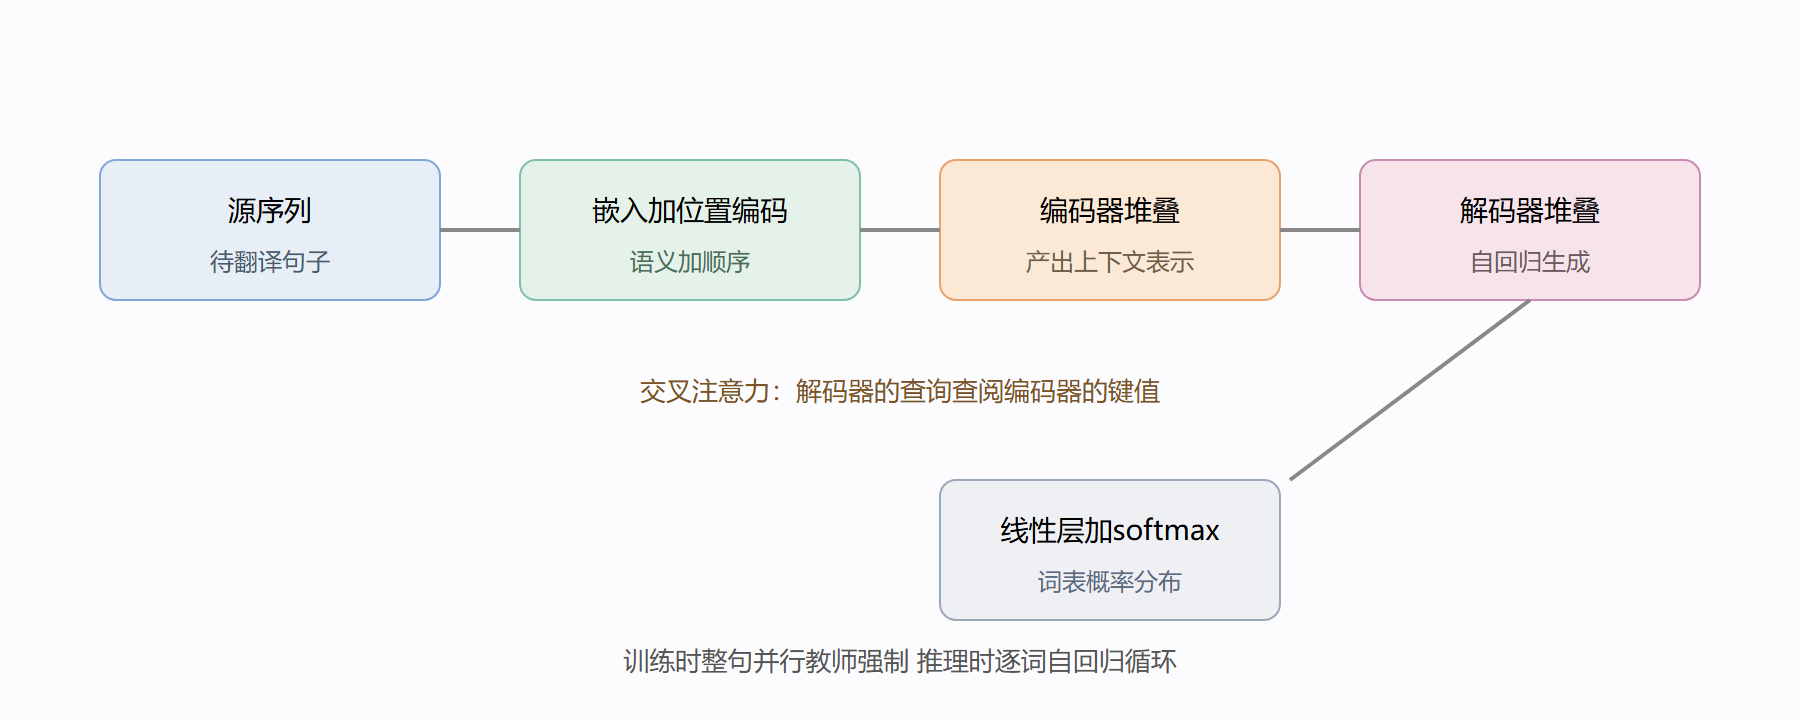
把 Transformer 的零件清单先列出来:编码器与解码器各由若干相同层堆叠(原论文取六层);每层内部是多头自注意力加前馈网络两个子层(解码器多一个掩码自注意力与交叉注意力);所有子层外包残差连接与层归一化;输入端用词嵌入加位置编码接入,输出端用线性层加 softmax 收口。数据流向可以一句话讲完:源序列经嵌入与位置编码进入编码器,产出上下文表示;解码器一边读这些表示,一边读自己已生成的序列,逐词产出目标。
这个骨架与 RNN 时代的 Seq2Seq 相比,变化集中在"用什么填充骨架"。旧版的编码器解码器是循环网络,两侧靠一个固定向量衔接;新版的两侧是注意力与前馈的堆叠,衔接方式换成解码器每生成一个词就通过交叉注意力回头查阅编码器全部位置。骨架没变,发动机换了。
整机数据流总览
二、五项核心优势逐一核账
其一,并行计算。 RNN 必须逐时间步推进,Transformer 的自注意力把全序列的打分与加权求和压成两三次大规模矩阵乘法,所有位置同时更新。训练阶段(配合教师强制)整句并行,GPU 利用率彻底释放。这是"大模型在工程上可行"的第一前提。
其二,长距离依赖一步直达。 上一节已给出机理:任意两位置的连接路径长度为一,不再随词距增长。处理"主语与谓语隔了十几词"这类句子时,信息不再被逐级稀释。
其三,顺序计算步数大减。 建立首尾联系,RNN 需要与序列长度同阶的串行步数,自注意力一步完成。需要诚实补充的是:单步的注意力计算量本身随长度平方增长,但这部分计算是可并行的——"串行深度浅、并行宽度大",正对现代硬件的口味。
其四,结构更简洁。 对比 LSTM 的输入门、遗忘门、输出门与细胞状态的纠缠,注意力加前馈的组合在概念上干净得多,模块化也让改造与实验更容易——后来 BERT 抽掉解码器、GPT 抽掉编码器,都是在这种模块化骨架上动刀。
其五,迁移学习能力。 这项优势严格说不是架构的数学性质,而是前三项的工程后果:训练快、可扩展,模型才能在海量无标注文本上预训练出通用表示,再以微调或提示的方式迁移到下游任务。BERT、GPT、T5 的成功路线,本质是 Transformer 的并行性与扩展性兑换成了数据与参数规模。
| 维度 | RNN 与 LSTM | Transformer |
|---|---|---|
| 串行步数(联系首尾) | 随序列长度增长 | 常数级 |
| 单步计算量 | 与长度线性 | 与长度平方 |
| 并行度 | 序列内部无法并行 | 全序列并行 |
| 远距离信息路径 | 逐步传递 易衰减 | 一步直达 |
| 参数与算力扩展性 | 受串行限制 | 天然适配大规模训练 |
三、位置盲与位置编码
自注意力有一个必须正视的副作用:它对顺序无感。把"狗咬人"与"人咬狗"的词向量打乱顺序喂进去,注意力计算得到的加权结果在结构上不区分先后——因为打分只看向量内容,不看位置。而语言显然在乎顺序。
Transformer 的补法是在输入端把位置编码向量直接加到词嵌入上,让每个词的表示自带"我在第几位"的信息。为什么加而不是拼?因为维度相同可直接相加,且三角函数式的设计让相对位置也能被后续层读出。细节留到 2.3 节展开,这里只需记住因果:注意力天然丢顺序,位置编码负责补回来。
⚠️ 提醒:别把"位置盲"当成缺陷。恰恰因为它不做顺序假设,同一套计算才能无差别处理代码、蛋白质序列、图像块——Vision Transformer 把图像切成小块当序列喂进来,直接复用整个架构。顺序无感是通用性的来源,位置编码是任务定制的接口。
四、优势的边界
核完账也要划清边界。第一,平方复杂度:序列长度上千时,注意力矩阵的显存与计算都成为瓶颈,长文档与高分辨率图像场景需要稀疏化或分层方案。第二,数据饥渴:注意力没有归纳偏置的"先验",小数据集上不一定打得过卷积或循环网络,原论文同期就有实验支持这一点。第三,推理自回归:训练并行不等于推理并行,解码时仍要逐词循环,这是第 4 章解码策略与缓存优化的主场。
💡 我的判断:Transformer 的真正贡献不是"更准",而是"可扩展"——它把序列建模的性能瓶颈从结构转移到了算力与数据上。在算力持续增长的年代,这是最值钱的性质;若算力逻辑逆转,这笔账就要重算。
五、原论文的配置与读图指南
把基础版的关键数字列全,作为后续阅读的参照原点:编码器解码器各六层;模型维度五百一十二;八头注意力,每头六十四维;前馈中间维度两千零四十八;dropout 零点一;warmup 四千步。大版本把维度放大到一千零二十四、头数十六。这组数字的好处是"够小能心算"——任何组件的参数量都能在纸面上估出来,比如单层前馈约八倍的维度平方,第 2.4 节会用到这笔账。
读原论文架构图有个实用顺序:从底部输入端开始(嵌入与位置编码相加),先看左列编码器塔的重复单元,再看右列解码器塔,注意解码器比编码器多一个子层、且多一条来自编码器顶端的输入线,最后看塔顶的线性层与 softmax。图上每个"多头注意力"方框内部,都是 1.3 节讲过的检索内核;每个子层外面套的"加与归一"方框,对应 2.5 节的稳定器。按这个顺序读图,论文的架构图就从迷宫变成了导读的反向索引。
再补一个"全家福"视角:Transformer 诞生后,家族沿三条支线分化——只取编码器的理解系(BERT 开端)、只取解码器的生成系(GPT 开端)、保持两塔的转换系(T5 代表)。分化能成立,靠的正是本节强调的模块化:骨架可裁剪、零件可复用。选型时的第一问"任务要理解还是要生成",答案直接指向对应支线,4.4 节将把这套分类展开成完整的选型方法。
⚠️ 数字层面的一个提醒:网上资料常把"六层"当成标准答案传播,实际项目中层数从两层到近百层都有,须按模型规模看待;但"模型维度能被头数整除、每头维度常取六十四"这类约束的稳定性高得多。记约束、看趋势,别背快照。
💡 自检方法:不看资料,默写基础版五项配置数字;再画一张两塔简图,标出解码器多出的子层与来自编码器的连线。两项都能完成的读者,本节目标达成。
预训练红利为什么偏偏落在 Transformer 头上?
三个条件的交集。其一,并行计算让"更多数据"能兑换成"更短训练时间",规模的边际成本可控;其二,全局交互让长文档的远距离信息不丢失,语料可以不受句子边界限制,网页级文本直接入料;其三,模块化骨架支持无损放大——维度、层数、头数按比例扩展,训练配方基本沿用。RNN 三条都卡:串行、衰减、放大即失稳。预训练不是被发明的算法技巧,而是被这套架构"解锁"的工程可能,这是理解 2018 年之后行业格局剧变的钥匙。
本节速览
- 五大要素:堆叠的编码解码层、多头自注意力、前馈网络、残差加归一化、位置编码,职责各异缺一不可;
- 骨架未变发动机换:沿用 Seq2Seq 骨架,衔接方式从固定向量换成逐词交叉注意力;
- 并行是第一红利:矩阵化计算让全序列同时更新,是大规模训练的工程前提;
- 路径长度为一:远距离依赖一步直达,串行深度浅而并行宽度大;
- 简洁带来可改造性:模块化结构让 BERT、GPT 等变体可以只取一半骨架;
- 位置盲与补法:自注意力不区分顺序,位置编码在输入端注入位置信息;
- 优势有边界:平方复杂度、小数据劣势、推理自回归,三点都需在选型时纳入考量。
全景有了,零件清单也立了。从下一章开始,我们把每个零件单独拎到工作台上:先从最核心的自注意力拆起。
常见疑问
问:并行训练优势具体大多少,有没有直观参照?
答:取决于序列长度与硬件,但量级感是这样的:同等参数量下,Transformer 的训练吞吐通常比 LSTM 高一个数量级——原论文在当时的翻译任务上用更少训练时间拿到更好指标,靠的就是这一点。直观原因是 RNN 处理一句百词的话必须串行跑一百步,Transformer 把一百个词一次性铺进矩阵乘法,GPU 的并行算力被吃满。
问:既然这么强,它有没有明显代价?
答:有两个。一是计算量随序列长度平方增长——词数翻倍,注意力计算翻两番,长文档处理因此成为专门的工程难题;二是失去归纳偏置——循环天然尊重顺序,Transformer 必须额外注入位置信息(第 2.3 节)。架构选择的本质是偏置与数据的交换:数据够多时,弱偏置的通用架构反而赢。