4.1 模型输入与输出处理
4.1 模型输入与输出处理
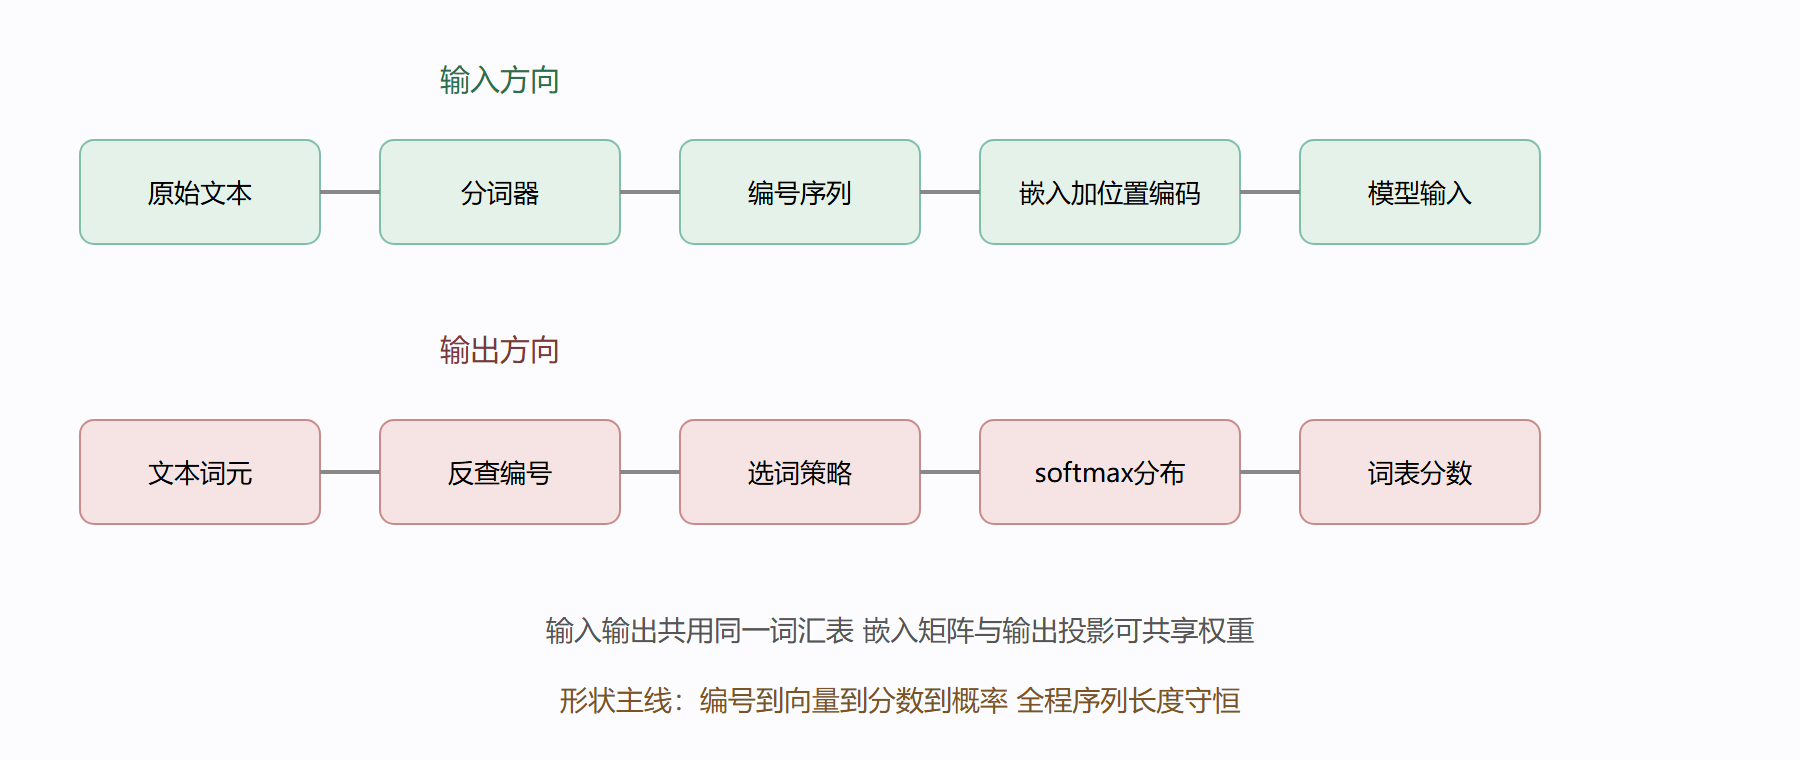
本节摘要:模型与真实文本之间隔着一层双向翻译。输入方向,原始文本经分词器切成词元,查词汇表得到编号,再经嵌入层与位置编码变成模型输入向量;输出方向,解码器顶层向量经线性层投影到词表维度、softmax 归一成概率分布,训练时与目标词比对算损失,推理时供解码策略选词。本节比较词级、字符级、子词级三档分词策略的取舍,讲清 BPE、WordPiece、SentencePiece 等子词方案的原理,并给出输入输出全链路的张量形状追踪。
先说结论
阅读完本节,你应当能够:
- 按顺序描述从原始文本到模型输入向量的完整流水线;
- 对比词级、字符级、子词级分词的优劣并说明子词胜出的原因;
- 说明 BPE 的构造流程与 WordPiece、SentencePiece 的差异;
- 解释词汇表大小与嵌入矩阵形状、输出层形状的关系;
- 追踪输出方向从解码器顶层到词表概率的形状变化。
一、分词:三档策略的取舍
模型只认数字,第一步是把文本切成离散单元并编号。切法有三档,各自的天花板与地板都很鲜明。
词级分词按词切分,直观且保留完整语义单元。代价是词汇表爆炸:常见语言的有效词汇量轻松超过几十万,嵌入矩阵与输出层随之膨胀,参数浪费在罕见词上;更麻烦的是未登录词问题——训练时没见过的词(新名词、拼写变体、生僻组合)只能映射到统一的未知符,信息全丢。
字符级分词切到单字,词汇表缩到几千以内,任何新文本都能处理,未登录词概念消失。代价走向另一端:序列变得极长——一句英文从十几个词膨胀到五六十个字符,注意力的平方复杂度雪上加霜;且单个字符承载的语义太稀薄,模型要花大量容量从字符拼出词义。
子词级分词是两者的折中,也是当前绝对主流。思路:常见词保持完整,罕见词切成有意义的片段。"transformer"是高频词就整个保留,"unfriendliness"可拆成"un""friend""liness"之类片段。词汇量可控(常见配置几万),未登录词能拆成已知片段兜底,序列长度接近词级。
| 维度 | 词级 | 字符级 | 子词级 |
|---|---|---|---|
| 词汇表大小 | 数十万 不可控 | 数千 | 数万 可配置 |
| 未登录词 | 映射未知符 丢信息 | 无此问题 | 拆成已知片段 兜底 |
| 序列长度 | 短 | 长 数倍于词级 | 接近词级 |
| 语义密度 | 高 | 低 需自行拼词 | 高 |
| 现状 | 已弃用 | 特殊场景 | 主流 |
二、BPE 与它的亲戚们
子词方案的代表是字节对编码(BPE)。构造流程像压缩算法:从字符级词表出发,统计语料中相邻单元对的共现频率,把最高频的一对合并成新单元,写进词表;重复数万次,词表逐渐长出高频词与常见片段。最终每个词都能表示为词表中若干单元的序列——高频词是单单元,生僻词是多单元拼接。
WordPiece 思路相近,合并准则从"频率最高"换成"使语言模型似然提升最大",产出的片段边界略有不同。SentencePiece 把分词与词表构造打包成语言无关的工具,直接从原始文本训练,空格也当作普通符号处理,对中文等不分词语言尤其友好。三者机制同源,工程选型更多看生态配套——用哪个预训练模型,就用它配套的分词器,词表必须严格对应。
分词之后是词汇表:每个词元分到一个唯一整数编号,训练与推理期间固定不变。编号本身无语义,只是嵌入矩阵的行号。
三、输入链路:形状一路追踪
从原始句子走到模型入口,逐站看张量。原始文本经分词器输出词元编号序列,形状为序列长度的一维整数组;批处理时多条序列补齐到同一长度,成二维整数矩阵,批大小行乘以序列长度列。编号经嵌入层查表——嵌入矩阵是"词表大小行乘以模型维度列"的参数矩阵,每行对应一个词元——得到三维张量:批大小、序列长度、模型维度。位置编码按序列长度生成、逐元素相加(2.3 节)。至此输入就绪,送入编码器或解码器堆栈。
| 站点 | 数据形态 | 说明 |
|---|---|---|
| 原始文本 | 字符串 | 一条或多条句子 |
| 分词后 | 编号序列 | 整数一维数组 |
| 批处理后 | 整数矩阵 | 补齐到批内最长 |
| 嵌入查表后 | 三维张量 | 序列长度乘模型维度 |
| 加位置编码后 | 同上 | 逐元素相加 入塔 |
嵌入矩阵的规模值得算一下:词表五万、模型维度五百一十二时,单嵌入矩阵就有约两千五百多万参数。现代大模型词表动辄十几万,嵌入与输出投影合计常占总参数的一到两成。一个常见优化是把嵌入矩阵与输出投影共享同一套权重(编号与预测同在一个词表空间,天然可复用),原论文即采用此绑定,省下可观参数。
四、输出链路:从向量回到词表
输出方向是对称的翻译。解码器顶层每个位置输出一个模型维度向量;线性层(输出投影)把它乘成词表大小的分数向量——每个词元一个分数;softmax 把分数压成非负、和为一的概率分布。训练时,这个分布与真实目标词比对,算交叉熵损失(4.2 节展开);推理时,解码策略从分布里选出下一个词元(4.3 节展开),编号经分词器反向映射回文本。
输入输出双向流水线
⚠️ 三条高频实战坑。其一,分词器与模型词表不配套:换了预训练权重却沿用旧分词器,编号全错,模型输出彻底乱码——务必成对加载。其二,填充符进入损失:批内短序列的填充位置若不屏蔽,交叉熵把这些位置当预测目标,梯度被垃圾任务污染。其三,中文场景忘了统一编码或繁简混用,分词器把整句切成字符流,序列长度暴涨。三条都属于"报错不明显、指标悄悄差"的类型,值得列进个人排查清单。
💡 实践建议:接手任何一个新模型,先做一次"往返测试":取一句话分词、查表、反查、拼回文本,确认无损往返;再打印词表大小与嵌入矩阵形状,对上再往下走。五分钟的仪式能省数小时的调试。
五、分词器实战深潜
词表大小的连锁反应
词表大小不是孤立超参,它牵动三处:嵌入矩阵行数(参数量)、输出投影与 softmax 的宽度(每步生成的计算量)、以及序列长度(子词切分粒度)。词表大则词元少、序列短(注意力省)但参数与输出层贵;词表小则反之。常见的平衡点落在三万到十五万之间,具体取值随语料与模型规模浮动。看到新模型发布配置时,先看词表大小与模型维度的乘积,就能估出嵌入环节占了多少参数盘。
一个中文场景的具体算例
设一句话三十个汉字。字符级分词产出三十个词元;子词方案若把高频双字词合并,可能产出十八到二十二个词元。别小看这三分之一差距:注意力计算量近似随长度平方走,长度降三成,注意力开销近乎减半;再加上批处理填充的减少,端到端吞吐的改善还会放大。这就是中文应用普遍选择带词合并的子词方案、而非图省事的字符级的量化理由。
分词器训练与复用的选择
自己训练分词器(在领域语料上跑词表构造)适合领域术语密集且数据充足的场景;直接复用通用模型配套分词器则省心且与预训练权重兼容。折衷做法是在通用词表上做小规模扩充。默认建议:先用配套分词器跑通基线,观察到明显的切分损耗(专有名词被拆碎、序列异常膨胀)再考虑定制——顺序别反,定制分词器意味着预训练词表失配,代价常被低估。
⚠️ 第四条实战坑补录:多语言混排(中英夹杂、表情符号)是分词事故高发区,症状是序列长度波动剧烈、部分位置频繁落到未知或字节回退单元。上线前用真实流量的抽样文本跑一遍分词长度分布,比事后救火便宜得多。
💡 建立个人分词体检三步:打印词表大小与其覆盖的累积频率;抽样十句真实业务文本看切分结果;统计长度分布的均值与长尾。三步的数据决定了分词环节要不要动、往哪动。
嵌入矩阵与输出投影共享权重的原理与风险是什么?
原理是编号空间同一:输入查表用"词表乘维度"矩阵,输出投影要"维度乘词表",转置即复用,省下一大块参数且语义自洽(能被表示好的词也应容易被预测)。风险是两个任务的优化目标耦合——罕见词的嵌入因缺少输出侧梯度而更新不足,可能欠训练。大词表模型对此常有取舍:全共享、不共享、或只共享部分。应用者不必深究选择逻辑,但要知道这个开关存在——遇到"模型认识却说不出口"类怪象时,它是排查点之一。
温故知新
- 双向翻译视角:输入把文本译成张量,输出把向量译回词表,两侧共用同一词汇表;
- 三档分词的取舍:词级词汇爆炸、字符级序列过长,子词级两头兼顾成为主流;
- BPE 及其亲戚:按频率合并片段,WordPiece 换成似然准则,SentencePiece 语言无关;
- 配套铁律:分词器与预训练模型词表必须成对使用,错了就是乱码;
- 嵌入即查表:词表大小行乘模型维度列的参数矩阵,可与输出投影共享权重省参数;
- 输出两步:线性投影到词表维度、softmax 归一,训练接损失、推理接选词;
- 三坑清单:分词器不配套、填充进损失、中文编码与序列膨胀。
输入就绪、输出可期,接下来让机器跑起来:下一节讲训练循环里的损失、优化器与学习率调度。
常见疑问
问:为什么用子词切分而不是词或字符?
答:词级词表太大且永远遇不到生词,字符级序列太长且丢失语义单元。子词(BPE、WordPiece 一类)取中间态:高频词整词保留,低频词拆成有意义的片段,「unbelievable」变成「un+believ+able」,既控制词表规模又免疫生词。Transformer 时代的模型几乎全部子词化,这个看似外围的选择实际决定了模型的词汇泛化能力。
问:嵌入矩阵为什么乘以根号 d_model?
答:为了让嵌入向量的数值尺度与位置编码相当。初始化的嵌入分量方差很小,位置编码分量幅度固定,两者直接相加会让位置信息淹没词义信息。乘上根号 d_model 把嵌入放大到同一量级再相加,是原论文一个容易被忽视但删掉就退化的细节。这类「尺度对齐」的小动作在深度学习里俯拾皆是,理解动机比记住公式重要。