4.2 训练过程与优化器
4.2 训练过程与优化器
本节摘要:Transformer 训练的目标是用交叉熵损失让模型给"正确的下一个词元"分配更高概率,优化器通常选 Adam 或其改进版 AdamW(把权重衰减从梯度中分离)。学习率调度对训练成败影响巨大,原论文方案是 warmup 阶段线性升温、之后按步数平方根倒数衰减。正则化手段包括 dropout(嵌入、注意力权重与前馈输出处)、权重衰减与梯度裁剪。本节把训练循环的每个环节讲透,并给出实践中最值得盯的指标与最常见的故障。
核心问题
阅读完本节,你应当能够:
- 说明交叉熵损失衡量什么、序列总损失如何汇总;
- 描述 Adam 的自适应学习率机制与 AdamW 的改进点;
- 解释 warmup 加衰减调度为何对 Transformer 尤其重要;
- 列出 dropout 在模型中的落点及权重衰减、梯度裁剪的作用;
- 按顺序写出一个完整训练循环的步骤。
一、目标:交叉熵损失
训练的一切围绕一个朴素目标:模型预测的下一词元分布,应当把高概率给真实的那个词。交叉熵损失度量的正是两者的差距——预测分布给真实词的概率越高,损失越低;若给真实词的概率趋近一,损失趋近零。序列级损失通常取所有位置交叉熵的平均。
从梯度视角看,交叉熵加 softmax 的组合对输出分数的梯度恰好是"预测概率减真实指示",形式干净、数值友好,这也是它成为序列生成标准损失的原因。训练日志里的损失曲线换算成困惑度(指数化)后更直观:困惑度五十意味着模型每一步在五十个候选里犹豫,降到二十以内才谈得上可用。
二、优化器:从 Adam 到 AdamW
反向传播算出每个参数的梯度后,由优化器决定怎么走这一步。Transformer 的标配是 Adam:为每个参数维护梯度的指数移动平均(一阶矩,近似均值)与梯度平方的指数移动平均(二阶矩,近似方差),步长按两者之比自适应调整——梯度一直很大的参数步子放小,梯度稀疏的参数步子放大。收敛快、对初始学习率不太挑,是它胜出的原因。
AdamW 是如今更常见的选择。原版 Adam 把权重衰减混在损失里,与自适应步长相互作用后正则效果失真;AdamW 把衰减从梯度里拆出来,直接在参数上按比例收缩,正则化更干净,泛化通常更好。框架里两行配置的差别,值得养成默认选 AdamW 的习惯。
三、学习率调度:warmup 不是可选项
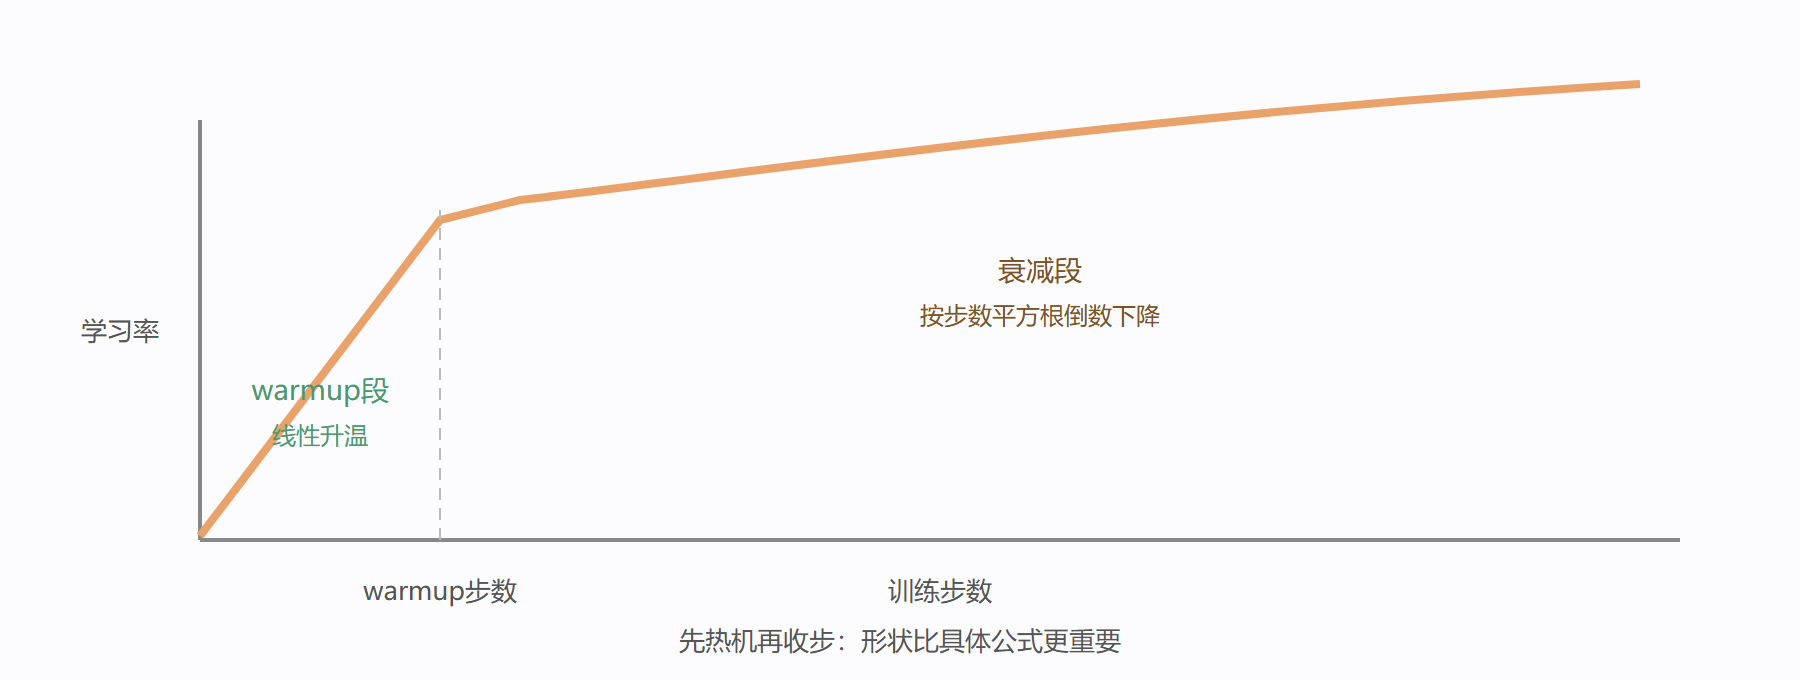
固定学习率在 Transformer 上几乎注定失败,这是它训练上最出名的脾气。原论文的调度方案分两段:先 warmup——训练最初若干步内,学习率从极小值线性升到峰值;之后衰减——按当前步数平方根的倒数(乘以与模型维度相关的系数)逐渐下降。峰值与 warmup 步数是两个关键超参,原论文 warmup 取四千步。
为什么必须 warmup?训练初期,Adam 的二阶矩统计还建立在稀疏样本上,估计噪声大;层归一化与残差的参数也在剧烈变动,稍大的学习率就会把参数推飞,损失不降反升甚至发散。warmup 给统计量与参数一个"热机"阶段,等运行状态平稳再上强度。这也呼应 2.5 节的布局之争:Post-Norm 结构对 warmup 尤其敏感,Pre-Norm 则宽容得多——现代模型敢用更大学习率,部分功劳在布局改进。
衰减段的逻辑相反:训练后期接近极小值,大步长会在谷底来回震荡,逐渐收小步子才能沉下去。除平方根倒数衰减外,线性衰减到零与余弦衰减也是主流选择,效果量级相近,贵在坚持"先升后降"的形状。
warmup 加衰减的学习率曲线
四、正则化三件套
dropout:训练时随机把一部分神经元的输出置零,迫使网络不依赖任何单一通路。Transformer 的落点有三处——嵌入与位置编码相加之后、注意力权重 softmax 之后、每个子层输出处;原论文基础版取零点一。推理时关闭 dropout 并按保留概率缩放,保证期望一致。
权重衰减:按比例惩罚大权重,鼓励模型走平滑解,前文已并入 AdamW 讨论。
梯度裁剪:当梯度的整体范数超过阈值时等比例缩小。处理长序列或训练不稳时梯度偶发爆炸,裁剪把单步最大更新量封顶,防止一步走飞。与 warmup 互补:warmup 防慢性不稳,裁剪防急性爆炸。
| 手段 | 作用位置 | 目的 | 典型取值 |
|---|---|---|---|
| dropout | 嵌入后 注意力权重后 子层输出后 | 防依赖单一通路 | 0.1 至 0.3 |
| 权重衰减 | 优化器内 AdamW式 | 惩罚大权重 促平滑解 | 0.01 量级 |
| 梯度裁剪 | 反传后更新前 | 封顶单步更新 | 范数阈值0.5至1.0 |
| 标签平滑 | 损失计算处 | 防过度自信 | 原论文取0.1 |
标签平滑值得补一句:原论文在损失里把目标的独热分布软化(真实词目标概率设为零点九,余量摊给其他词),抑制模型对单点预测过度自信,翻译任务上实测有小幅提升。属于"改动一行、白捡一点"的便宜买卖。
五、完整训练循环与实战观察
把全部环节串成循环:取一批输入与目标;教师强制前向(3.1 节的右移加掩码);算交叉熵损失(屏蔽填充位);反传梯度;裁剪;AdamW 更新;按调度推进学习率;循环直至预定步数或验证集收敛。训练全程要盯的信号:损失与困惑度曲线(前期应稳定下降)、梯度范数(突发尖峰说明不稳)、学习率曲线(确认调度生效)、验证集指标(判断过拟合时机)。
⚠️ 故障对照三条。训练初期损失不降反升:优先查 warmup 是否配置、学习率峰值是否过大。损失降到某处停滞:查学习率是否忘了衰减、dropout 是否过强、数据是否重复洗牌失效。损失突然跳到天文数字:查数值溢出(混合精度下的损失缩放)、梯度裁剪是否真的生效。Transformer 训练的病大多能从这组信号里定位。
💡 我的经验排序:超参重要性上,学习率调度大于学习率峰值大于批大小大于其他。预算有限的调参时间,全部花在前两项上,回报最高;其余保持社区默认值即可。
六、训练实操的进阶话题
混合精度:快一倍的艺术
用半精度浮点做前向反向、主权重保持单精度,吞吐接近翻倍、显存近乎减半,已是大规模训练标配。代价是数值范围变窄:梯度过小会下溢为零,损失缩放技术因此而生——反传前把损失乘一个大系数、更新前再除回。Transformer 的层归一化对混合精度意外友好(每层主动拉回数值范围),这是它训练能大规模加速的结构红利之一。入门者从框架的自动混合精度开关起步即可,但要知道开关背后是损失缩放在兜底。
数据的排序与课程
训练数据的喂入顺序并非小事。完全随机有益于泛化,但同批内长度差异大会造成填充浪费;按长度分桶后打乱桶序,是吞吐与泛化的常见折衷。进阶做法还有课程学习——由短到长、由易到难安排样本,对部分任务有小幅收益。属于锦上添花,优先级排在调度与稳定性之后。
过拟合的识别与应对
验证损失开始回升而训练损失继续下降,即过拟合信号。应对梯度按序尝试:早停(最便宜)、dropout 上调零点一到零点二、权重衰减加重、数据增强或扩数据。注意 Transformer 的过拟合形态常是"记忆化"——训练集上困惑度极低、换域即崩,因此验证集必须与目标场景同分布,用错分布的验证集会给出误导性的绿灯。
一个可复用的训练配置模板
基础版起步配置:AdamW,峰值学习率在预训练十分之一以下(微调场景)、warmup 数百步、线性或余弦衰减;权重衰减零点零一;梯度裁剪阈值一;dropout 零点一;标签平滑零点一。这组数字覆盖了八成微调场景的合理起点,再按 4.2 节的四信号监控迭代。模板的价值不在最优,而在"每次实验之间的变量受控"——调参科学性的前提是基线稳定。
💡 最后一记预防针:Transformer 训练失败时的第一嫌疑人永远是学习率体系(峰值、warmup、衰减三者之一),第二嫌疑是数据管道(分词、掩码、损失屏蔽)。按此顺序排查,比从模型结构开刀的成功率高得多。
为什么 Transformer 对学习率远比卷积网络敏感?
根子在注意力的全局耦合:一个参数的变动会经注意力权重放大到全序列所有位置,损失曲面的曲率分布极不均匀。卷积网络的局部性与权重共享天然提供了平滑先验,大步长不易翻车;注意力架构没有这层保险,步子稍大就从谷壁弹飞。warmup、衰减、Pre-Norm、残差缩放——第 2 章与本章的这一串"稳定器",本质上都是在给这个高曲率曲面修护栏。理解了这层因果,这些技术就不再是待背的清单,而是同一问题的分头应对。
要点速记
- 目标是交叉熵:让真实下一词元的概率最大化,序列级取平均,可换算困惑度解读;
- AdamW 为默认:自适应步长加分离式权重衰减,比原版 Adam 正则更干净;
- warmup 是刚需:初期统计噪声大、参数未稳,必须线性热机,Post-Norm 下尤其如此;
- 衰减形状是关键:平方根倒数、线性、余弦皆可,先升后降的形状不可省;
- 正则三件套落点:dropout 在三处、权重衰减在优化器、裁剪在更新前,各司其职;
- 标签 smoothing 是便宜买卖:软化独热目标,抑制过度自信;
- 盯四个信号:损失曲线、梯度范数、学习率曲线、验证指标,多数故障可据此定位。
模型训好了,怎么用它生成文本是另一门学问。下一节进入推理阶段:自回归循环与五花八门的解码策略。
常见疑问
问:warmup 到底在暖什么?
答:暖的是训练初期的不稳定。开局时参数随机、梯度方差大、Adam 的二阶矩估计还是空壳,此时学习率大一点就可能把参数推飞。warmup 让学习率从近零线性爬升几千步,等梯度统计稳定后再进入正常调度(原论文是 warmup 后按步数平方根倒数衰减)。可以理解为冬天发动车子先热机——不是一直低速,而是先低速再上高速。
问:为什么调参总是从学习率开始?
答:因为它影响最大且最廉价。学习率差一个数量级,同样的数据与结构能从「正常收敛」变成「完全不学」或「立刻发散」,别的超参很少有这种一票否决权。实践顺序几乎总是:先扫学习率找到可行区间,再动批大小、层数这些贵参数。把力气花在杠杆最长的位置,是调参与做事共通的效率原则。