4.3 YOLOv3
4.3 YOLOv3
本节摘要:YOLOv3 用多尺度预测解决小目标痛点。本节讲它的三个尺度检测、Darknet-53 和多标签分类——精度再上一个台阶。
本节地图
阅读完本节,你应当能够:
- 理解多尺度预测原理
- 说清 Darknet-53 的改进
- 知道多标签分类的意义
概念脉络
一、YOLOv3 的目标
YOLOv2 小目标检测仍弱(网格粗,小目标信息不足)。YOLOv3 的核心改进:多尺度预测,借鉴 FPN 思想,在 3 个尺度特征图上检测。
小目标为什么一直难?因为检测网络的主特征图经过 32 倍下采样,一个小目标在最后特征图上只剩不到 1 个点,检测头根本没有足够信息。YOLOv3 的回答是:不要只在一个尺度上看——用高分辨率特征图负责小目标,用低分辨率负责大目标。
二、多尺度预测
YOLOv3 在 3 个不同分辨率的特征图上预测:
图 4-3 YOLOv3 多尺度预测
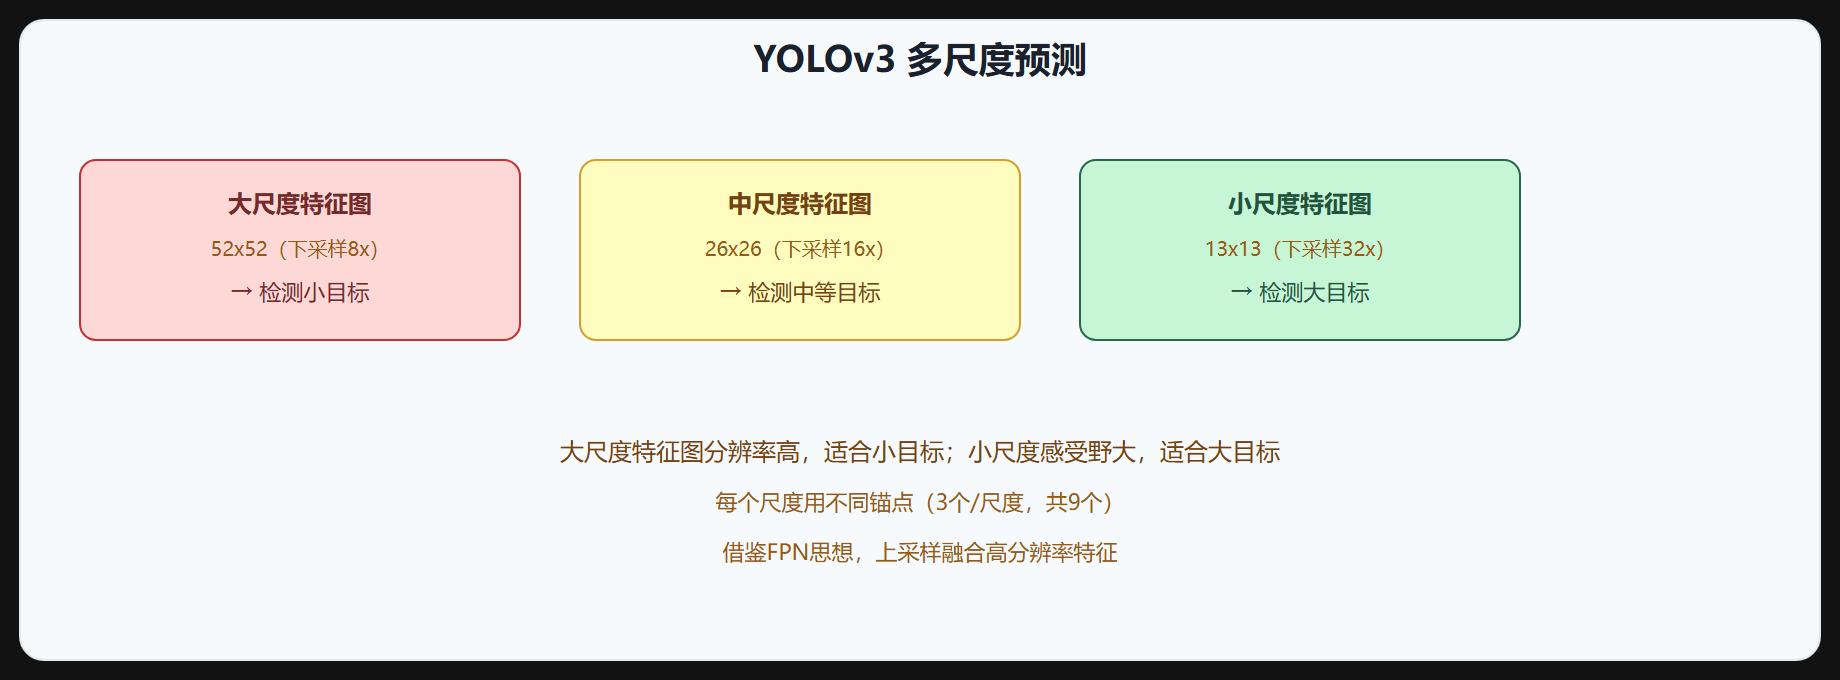
- 大尺度特征图(52x52,下采样 8x):分辨率高,检测小目标
- 中尺度特征图(26x26,下采样 16x):检测中等目标
- 小尺度特征图(13x13,下采样 32x):感受野大,检测大目标
每个尺度用 3 个锚点(共 9 个,通过 K-means 聚类确定)。小目标用高分辨率特征图,信息充足,检测大幅改善。
三、Darknet-53
YOLOv3 用更深的 Darknet-53 骨干:
- 53 层,加残差连接
- 精度比 Darknet-19 高,速度仍快
- 性能与 ResNet-101 相当但更快
Darknet-53 借鉴 ResNet 的残差块,但没有池化层,全程用 stride=2 卷积下采样;结构规整,方便在不同层抽取特征图。论文对比:Darknet-53 的 FLOPs 比 ResNet-101 少一半左右,精度相当——它是"效率优先"的骨干设计典范。
四、多标签分类
YOLOv2 用 softmax 分类,假设每框只一类。YOLOv3 改用逻辑回归(sigmoid),允许一框多类(如"人"+"跑者"),适合有层次标签的场景。
softmax 强制类别互斥(概率和为 1),遇到重叠类别(一个人同时是"人"和"跑者")就打架。sigmoid 对每类独立打分,可以同时给出多个高概率。COCO 的类别本身互斥,这个改动主要是为了泛化和与 WordTree 层次分类的兼容。
五、特征融合
借鉴 FPN,YOLOv3 在小尺度特征图上采样后与大尺度特征图拼接,融合高分辨率细节,提升小目标检测。
# YOLOv3 风格的多尺度检测头 def yolov3_head(c3, c4, c5): """c3/c4/c5 是骨干不同层的特征图,分辨率递减""" out5 = detect_head(c5) # 13x13,大目标 up4 = upsample(c5) # 上采样到 26x26 x4 = torch.cat([c4, up4], dim=1) # 拼接融合 out4 = detect_head(x4) # 26x26,中目标 up3 = upsample(x4) # 上采样到 52x52 x3 = torch.cat([c3, up3], dim=1) # 拼接融合 out3 = detect_head(x3) # 52x52,小目标 return out3, out4, out5
这个"深层上采样 + 与浅层拼接"就是 FPN 的基本动作,YOLOv3 把它应用到了 YOLO 架构里,从此多尺度成为检测器标配。
六、性能
| 指标 | YOLOv2 | YOLOv3 |
|---|---|---|
| COCO mAP | 48 | 55.3(320x320) |
| 57.9(608x608) | ||
| 速度 | 67 FPS | 35 FPS(608) |
YOLOv3 精度提升(COCO mAP 48→57.9),小目标显著改善,速度仍可实时。注意输入分辨率对精度影响很大:同样模型,320 输入 mAP 55.3,608 输入 57.9——分辨率是"免费"的精度来源,代价是速度。工程上常备两档输入:上线用 640 保证精度,高并发场景降到 416 或 320 换吞吐。
七、三个版本
YOLOv3 提供不同精度速度的版本:
- YOLOv3-SPP:加 SPP,精度更高
- YOLOv3-tiny:轻量版,超快但精度低,移动端
- YOLOv3-ultralytics:社区改进版(Ultralytics,YOLOv5 前身)
八、易错点与调参
多尺度预测带来一个工程问题:3 个尺度的损失如何加权?YOLOv3 简单地对各尺度损失求平均,小目标层的损失没有被放大。后来 YOLOv5 等版本按尺度分配不同权重,或引入"小目标损失加权"策略,进一步改善小目标。另外,锚点虽然是 K-means 聚出来的,但聚类数据集要和实际业务数据分布一致,换数据集必须重新聚类,否则锚点失配直接掉点。
⚠️ 多尺度的关键:小目标用高分辨率特征图(下采样少),大目标用低分辨率(感受野大)。这是 YOLOv3 解决小目标痛点的核心,也是现代检测器标配。
💡 关键直觉:YOLOv3 用多尺度预测(3 尺度特征图,小目标用高分辨率)解决小目标痛点。Darknet-53 骨干,多标签逻辑回归。COCO mAP 48→57.9,小目标大幅改善。
一节小结
- 目标:解决小目标痛点。
- 多尺度预测:3 尺度特征图(52/26/13),大尺度检小目标,小尺度检大目标,每尺度 3 锚点。
- Darknet-53:53 层加残差,精度高速度可,比 ResNet-101 快。
- 多标签分类:sigmoid 逻辑回归,一框可多类。
- 特征融合:FPN 思想,上采样融合高分辨率特征。
- 性能:COCO mAP 48→57.9,小目标改善,仍实时。
- 工程注意:尺度损失加权、锚点随数据重新聚类。
- 版本:SPP(高精度)、tiny(轻量)、ultralytics(社区)。
下一节看 YOLOv4 的工程优化集成。