4.4 YOLOv4
4.4 YOLOv4
本节摘要:YOLOv4 集成大量"免费赠品"和"特价品"优化技术,单阶段精度达到 SOTA。本节讲它的 CSPDarknet、SPP、PANet 和 BoF/BoS——工程优化的集大成。
上手前先明确
阅读完本节,你应当能够:
- 理解 BoF 和 BoS 的概念
- 说清 YOLOv4 的架构改进
- 列举主要优化技术
概念脉络
一、YOLOv4 的定位
YOLOv3 之后,YOLO 原作者停更。YOLOv4 由 Alexey Bochkovskiy 维护,目标:集成近年所有有效优化技术,在单 GPU 上训练出 SOTA 单阶段检测器,兼顾精度和速度。
YOLOv4 的价值不在单一创新,而在系统集成。论文把 2018-2020 年目标检测领域散落的技巧(数据增强、损失、激活、归一化、NMS、结构设计)做了大规模消融实验,挑出"免费"和"高性价比"的组合,打包成一个可直接训练的配方。它是"工程优化即创新"的宣言书,也是后来大量工业实践的直接参考。
二、架构改进
图 4-4 YOLOv4 架构
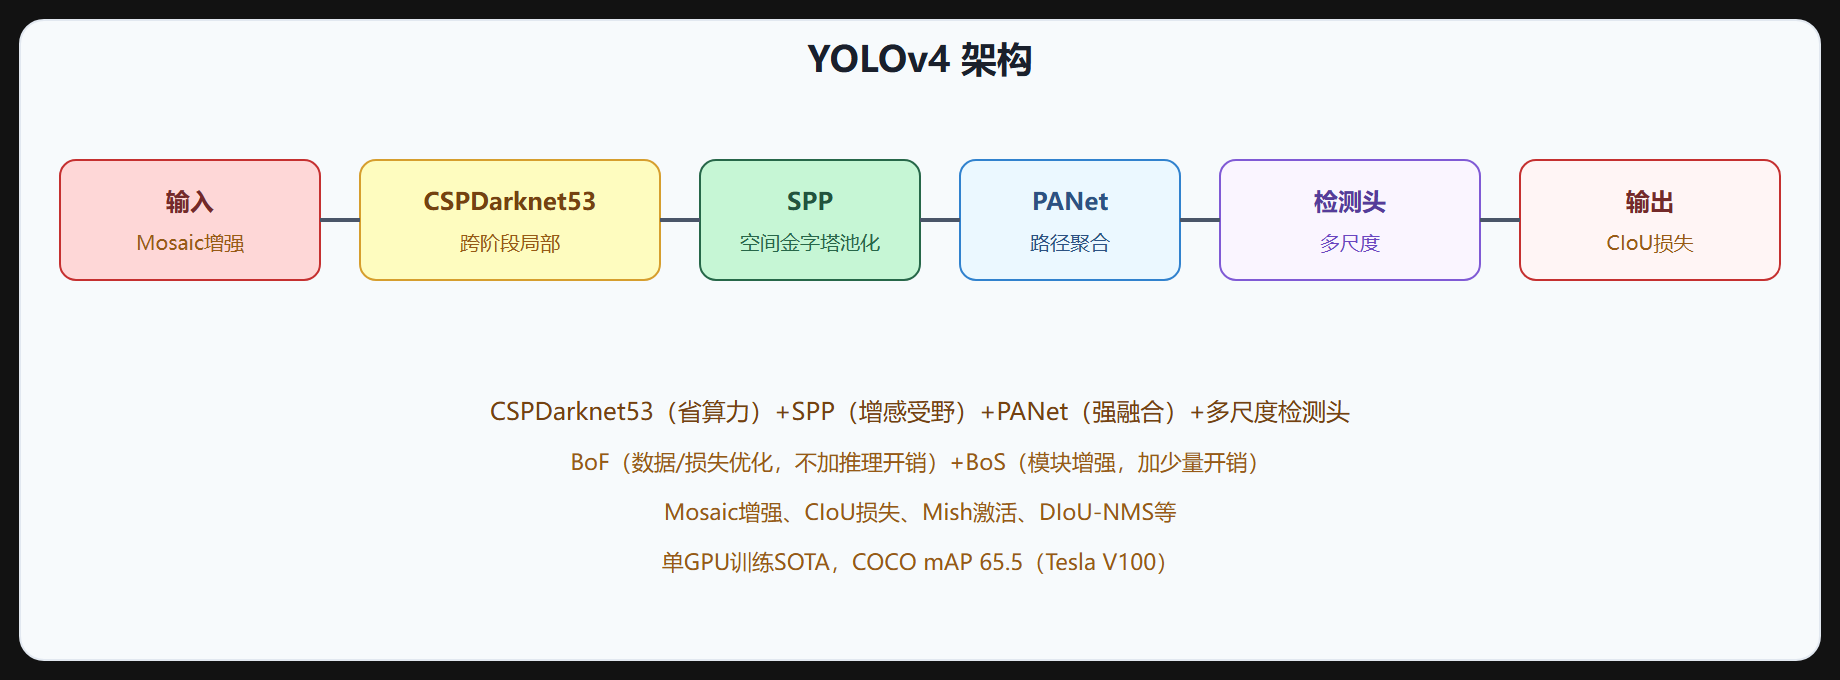
| 组件 | 改进 |
|---|---|
| Backbone | CSPDarknet53(跨阶段,省算力) |
| Neck | SPP(增感受野)+ PANet(强融合,比 FPN 多自下而上) |
| Head | 多尺度检测(同 v3) |
| 损失 | CIoU(重叠+距离+长宽比) |
三、BoF 和 BoS
YOLOv4 把优化技术分两类:
Bag of Freebies(免费赠品)
只影响训练,不增加推理开销:
- Mosaic 数据增强:4 图拼接(v4 首创)
- CutMix:裁剪混合
- DropBlock:结构化 dropout
- CIoU 损失:更准的框回归
- CmBN:跨 mini-batch 归一化
- 余弦退火:学习率调度
- 标签平滑:防过拟合
Bag of Specials(特价品)
增加少量推理开销但提升明显:
- Mish 激活函数:平滑非单调,比 ReLU 好
- DIoU-NMS:考虑中心距离的 NMS
- SPP:空间金字塔池化
- PANet:路径聚合
BoF 与 BoS 的区分标准是推理时是否增加开销。这个分类方法本身很有价值:工程选型时先上免费赠品,再按算力余量上特价品。
四、CSPDarknet53
CSPDarknet53 引入 CSPNet 思想:把特征图分两部分,一部分走主干,一部分跨阶段直接拼接,减少计算量同时保持精度。
# CSP 残差块:通道切半,一半走残差主干,一半直连 def csp_resblock(x, n_blocks): x1, x2 = torch.chunk(x, 2, dim=1) for _ in range(n_blocks): x1 = res_block(x1) # 残差主干 return torch.cat([x1, x2], dim=1) # 跨阶段拼接
通道切半意味着主干计算量减半,拼接又保留了全部信息,还丰富了梯度路径——CSP 同时优化了算力和表达能力。
五、SPP 与 PANet
- SPP:在骨干后用不同大小池化核池化再拼接,增加感受野,分离上下文特征
- PANet:在 FPN 自上而下基础上加自下而上路径,增强特征融合,小目标提升
SPP 用 1x1、5x5、9x9、13x13 四种池化核并行池化再拼接,让同一个特征点同时看到不同范围的上下文,大目标受益明显。PANet 在 FPN"深层往浅层传"之后,再加一条"浅层往深层传"的路径,小目标位置信息能更直接地流到深层,配合 YOLOv3 的多尺度头,小目标检测进一步改善。
六、性能
| 指标 | YOLOv4 |
|---|---|
| COCO mAP | 65.5(Tesla V100) |
| 速度 | 38 FPS(65.5 mAP) |
| 训练 | 单 GPU 可训 |
YOLOv4 在单 GPU 上达到 SOTA,兼顾精度速度,是工程优化的集大成。单 GPU 可训这点对工业界极其重要:不需要大规模分布式集群,普通工作站在合理时间内就能复现。
七、意义
YOLOv4 证明了系统化集成优化技术的价值:不是单一创新,而是把近年所有有效技术(数据增强、损失、激活、NMS、架构)整合,达到 SOTA。这开启了"工程优化即创新"的阶段。
八、一个对比:免费赠品 vs 特价品怎么选
| 场景 | 推荐组合 |
|---|---|
| 算力紧张 | 只上 BoF:Mosaic、CIoU、余弦退火、标签平滑 |
| 算力充足 | BoF + BoS:加 Mish、SPP、PANet、DIoU-NMS |
| 极致精度 | 全量 + 更大输入分辨率 + 更长训练 |
BoF 里 Mosaic、CIoU、余弦退火几乎是"白嫖"的收益,任何项目都建议开启;BoS 里的 Mish、PANet 提升明显但增加推理时间,按时延预算取舍。YOLOv4 论文还系统测过"哪种增强配哪种损失"的兼容性:例如 CIoU 与 DIoU-NMS 搭配在密集场景最稳,Mosaic 与小 batch 训练天然互补——这些组合经验比单个技巧本身更值钱,直接抄作业即可。
⚠️ BoF vs BoS:BoF(免费赠品)只影响训练不加推理开销(数据增强、损失),BoS(特价品)加少量开销但提升明显(激活、NMS、模块)。部署时 BoF 不影响速度。
💡 关键直觉:YOLOv4 集成 BoF(免费赠品,训练优化不加推理开销)+BoS(特价品,少量开销提升明显)。CSPDarknet53+SPP+PANet+CIoU。单 GPU 训 SOTA,开启工程优化即创新阶段。
核心回顾
- 定位:集成近年所有有效优化,单 GPU 训 SOTA。
- 架构:CSPDarknet53(省算力)+SPP(增感受野)+PANet(强融合)+多尺度检测头+CIoU。
- BoF(免费赠品):Mosaic、CutMix、DropBlock、CIoU、CmBN、余弦退火、标签平滑,不加推理开销。
- BoS(特价品):Mish 激活、DIoU-NMS、SPP、PANet,少量开销提升明显。
- 性能:COCO mAP 65.5,38 FPS,单 GPU 训。
- 选型:算力紧只上 BoF,算力足加 BoS。
- 意义:系统化集成优化即创新,开启工程优化阶段。
下一节看 YOLOv5 的工程化。