4.5 YOLOv5
4.5 YOLOv5
本节摘要:YOLOv5 由 Ultralytics 发布,非原作者维护,主打工程化和易用。本节讲它的工程改进——让 YOLO 真正好用易部署。
本节导读
阅读完本节,你应当能够:
- 理解 YOLOv5 的工程化定位
- 说清多种模型尺寸
- 知道 YOLOv5 的易用特性
概念脉络
一、YOLOv5 的定位
YOLOv5 由 Ultralytics 公司发布,非 YOLO 原作者维护,曾引发"是否算 YOLO"的争议。但它的工程化做得极好,训练部署便捷,社区活跃,成为工业界最常用的 YOLO 版本之一。
YOLOv4 和 YOLOv5 的"竞争"是 2020 年社区最热闹的话题:v4 是原作者团队(Darknet 框架),v5 是 Ultralytics(PyTorch)。两者架构理念接近,但 v5 胜在工程体验——这也是"工程化能力是生产力"的典型案例。
二、PyTorch 实现
YOLOv4 用 Darknet 框架(C),YOLOv5 完全基于 PyTorch,方便研究和部署,生态友好。
PyTorch 让 YOLOv5 的学习曲线和集成成本大幅下降:可以用熟悉的 nn.Module 改结构、用 torch.jit/onnx 导出、用 HuggingFace 生态加载权重。Darknet 的 C 代码性能好但二次开发门槛高,v5 用"性能略降、易用性大涨"换来了社区繁荣。
三、多种模型尺寸
图 4-5 YOLOv5 模型尺寸
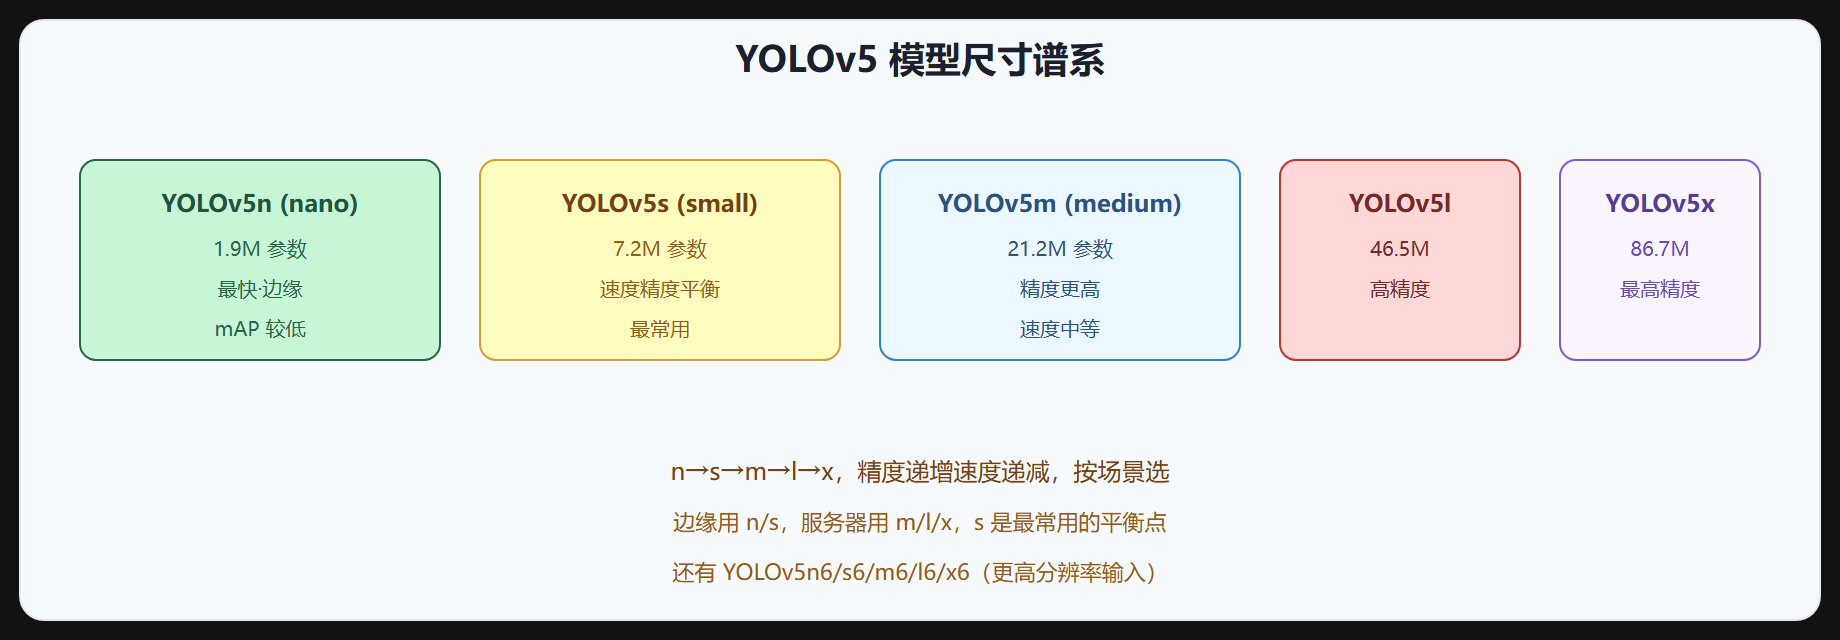
YOLOv5 提供 5 种尺寸:
| 模型 | 参数 | 适合 |
|---|---|---|
| YOLOv5n | 1.9M | 边缘设备 |
| YOLOv5s | 7.2M | 速度精度平衡,最常用 |
| YOLOv5m | 21.2M | 更高精度 |
| YOLOv5l | 46.5M | 高精度 |
| YOLOv5x | 86.7M | 最高精度 |
按场景选:边缘用 n/s,服务器用 m/l/x。同系列不同尺寸共享大部分超参,可以从 s 调好数据后按比例放大到 m/l/x,省去重复调参。
四、工程化特性
| 特性 | 说明 |
|---|---|
| AutoAnchor | 自动计算最佳锚点 |
| 超参进化 | 遗传算法搜索超参 |
| 一键训练 | python train.py --data coco.yaml |
| 导出多格式 | ONNX、TensorRT、CoreML、TFLite |
| 数据集管理 | YAML 配置,自动下载 |
| 推理优化 | SPPF(快速 SPP)、Focus 切片 |
五、架构细节
- Focus 层:输入切片,高宽转通道,减少计算
- CSP 结构:Backbone 和 Neck 都用 CSP
- SPPF:SPP 的快速版,串接池化加速
- PANet:特征融合(同 v4)
# SPPF:串接 3 个 5x5 池化,等价 5/9/13 感受野,但计算量小得多 def sppf(x, k=5): y1 = F.max_pool2d(x, k, stride=1, padding=k // 2) y2 = F.max_pool2d(y1, k, stride=1, padding=k // 2) y3 = F.max_pool2d(y2, k, stride=1, padding=k // 2) return torch.cat([x, y1, y2, y3], dim=1)
SPPF 是 SPP 的工程优化:三个 5x5 池化串接,等价于 5x5、9x9、13x13 三个并行池化,但计算量约为原来的三分之一。这类"等价但更快"的小优化,是 YOLOv5 工程风格的代表。
六、数据增强
YOLOv5 内置丰富增强:
- Mosaic(最后 15 epoch 关闭)
- HSV 色彩扰动
- 随机翻转、缩放、平移
- MixUp(可选)
七、易用性
# 训练 model = torch.hub.load('ultralytics/yolov5', 'yolov5s', pretrained=True) # 推理 results = model('bus.jpg') results.pandas().xyxy[0] # 输出 x1,y1,x2,y2,conf,class
# 自定义数据训练只需一个 yaml + 一行命令 # python train.py --data mydata.yaml --weights yolov5s.pt --img 640
YOLOv5 的易用性是它工业界流行的关键——从训练到部署全流程简化。数据格式用 YOLO 的 txt 标注,几十行 Python 就能把自定义数据集跑起来,配合 TensorBoard/W&B 可视化,几乎是"开箱即用"。
八、性能
| 模型 | COCO mAP | 速度 |
|---|---|---|
| YOLOv5s | 37.4 | 5.3ms |
| YOLOv5m | 45.4 | 8.4ms |
| YOLOv5l | 49.0 | 10.9ms |
| YOLOv5x | 50.7 | 14.1ms |
性能数字说明:n 到 x 是同架构的规模缩放,mAP 从 28 到 50.7,速度从 2ms 到 14ms。选型就是在这条曲线上找"够用且最快"的点。实际部署时还可以用输入分辨率微调:同一模型 640 输入比 416 输入通常高 2~4 个点 mAP,代价是推理时间增加约一半。
九、争议与价值
YOLOv5 因非原作者维护有争议,但它的工程价值不可否认:
- 让 YOLO 真正好用易部署
- 社区活跃,持续更新
- 工业界广泛采用
争议的核心是命名权:YOLOv5 与 v4 几乎同期发布,且没有对应论文(只有仓库),"是否配叫 YOLO 的第五代"一直有争论。但社区用脚投票——易用性、文档、预训练权重、部署工具链的完整度,让大量团队选择 v5 作为生产基线。这也提醒我们:检测模型的竞争力不只在算法精度,还在周边生态。
十、工程排错要点
问:训练后小目标检测差? 检查输入分辨率是否太低、Mosaic 是否在末期被关闭、锚点是否针对数据重新聚类。问:导出 ONNX 报错? 检查动态尺寸设置和算子的 opset 版本,Focus 层和上采样容易出兼容问题。问:精度上不去? 先确认数据质量(标注错位、类别不平衡),再调增强强度和训练轮数,最后才动网络结构。
⚠️ 常见误区:纠结 YOLOv5 是否"正统"。工程上好用才是关键,YOLOv5 的易用性和部署友好性让它成为工业界主流,争议不影响实用价值。
💡 关键直觉:YOLOv5 主打工程化易用:PyTorch 实现、5 种尺寸(n/s/m/l/x)、一键训练推理、多格式导出。虽非原作者维护有争议,但工业界广泛采用。
本节速览
- 定位:Ultralytics 发布,非原作者,主打工程化易用。
- PyTorch:完全 PyTorch,生态友好。
- 5 种尺寸:n(1.9M 边缘)→s(7.2M 平衡)→m→l→x(86.7M 高精度)。
- 工程特性:AutoAnchor、超参进化、一键训练、多格式导出(ONNX/TensorRT)、YAML 配置。
- 架构:Focus 切片、CSP、SPPF、PANet。
- 增强:Mosaic(末期关闭)+HSV+翻转+MixUp。
- 性能:s 37.4 mAP/5.3ms,x 50.7 mAP/14.1ms。
- 价值:好用易部署,工业界主流,争议不影响实用。
下一节看 YOLOv6/v7/v8 最新进展。