5.3 Actor-Critic 架构:A2C 与并行优势
5.3 Actor-Critic 架构:A2C 与并行优势
本节摘要:Actor-Critic 把两个学习器装进同一个智能体:actor 维护策略 π(a|s;θ),critic 维护价值估计 V(s;w),critic 用 TD 误差在线评价 actor 的动作,actor 用优势加权的策略梯度更新自己。它同时治好 REINFORCE 的三大病中的两个——方差(6.2 的基线有了在线来源)与等待整条轨迹(δ 一步可得)。A2C 补上第三块:多环境并行采样,让批数据既相关低又够量。本节讲清两个网络的分工与耦合、更新节奏,以及共享底座时的实现细节。
两个网络如何分工
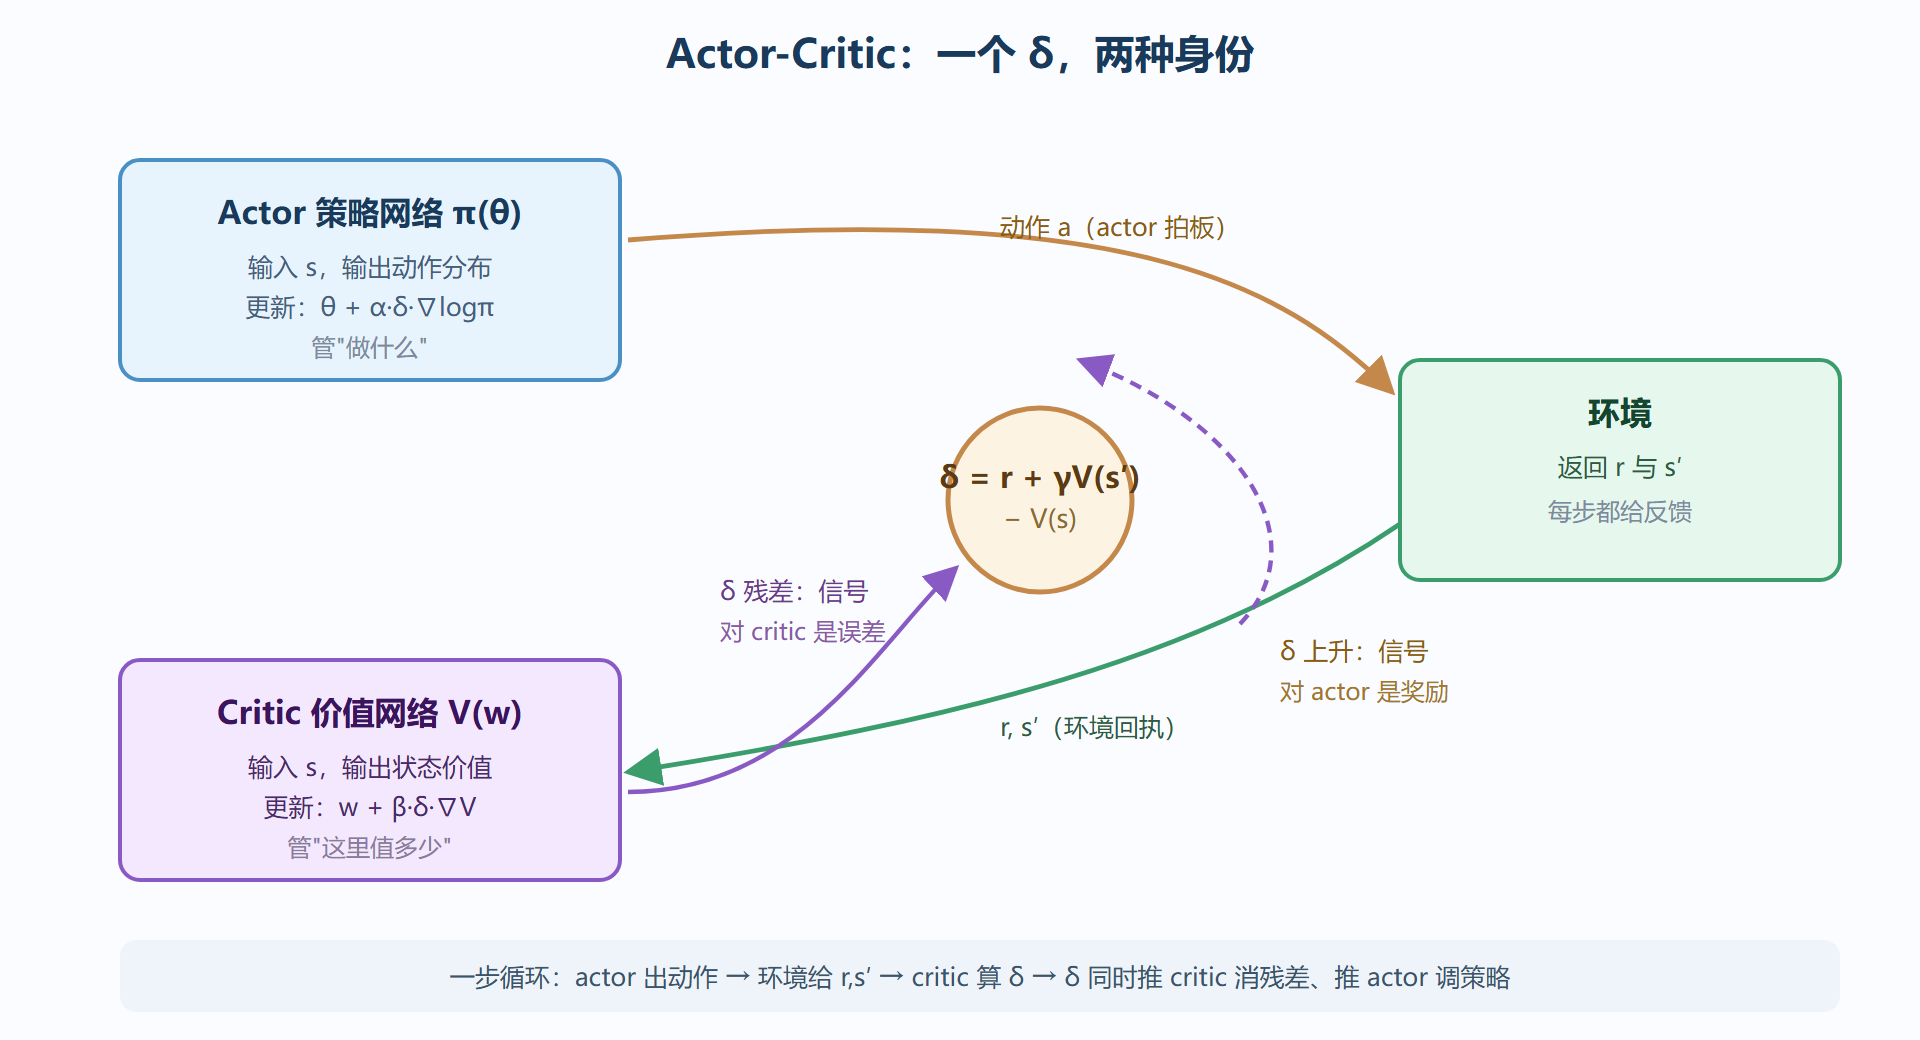
把 6.2 留下的缺口填上:优势 A = Q − V 里的 V 从哪来?REINFORCE 只能等回合结束用 G;Actor-Critic 的答案是让 critic 用 3.3 节的 TD(0) 在线维护 V(s;w)——每走一步就更新:
w ← w + β · δ · ∇_w V(s;w),其中 δ = r + γV(s';w) − V(s;w)
actor 随即用这个 δ 当优势的近似,做梯度上升:
θ ← θ + α · δ · ∇_θ log π(a|s;θ)
两条更新式共享同一个 δ,但方向相反:对 critic,δ 是"价值估计的残差",要压到零;对 actor,δ 是"这次动作好坏的信号",是燃料。同一个数字,一个是误差、一个是奖励——理解了这层双重身份,Actor-Critic 的所有变体都能看懂。注意 actor 的更新式里 G 被换成了 δ:期望从"无偏"退成"有偏(依赖 critic 的准确性)",换来方差骤降与即时更新——偏差换方差的老交易,第 3 章见过一次,这里再成交一次。
两个网络的学习速度必须匹配:critic 太慢,δ 信号陈旧,actor 学到的是上个版本的评价;critic 太快(比如 β 过大),δ 里全是价值估计的抖动,actor 被噪声鞭打。经验上 β 与 α 同量级或略大,且价值网络的输出层学习率可单独放大。这是 Actor-Critic 真正的调参难点——单网络超参多了一倍,且互相耦合。
图:Actor-Critic 双角色架构与一步数据流
A2C:并行采样补上最后一块拼图
Actor-Critic 还剩一个软肋:单条轨迹上的相邻样本强相关,一步一更新的梯度抖动大、算力还跑不满。A2C(同步优势 Actor-Critic)的思路是开 N 个环境副本并行跑,各自用同一份策略;攒满 n 步(典型 5 到 20 步)后把所有副本的经验汇成一个大批次,一次性计算优势与梯度、同步更新所有 worker 的网络,再继续。三个收益:批次内的样本来自不同环境副本,相关性大幅稀释;GPU 的批量计算被喂饱;探索天然多样(各副本的随机状态不同)。历史上的 A3C 用异步无锁更新抢了先,后来实践发现同步版(A2C)在 GPU 上更稳更快,于是 A2C 成为标准讲法——异步只是并行的一种实现姿势,不影响概念结构。
一个完整的更新回合(n 步滚动)伪代码:
# A2C 的 n 步滚动更新(worker 视角) states, actions, rewards = [], [], [] s = env.reset() for t in range(n_steps): # 攒 n 步(如 5~20) dist = actor(s) a = dist.sample() s2, r, done = env.step(a) states.append(s); actions.append(a); rewards.append(r) s = s2 if done: s = env.reset() R = V(critic(s)) if not done else 0.0 # bootstrap:n 步后状态的估值 advantages, returns = [], [] for r in reversed(rewards): # 倒算 n 步回报与优势 R = r + gamma * R returns.insert(0, R) for G, st in zip(returns, states): advantages.append(G - V(critic(st))) # 或用 GAE 更精细 loss_actor = -(dist.log_prob(actions) * advantages).mean() # 优势加权 logπ loss_critic = advantages_tensor.pow(2).mean() # 优势平方即价值误差 loss_entropy = -dist.entropy().mean() # 熵正则防过早收敛 loss = loss_actor + 0.5 * loss_critic + 0.01 * loss_entropy optimizer.zero_grad(); loss.backward(); optimizer.step()
三处细节值得点名。bootstrap 的价值项:n 步末尾若未终止,用 critic 的 V(s) 补上尾巴——这是 3.3 节 N 步 TD 的直接应用,让"等整条轨迹"彻底成为历史。熵正则:给策略分布的熵加一个负损失项,防止策略过早缩成确定性(探索僵死),系数 0.001 到 0.01 量级。共享底座:实践中 actor 与 critic 常共享前几层网络(尤其感知层),只在末端分头出策略头与价值头,一次前向两份输出——上式的 loss 正是两项相加一次反向,共享层同时服务两个目标,偶尔也带来梯度互扰(价值头的大梯度冲刷策略头),损失项加权(如 0.5)就是为此预留的旋钮。
收束:两路线在此合流
回头看本族谱系:REINFORCE 是纯策略方法(等 G、无基线);加基线是批次 REINFORCE with baseline;基线在线化就是 Actor-Critic;并行化就是 A2C;把 n 步优势的 λ 加权做成 GAE、再把策略更新的幅度管起来,就是第 5 章的 PPO——技术演进没有跳跃,每一代只解决上一代的一个具体痛点。价值路线(Q-Learning/DQN)与策略路线在 Actor-Critic 处合流:actor 管探索与决策,critic 管评估与信用分配,两者像探险家与地图绘制员,缺谁都不行。
⚠️ 高频事故:actor 学飞了而 critic 还趴着——表现为策略概率剧烈震荡、回报崩盘。先降 α 或升 β,再考虑减小 n 步数;两者常常是同一根学习率问题的两张面孔。
- critic 在线维护 V,δ 双重身份:critic 的残差、actor 的奖励。
- actor 更新有偏(依赖 critic),换来低方差与即时更新——老交易的又一次成交。
- A2C 用并行环境稀释相关性、喂饱算力;同步优于异步成为默认。
- 熵正则防策略过早确定性化;共享底座省算力但需损失加权防梯度互扰。
- 系谱:REINFORCE → +基线 → AC → A2C → (GAE+约束) = PPO,每代只治一个痛点。