5.4 信任域思想:从 TRPO 到 PPO 的裁剪目标
5.4 信任域思想:从 TRPO 到 PPO 的裁剪目标
本节摘要:策略梯度是一次一阶近似:它告诉你"在当前策略附近,往哪边走一点会更好"。一旦步子迈大,近似失效——梯度是用旧策略的数据算的,数据对新策略已经不可信。信任域方法把这个直觉工程化:限制新策略与旧策略的距离,只在小邻域内相信数据。TRPO 用 KL 散度约束加二阶方法实现,正确但笨重;PPO 把约束改写进目标函数的 clip 谓词,一阶方法即可求解,效果几乎不损失。本节讲清这条演化线,并画出裁剪目标的分段形状。
一、更新幅度为什么危险
先把事故的因果链摆直。第 5 章的更新式 ∇J ≈ E[∇logπ·A] 有个隐含前提:期望是对当前策略的数据取的。更新一步之后策略变成 π_new,但手上的数据还是 π_old 产生的——梯度公式外推了。小步幅下外推误差可忽略(泰勒展开的一阶项在原点附近最准);大步幅下,旧数据会说谎。说谎的方式很阴险:旧策略很少访问的动作区域,新策略一旦把概率挪过去,那里根本没有数据说话,优势估计全凭 critic 一张嘴,而 critic 本身也只是旧分布下训练的。结果常常是:一步大更新把概率质量推进无数据区,策略性能跳水,且由于 critic 也被污染,下一批数据更糟——恶性循环,训练曲线表现为"突然崩塌",而不是缓缓变差。
vanilla 策略梯度在 Atari 风格任务上的经典死法正是如此:奖励爬升数万步,一次偶然的大梯度后断崖式归零。这不是学习率能完全解决的——调小学习率只是降低崩的概率,同时拖慢一切。需要的是结构性保证:无论数据说什么,更新后的策略不许离数据产生时的策略太远。
二、ratio:旧数据评估新策略的杠杆
量化"新旧策略差多远"的钥匙是重要性采样比值:
ratio_t(θ) = π_θ(a_t|s_t) / π_θ_old(a_t|s_t)
它衡量"新策略给这个动作的概率,是旧策略的多少倍"。ratio=1 表示没变;ratio=1.5 表示新策略把该动作的概率放大了 1.5 倍。策略梯度目标可以改写成它的函数:
L(θ) = E[ ratio_t(θ) · A_t ]
这形式看着只是换皮,杠杆效应却藏在分母里:数据是固定的(π_old 采的),θ 变化全部体现在分子上。当某样本的 A_t 是正的(这个动作被评价为好),梯度会推高 π_θ(a|s),ratio 变大,L 变大——一切都好,直到 ratio 被推得太远:此时该样本所在区域可能已是旧策略几乎没探索过的地方,A_t 的可信度存疑,而 L 仍在据此指示"继续放大"。危险信号精确地落在 |ratio| 偏离 1 的程度上——这就是 PPO 动刀的位置。
三、TRPO:先把约束做对,再谈好用
TRPO(信任域策略优化)给出教科书级的正确做法:在"新策略相对旧策略的 KL 散度 ≤ δ"的约束下最大化 L(θ)。KL 散度度量两个分布的距离,δ(典型 0.01)就是信任域半径。数学上它把每步更新限制在一个策略空间的小球内,理论保证单调改进——每一步都不会更差。代价是实现复杂度:带约束的优化要用二阶信息(Fisher 信息矩阵的共轭梯度近似),代码数百行,每步更新的计算量大,且二次求解的近似在深度网络上并不总稳。工程界对它的态度务实:思想伟大,实现劝退。
四、PPO:把约束写成一行 min
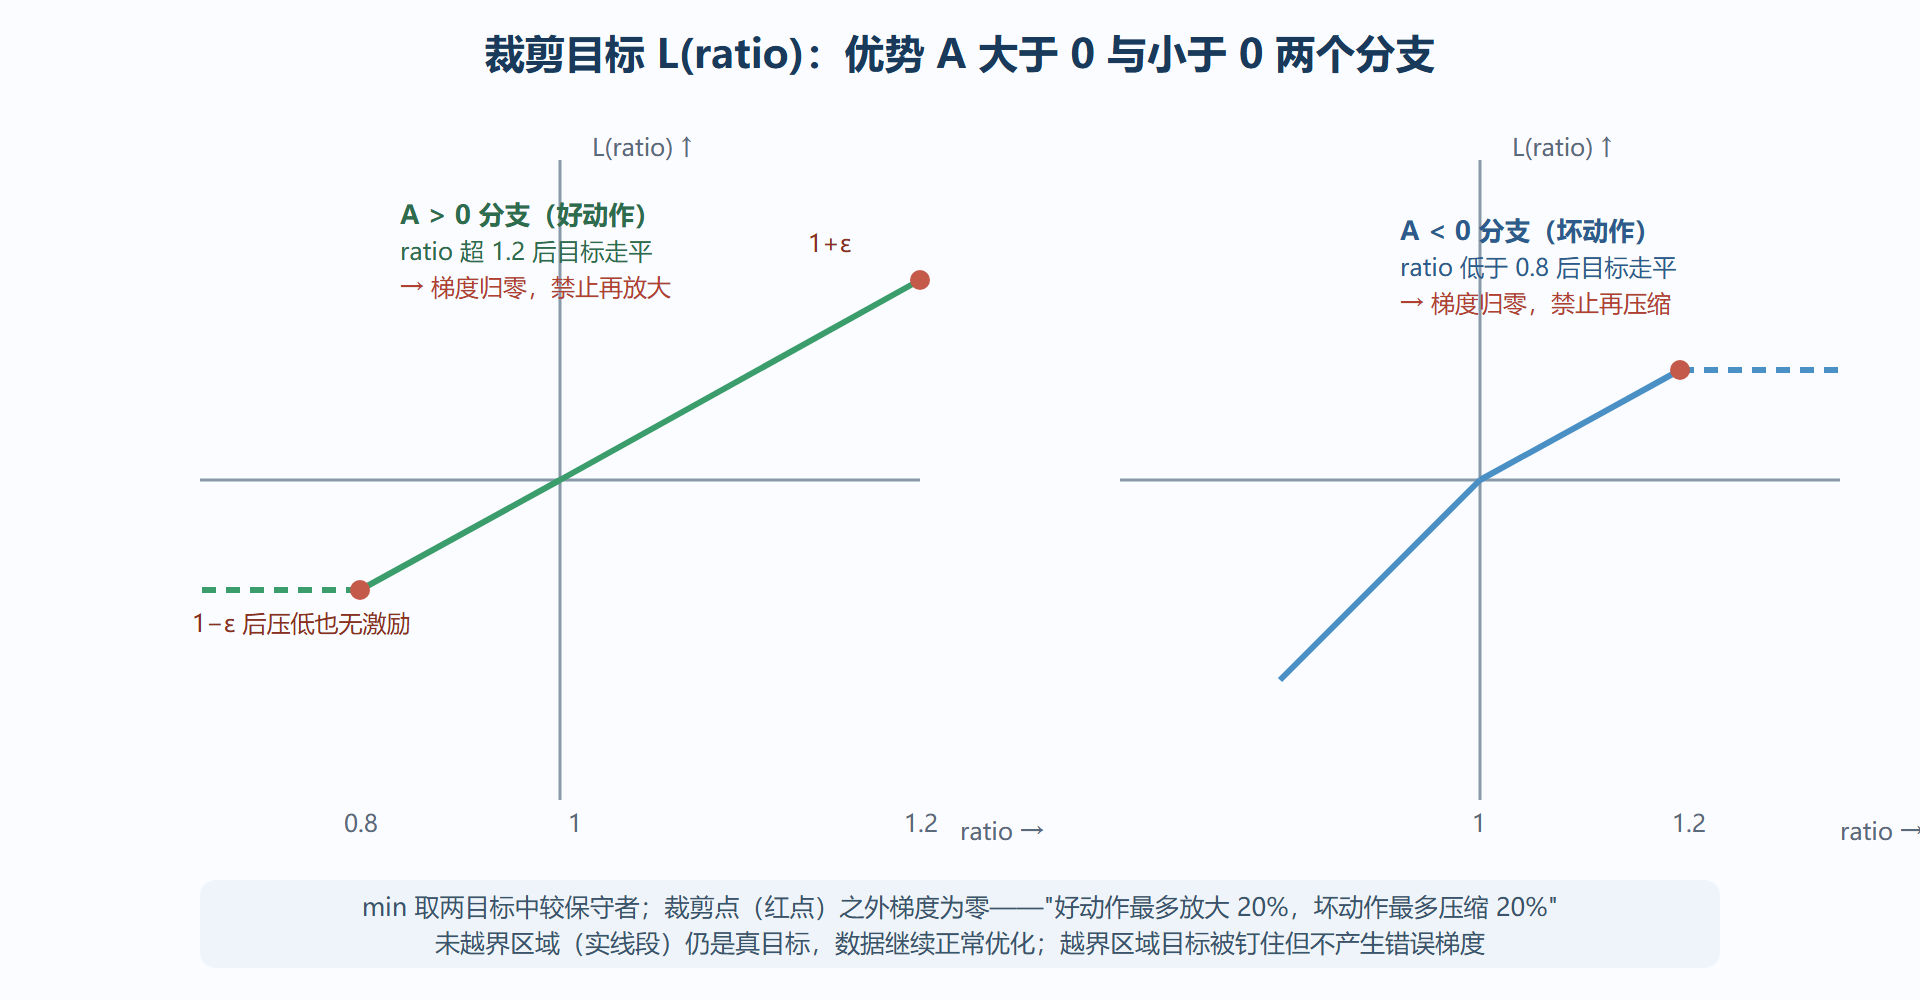
PPO(近端策略优化)的观察一针见血:与其在外面加约束,不如让目标函数自己"到顶"——ratio 偏离 1 超过裁剪范围 ε(典型 0.2),就不再给梯度激励:
L_clip(θ) = E[ min( ratio·A, clip(ratio, 1−ε, 1+ε)·A ) ]
min 的语义分两支。A>0(好动作):目标取 ratio·A 与 clip 后的 1.2·A 的较小者——ratio 超过 1.2 后,再推高概率也不加奖励,梯度归零,等于说"好动作可以放大,但最多放大 20%"。A<0(坏动作):目标取 ratio·A 与 clip 后的 0.8·A 的较大者——ratio 低于 0.8 后,再压低概率也不再有激励,压制的力度被锁死。注意 clip 不改数据、不加惩罚,只是撤走继续偏离的动机;而且 min 保证未被裁剪的分支仍能用真实数据继续优化,被裁剪的部分梯度为零但目标不被错误信号污染。
图:PPO 裁剪目标分段图——梯度在边界上消失
五、PPO 相对 TRPO 的工程取舍
一张小表收束取舍:TRPO 用二阶方法加显式 KL 约束,每步更新昂贵、实现数百行,理论保证最漂亮;PPO 用一阶方法加 clip 软约束,Adam 一把梭、核心损失十几行,单调改进的保证降级为"实践中极少崩"。几乎所有大规模应用(包括 RLHF 里对语言模型的策略训练)选了 PPO——不是因为理论更强,而是因为一个能每天跑的稳定算法胜过一个只能瞻仰的最优算法。这个取舍本身值得记住:工程算法的价值公式里,实现的可靠性是高权重项。
💡 一个追问:既然 clip 范围外的梯度是零,策略怎么"回调"出信任域?答:靠 KL 早停或熵正则等辅助项,以及下一批新数据(旧 batch 上的越界只影响本批的多轮更新)——PPO 的完整实现通常配一个 KL 监控,超阈值就提前终止本轮 epochs。
- 大更新 = 用旧数据外推新策略,崩塌来自无数据区的一步跨入。
- ratio 是新旧策略在同一动作上的概率倍数,是目标函数里唯一的"新意"。
- TRPO 用 KL 约束二阶求解,正确而笨重;PPO 用 min+clip 把约束写进目标,一阶即可。
- clip 谓词的语义:好动作最多放大 1+ε 倍,坏动作最多压缩到 1−ε 倍。
- 工程价值公式:可每日运行的稳定算法 > 只能瞻仰的最优算法。
从 KL 视角再看 clip:软约束的语义
clip 与 KL 约束的关系值得再拧一圈,因为"clip 不惩罚越界"这件事初见常被当作缺陷。换个视角:KL 约束是对策略参数的硬约束——越界即非法,优化器必须回头;clip 是对激励的截断——越界不奖励也不惩罚,策略可以站在墙外,只是没有继续往外走的理由。两者的差异在多轮更新上显形:TRPO 的每步更新严格停在信任域内,路线可预测;PPO 的单批多轮更新允许 ratio 暂时越界,靠的是三道回收机制把它拉回来——越界样本梯度归零后,同批内未越界样本仍在优化,策略的重心回到域内;KL 早停监控(训练目标里的近似 KL 超过阈值就终止本批 epochs);以及最根本的,下一批新数据由更新后的策略产生,旧数据里越界区域的"话语权"自然失效。工程统计也支持这个判断:监控 PPO 训练中 ratio 越界样本的比例,健康训练通常在 0.1 到 0.3 之间浮动——零说明 clip 太松没起作用,长期超过一半说明步子迈得太大,两者都要回调学习率或 epochs 数。