4.3 RNN 与序列建模:失忆、门控与注意力接棒
4.3 RNN 与序列建模:失忆、门控与注意力接棒
本节摘要:RNN 把参数沿时间步共享,梯度在展开图上连乘传递,于是消失与爆炸成为结构性风险;LSTM 与 GRU 用门控给记忆修了条「加法高速路」,Transformer 干脆用注意力把串行依赖换成全局查找。本节沿这条演进链展开全部高频追问,讲清每一步替换解决的是哪个具体痛点。
从这节开始,深度学习的追问有了「历史剧情」:RNN 为什么失忆、LSTM 为什么有效、Transformer 为什么接管。三问之间是严格的因果链——每一代方案都是对上一代某个数学缺陷的针对性修复。能按因果讲故事的候选人,和背名词的候选人,在追问下三分钟就分层。
主问题:RNN 为什么会失忆
主问题:「解释 RNN 的梯度消失,它和深层的 MLP 有什么不同?」
标准答案
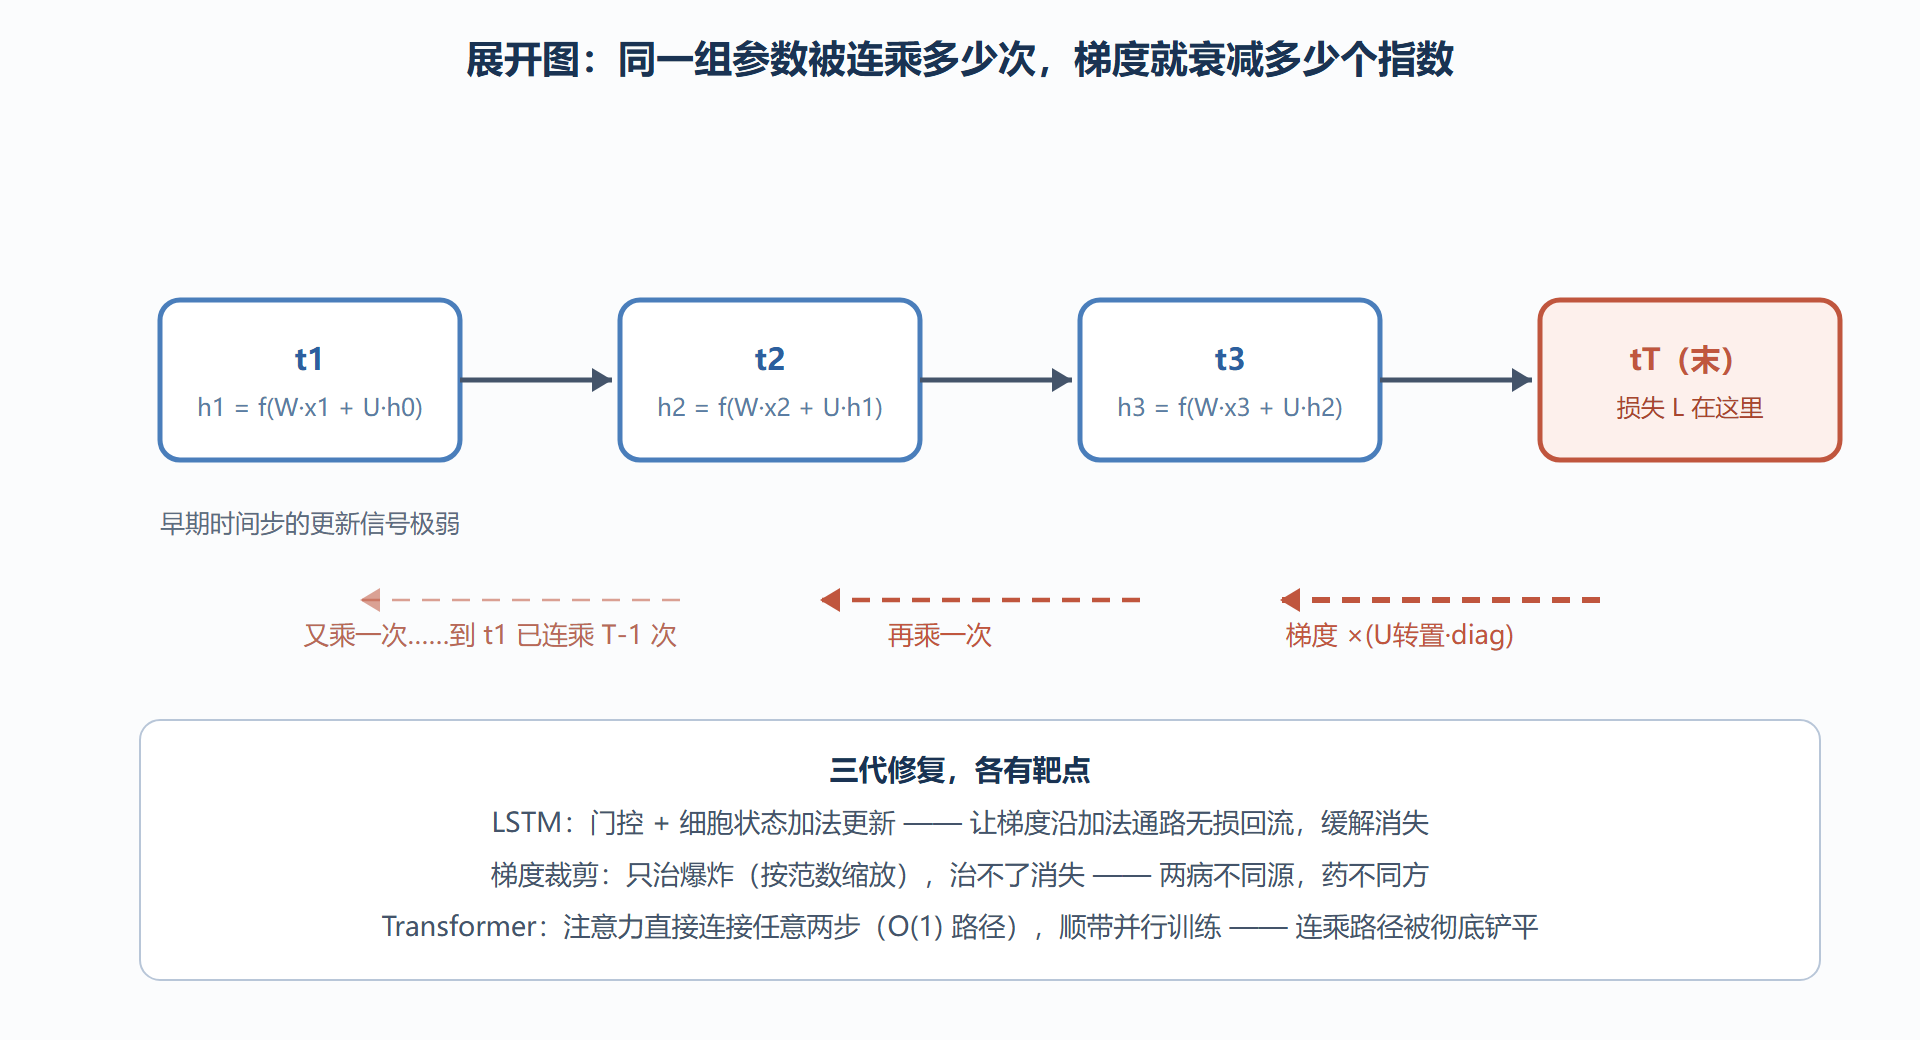
RNN 在时间步间共享同一组参数,沿时间展开后等价于一个极深的网络:每一步的反向梯度都要乘一次 W 转置与激活导数。长序列下这些雅可比矩阵连乘,谱半径小于一时梯度指数级衰减(消失),大于一时指数级增长(爆炸)。与 MLP 的不同在于:MLP 的消失问题靠更深的初始化与归一化可控,而 RNN 的连乘发生在「同一权重的时间维」上,序列长度直接决定乘积项数,序列一长问题必然复现,属于结构性的病。
「结构性」三个字是本题的分水岭——它解释了为什么堆更多层、换更好的初始化都治不好 RNN 的长程依赖,必须从结构上动手术。
图:RNN 沿时间展开与梯度的连乘路径
追问一层:LSTM 的门到底在干什么
追问:「LSTM 怎么解决梯度消失?GRU 砍了什么,代价是什么?」
参考答法先立核心句:LSTM 对梯度消失的解法不是「防乘」而是「改加」——细胞状态 C 的更新是 C(t) = f·C(t−1) + i·候选值,这条加法通路上梯度可以近乎无损地直行,类似残差连接的先声。三个门各司其职:遗忘门决定旧记忆保留比例,输入门决定新信息写入比例,输出门决定记忆外露比例——梯度沿 C 主线回流时经过的只有遗忘门,不像 RNN 每步都过完整变换。GRU 把遗忘门与输入门合并成更新门、砍掉独立细胞状态,参数少约四分之一,多数任务效果相当;代价是记忆容量与表达自由度略降,长序列精细建模时 LSTM 偶有优势。面试补一句「实践里 GRU 是速度与效果的标准交易品」即可。
追问二层:注意力为什么接管了序列建模
追问:「Transformer 相比 RNN 到底强在哪?没有任何代价吗?」
这是本章与面试潮流衔接最紧的一问,推荐答成「两强一弱」:
- 路径长度:任意两个位置一步直连,长程依赖的梯度路径从 O(T) 压到 O(1),结构性消失被釜底抽薪;
- 并行度:RNN 的时序依赖迫使训练串行,自注意力对整段序列并行计算,训练吞吐量大增,这才养得动大规模预训练;
- 代价:自注意力的计算与显存随序列长度平方增长;长文档、高分辨率场景必须靠稀疏注意力、滑窗或线性注意力续命。另外注意力本身没有位置概念,需要位置编码额外注入顺序信息——RNN 靠循环天然获得的位置感,在这里成了要花钱买的资源。
import torch, torch.nn as nn rnn = nn.LSTM(input_size=32, hidden_size=64, num_layers=2, batch_first=True) x = torch.randn(4, 50, 32) # 批 4、序列长 50、特征 32 out, (h_n, c_n) = rnn(x) print(out.shape, h_n.shape) # (4,50,64) 每步输出;(2,4,64) 末隐状态 # 自注意力对照:一步拿到全序列的两两交互 qkv = nn.Linear(64, 192) q, k, v = qkv(out).chunk(3, dim=-1) att = (q @ k.transpose(-2, -1)) / (64 ** 0.5) print("注意力矩阵:", (att.softmax(-1) @ v).shape) # (4,50,64),路径长度 O(1)
代码把两条路线的接口差异摆在了同一张桌上:LSTM 给你「逐步 + 末状态」,注意力给你「全序列两两关系矩阵」,后者正是并行与全局依赖的来源。
易错点
- 把梯度爆炸与消失混为一谈地开药:裁剪只对爆炸有效,消失要靠门控、残差或归一化——药方错挂是深度追问的经典翻车点。
- 说「LSTM 彻底解决了长程依赖」。它缓解到「数百步可用」,千步以上依旧乏力,否则注意力没有出场机会。
- 混淆 RNN 的参数共享与 CNN 的参数共享:前者共享在时间维(同一权重每个时间步复用),后者共享在空间维(同一核每个位置复用),类比有助于记忆但别张冠李戴。
- 认为注意力矩阵是「可学习的参数」。注意力权重是输入派生的动态计算结果,可学习的是 Q、K、V 的投影矩阵。
评分要点
及格:画出展开图并说清连乘致消失与爆炸的机制;良好:LSTM 门控与加法通路的保护作用讲得清,GRU 取舍说得准;优秀:把三代方案(RNN、门控 RNN、注意力)讲成对路径长度与并行度两项指标的连续改进,并给出注意力的平方复杂度与位置编码代价。序列建模题答到「代价」一层,通常意味着这轮面试的深度期望已经被你定义了。
下一节把镜头从结构转向训练现场:优化器怎么选、归一化放哪里、训练不动时按什么顺序排查——工程味最重的一节,也是与面试官聊得最久的一节。
高频追问速答
问:Teacher forcing 是什么,有什么副作用?
训练时把真实的前一步输出(而非模型自己的预测)作为下一步输入,让训练更稳更快;副作用是训练与推理的输入分布错位——推理时只能用自己此前的预测,误差会累积。这个「曝光偏差」是序列生成任务的固有难题,scheduled sampling 是缓解尝试之一。
问:注意力权重能当解释用吗?
谨慎。注意力权重显示「模型把计算资源分给了谁」,不等于「谁导致了输出」;有实证表明扰动注意力分布而输出不变的情形存在。把它当线索可以,当因果证据不行——与 6.3 节解释性的边界一脉相承。
问:序列任务现在还用 RNN 吗?
在极低算力、流式、低延迟的边缘场景仍有席位——RNN 的状态是常数大小,推理成本与序列长度无关,这是注意力平方成本换不来的。技术选型题的答案永远是「看约束」,不是「看新旧」。
表达纪律:讲三代序列模型时用「路径长度」与「并行度」两个指标贯穿,结构感立刻胜过名词堆砌。
边角案例两则
问:序列任务的特征工程还有哪些视觉任务没有的坑?
序列对齐(不同长度的样本怎么组成批)、因果性(特征只能用过去窗口)、标签偏移(预测目标的时间口径)。这三坑中的任何一个都能让离线分数变成幻觉,时序纪律是序列任务的隐形考场。
问:双向 RNN 为什么不能直接用于实时预测?
反向层需要读「未来」的输入,离线全序列任务可用,实时流式场景只有到当前时刻的信息——改用单向或带延迟的双向。任务的时间结构决定架构合法性,这句判词值得背。