4.4 优化器与归一化:训练不动怎么办
4.4 优化器与归一化:训练不动怎么办
本节摘要:训练现场的问题永远具体:loss 不降、曲线震荡、精度卡顶。本节把 BGDSGD、Momentum、Ada 系到 Adam 的演进讲成「对梯度信息的逐步利用」,把 BatchNorm、LayerNorm 的差异讲成「统计维度随数据形态变化」,最后给出一套可在面试里复述的训练排查顺序。
前三节解决「模型长什么样」,这一节解决「模型为什么训不好」——这是面试官判断「做过实验」还是「只看过博客」的分界线。优化器与归一化的所有考点都能编入一个统一的叙事:模型训练是一台精密仪器,优化器决定往哪走,归一化与初始化决定每一步的地面平不平,学习率决定步子多大。仪器不转时按什么顺序拧哪个螺丝,正是本节的全部内容。
主问题:优化器的演进逻辑
主问题:「从 SGD 讲到 Adam,每一步都在改进什么?」
标准答案
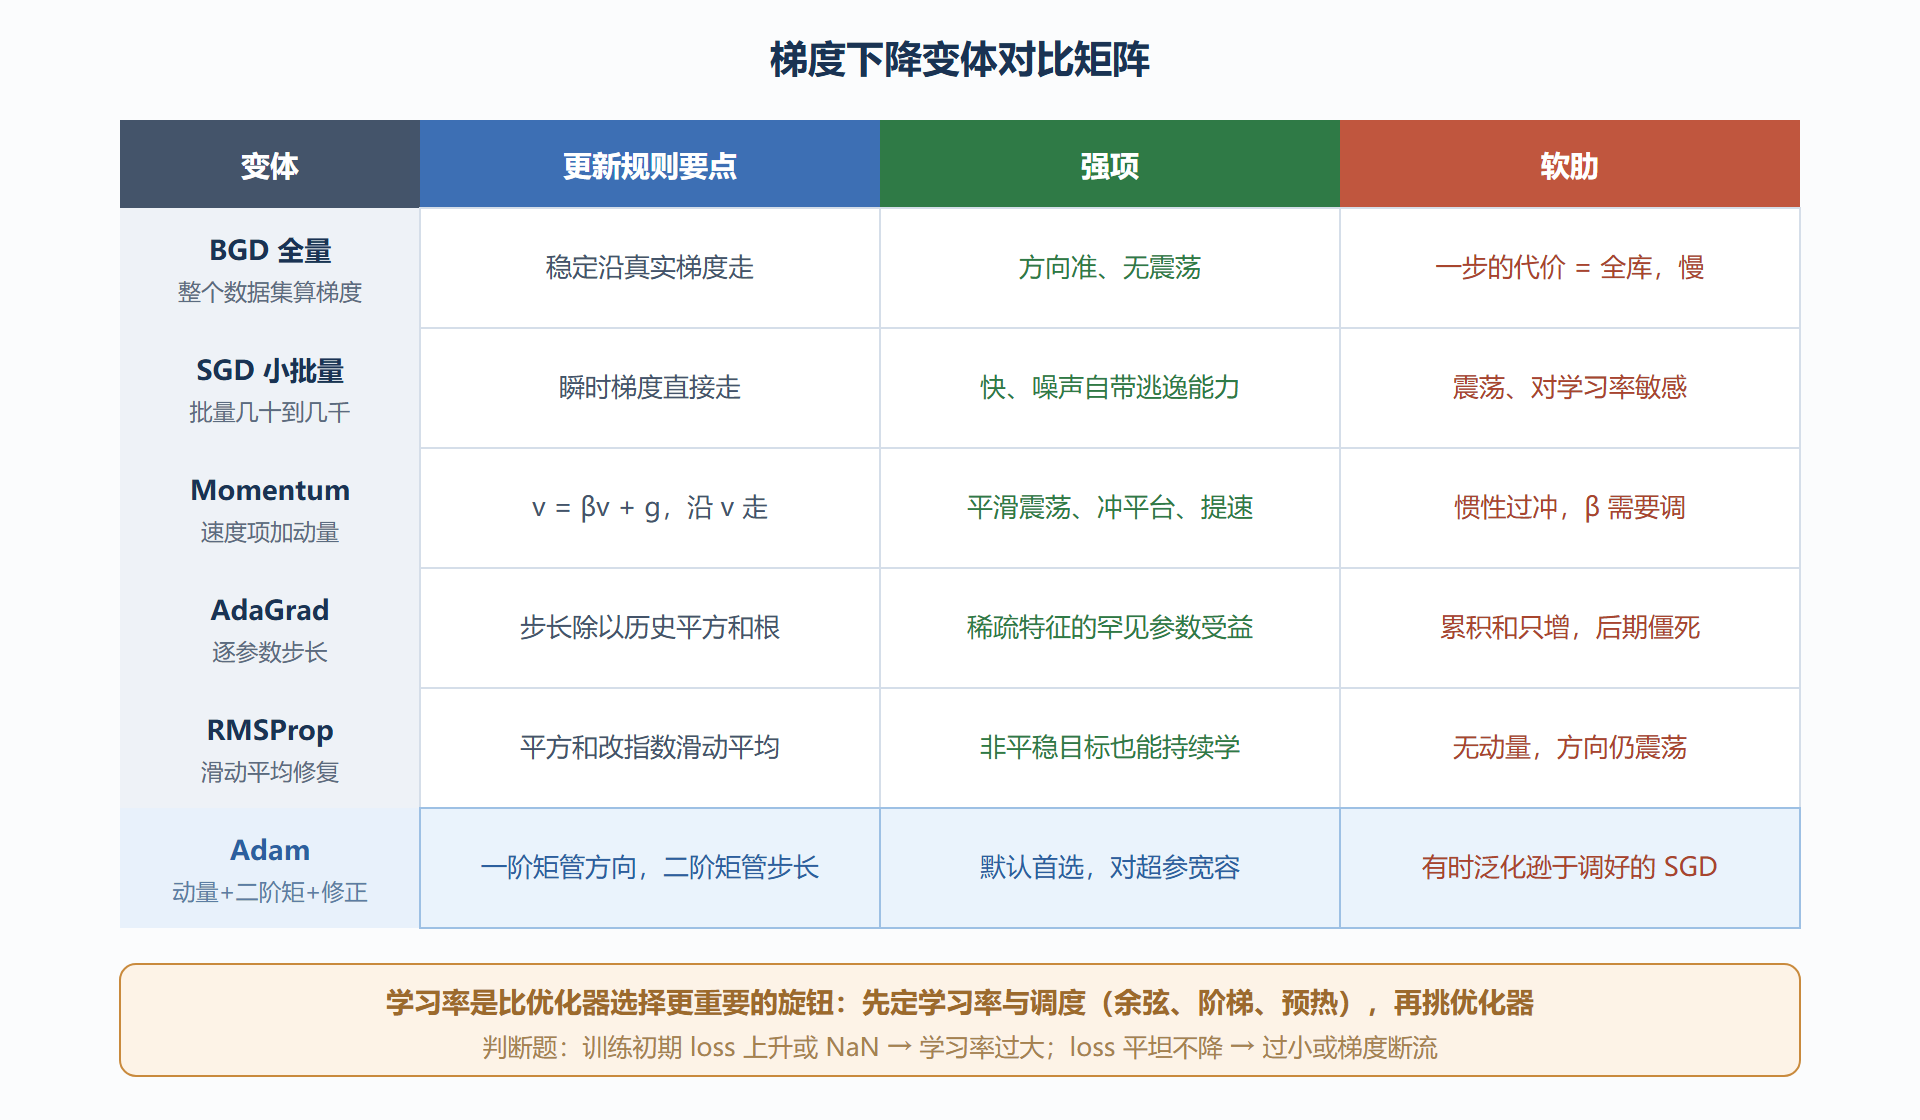
把优化器演进讲成对梯度信息的逐步榨取即可覆盖全部考点。SGD 只用当前小批量的瞬时梯度,便宜但震荡;Momentum 叠上历史速度项,惯性平滑震荡、冲过平坦区;AdaGrad 给每个参数按历史梯度平方自适应缩放步长,稀疏特征的罕见参数获得大步长,但累积和单调增大导致后期步长趋零;RMSProp 把累积改成指数滑动平均,修复了「越学越僵」;Adam 兼收并蓄——动量管方向平滑、二阶矩管逐参数步长,再加偏差修正让初期估计无偏。默认首选 Adam 或其变体;批量充足、追求泛化与收敛稳定时,调好的 SGD 加动量常给出更平的测试曲线。
收尾要带一句工程注脚:Adam 的 epsilon、beta 参数在极端任务(大模型训练)上敏感,出现 Adam 掉点而 SGD 反超并不罕见——「没有 universally 更好的优化器,只有与损失景观匹配的」这句判断值得说出口。
图:梯度下降变体对比矩阵
追问一层:BatchNorm 与 LayerNorm 的分野
追问:「为什么 CV 里用 BatchNorm,NLP 里用 LayerNorm?」
参考答法按「统计谁」切入。BatchNorm 对「同一通道跨样本」算均值方差——统计维度在 batch 维,训练时还维护滑动统计供推理使用;它依赖 batch 内样本足够多且分布稳定,序列任务里变长、padding、小 batch 都会污染统计,于是转向 LayerNorm:对「同一样本同一层的全部特征」统计,完全不碰 batch 维,训练推理行为一致。一句话总结归一化的功劳:把各层输入重新拉回稳定的分布区间,缓解内部协变量偏移、平滑损失曲面,让大学习率变得安全,顺带成为梯度消失防线的一环。
追问二层:训练不动的排查顺序
追问:「loss 一直不降,你的排查清单是什么?」
这是本章最工程化的一问,推荐背一套固定顺序,体现「先便宜后昂贵、先常见后罕见」的原则:
- 第一步查数据:输入是否全零或常数、标签是否错位、预处理是否把信号洗掉了——数据问题占「不收敛」的一大半;
- 第二步过拟合单批:取一小撮样本反复训练,loss 压不下去说明模型或损失接线有 bug,压得下去说明容量没问题,是优化与数据规模的问题;
- 第三步动学习率:跨数量级扫一遍,观察 loss 响应;配合预热与余弦调度;
- 第四步查梯度:打印梯度范数,看消失(趋零)还是爆炸(巨大),对应加归一化或裁剪;
- 第五步查初始化与权重衰减:初始化方差不匹配会开局即死;权重衰减过大把权重拖向零。
import torch loss.backward() total_norm = torch.norm(torch.stack([ p.grad.norm() for p in model.parameters() if p.grad is not None ])) print("梯度总范数:", float(total_norm)) # 消失:长期近零;爆炸:动辄上百 torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=5.0) # 裁剪防爆 optimizer.step() optimizer.zero_grad(set_to_none=True)
三行梯度诊断代码是这一问的实物证据:能报出「健康网络的梯度范数大致量级」,就彻底和背书选手分开了。
易错点
- 把 Adam 当免调参神话。学习率依然要调,warmup 在大 batch 与 Transformer 上几乎是必需品。
- BatchNorm 细节翻车:训练用批统计、推理用滑动平均,两套行为说不清;batch 很小时 BN 失稳也讲不出原因。
- 混淆权重衰减与梯度裁剪:前者是正则化(防过拟合),后者是数值稳定(防爆炸),目的与机制都不同。
- 归一化放错位置的争论背成标准答案。正确姿态是「实验说话」:残差块里 Pre-Norm 训练更稳、Post-Norm 上限可能更高,能讨论本身就是加分。
评分要点
及格:说清 SGD 与 Adam 的基本差异及各自适用;良好:优化器演进有「信息利用」的主线,BN 与 LN 的统计维度差异准确;优秀:能输出完整排查清单并带梯度范数这类实操证据,理解学习率调度与 warmup 的适用条件。训练题的评分逻辑与代码评审很像——背出的结论值一层,带证据的判断值三层。
至此深度学习章收束。下一章调转方向:模型的输出口派上用场之前,数据在入口处经历的一切——特征工程,同样是面试追问的重仓区。
高频追问速答
问:学习率 warmup 为什么有效?
训练初期梯度估计噪声大、动量统计尚未建立,大步长容易把参数甩进糟糕区域;warmup 用小步长先把统计热身、损失面探明,再切到目标学习率。Transformer 与大批量场景几乎必备——注意力早期对学习率极其敏感。
问:BatchNorm 在训练与推理为什么行为不同?
训练用当前批的均值方差(批内统计),推理用训练期间维护的滑动平均——因为推理时可能单样本、没有批可统计。这条双行为是 BN 的复杂度来源:batch 太小统计失真、分布式下需要同步批归一化、与 drop out 类手段叠加时方差偏移。LayerNorm 没有这些问题,因为它根本不碰批维度。
问:梯度裁剪会改变模型吗?
只在爆炸时起作用:范数超阈值就等比缩放,方向不变。它是数值稳定手段,不是正则化——这点与权重衰减必须分清,混淆两者是高频扣分点。
表达纪律:训练调优题的每个结论都带「先查什么」的顺序感,面试官听的是排查逻辑,不是参数背诵。
边角案例两则
问:权重衰减和学习率联动吗?
Adam 语境下经典权重衰减与自适应步长耦合会产生不等价行为,解耦版本(AdamW)把衰减从梯度里拆出来直接作用在权重上——大模型训练几乎都用 AdamW。能说出「Adam 与 AdamW 的差异在衰减的实现位置」,这一问就赢了。
问:归一化层能关掉吗?
能且有时必须:小批量场景 BN 统计失真可换成 GroupNorm;某些生成模型的归一化会抹掉 desired 的幅度信息。层的选择永远是「哪一层、哪一维、为什么」三连答,不是默认开关。