2.3 记忆工具:自我编辑的闭环
2.3 记忆工具:自我编辑的闭环
本节摘要:记忆工具是模型与自身记忆之间的法定通道:核心记忆追加与替换负责修订常驻事实,档案写入与语义检索负责知识沉淀与调用。本节拆解一次记忆编辑从模型发起、参数校验、执行落库到上下文重组的完整闭环,并逐项说明这条链路上的安全闸门。读完本节,你能预判哪些编辑会被放行、哪些会被拒收,以及如何从返回轨迹中排查记忆问题。
把编辑权交给模型的胆量与底线
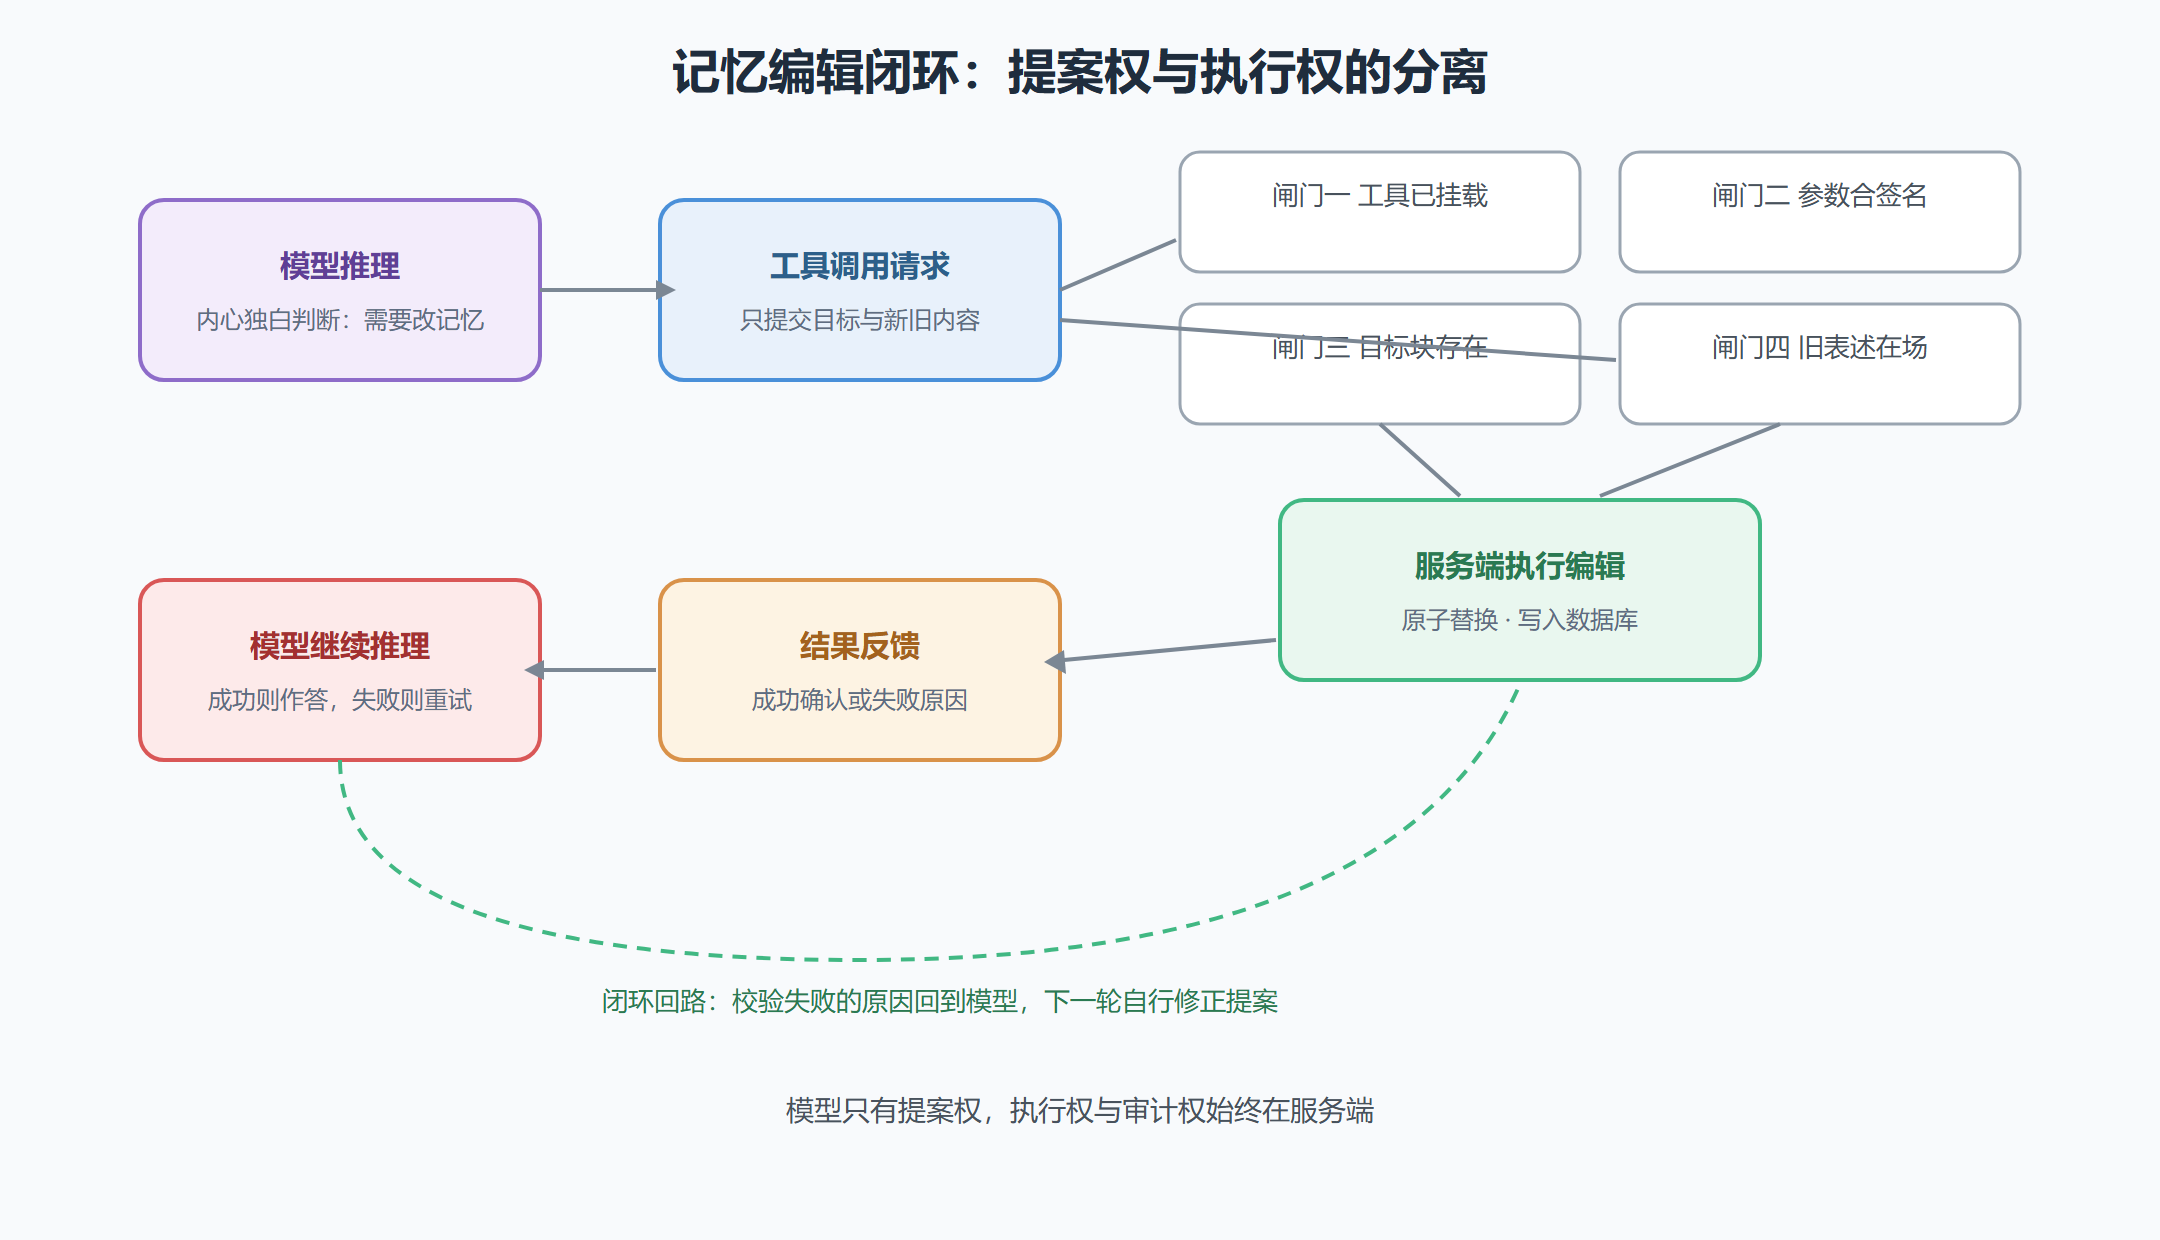
让模型改自己的记忆,听起来像让会计给自己发工资——凭什么放心?Letta 的答案不是"信任模型",而是"用机制约束":模型能做的只有发起工具调用请求,真正动手的是服务端。每一次请求都要过四道闸门——参数是否符合工具签名、目标记忆块是否存在且有空间、内容是否越权、调用顺序是否违反工具规则。任何一道不过,编辑就被拒收,并把失败原因反馈给模型,让它在下一轮自行调整。
这层设计是理解 Letta 的关键:模型拥有的是编辑提案权,服务端持有执行与审计权。胆量来自模型自主决策带来的适应性,底线来自服务端校验带来的可控性。你在调试中看到的"模型没记住",很多时候不是模型没发起编辑,而是某道闸门把它拦下了——这也是为什么本节要花整整一节讲清工具的执行轨迹。
一张工具清单:模型的记忆操作全集
Letta 为记忆操作预置了一组内置工具,按对象分为两类。作用于核心记忆的编辑类工具,与作用于外部存储的检索沉淀类工具:
| 工具 | 作用对象 | 功能 | 典型触发场景 |
|---|---|---|---|
| core_memory_append | 核心记忆块 | 向块内追加一条事实 | 用户披露新的关键信息 |
| core_memory_replace | 核心记忆块 | 替换块内的既有表述 | 事实变更,旧表述失效 |
| conversation_search | 召回存储 | 语义检索历史对话 | 需要回溯聊过的细节 |
| archival_memory_insert | 存档存储 | 写入长期知识条目 | 出现值得沉淀的文档或结论 |
| archival_memory_search | 存档存储 | 向量检索知识档案 | 推理需要长期知识支撑 |
这张清单有两点值得咀嚼。其一,工具是一小撮而非一大堆:五种操作覆盖了记忆的全部生命周期,认知负担极低,弱模型也能学会使用。其二,写与读成对出现:编辑类工具管现在,检索类工具管过去,模型随时可以在"修订认知"与"查询历史"之间切换。第 5 章的自定义工具会在这个全集之外扩展业务能力,但记忆操作始终是这一组内置工具的专属地盘。
一次编辑的完整旅程
抽象地谈闸门不够解渴,我们跟踪一次真实感十足的编辑全程。用户对智能体说:"我调整到数据组了,以后别再把我的问题转给算法组。"模型的内心独白判断出这是对 human 块的修订,发起 core_memory_replace,以下是服务端视角的执行链路(示意结构):
# 服务端视角的一次记忆工具调用(示意,展示校验链) request = { "tool": "core_memory_replace", "args": { "label": "human", "old": "用户所在团队:算法组", "new": "用户所在团队:数据组(自本月起)", }, } assert request["tool"] in builtin_tools # 闸门一:工具存在且已挂载 validate_schema(request["args"]) # 闸门二:参数符合签名 block = get_block(request["args"]["label"]) # 闸门三:目标块存在 assert request["args"]["old"] in block.value # 闸门四:旧表述确实在场 apply_edit(block, request["args"]) # 执行:原子替换 persist(block) # 落库:跨会话生效 feed_back("human 块已更新。") # 回填:结果返回模型
四道闸门各司其职:前两道保证调用合法,第三道防止编辑错对象,第四道防止"替换一个不存在的旧表述"这种静默失败。执行后的回填同样关键——模型会收到编辑结果的确认或失败原因,这构成一个反馈闭环:成功了,模型继续回答用户;失败了,模型换一种写法重试。所谓自我编辑的"闭环",闭合的正是这条"发起、校验、执行、反馈"的回路。
图 2-3 记忆编辑闭环:从模型提案到状态落库
从返回轨迹里读故事
闭环设计给开发者留了一份厚礼:每次消息调用的返回里都带着完整的步骤轨迹——模型生了什么独白、发起了哪些工具调用、参数是什么、执行结果如何。学会读这段轨迹,记忆调试就不再靠猜:
resp = client.agents.messages.create( agent_id=agent.id, messages=[{"role": "user", "content": "我换到数据组了,别再转给算法组。"}], ) # 逐条查看返回的轨迹消息 for m in resp.messages: print(m.message_type) # reasoning / tool_call / tool_return / message # reasoning 内心独白:模型为什么想改记忆 # tool_call 发起的编辑:改哪个块、旧文新文各是什么 # tool_return 执行结果:成功确认或被哪道闸门拦下 # message 最终给用户的回答
轨迹的常见剧本有三种:tool_call 后紧跟成功 tool_return,编辑闭环完整走通,这是健康态;tool_return 报错说旧表述不存在,多半是模型记错了既有内容,属于可自愈的提案失误;连 tool_call 都没有,说明模型没意识到该更新记忆——这往往不是工具问题,而是 persona 块缺少"遇到变更主动更新用户信息"之类的行为指引,要回去改记忆策略而不是查框架缺陷。
挂载与裁剪:工具清单也是策略
内置记忆工具默认挂载给新建智能体,但挂载是可配置的——这正是工具清单作为"策略"的含义。一个只做知识库问答、不允许自我修订的智能体,可以裁掉核心记忆编辑类工具,让它对用户画像只读不写;一个重检索的文献助手,可以保留档案检索而收紧档案写入。挂载的判断标准始终是业务语义:你愿意让这个智能体拥有多大的自我修改权,就用工具挂载表达出来。
⚠️ 一个常见的误操作值得点名:开发者发现智能体"记不住",第一反应是去改系统提示词,写上大段"你必须记住用户的一切"。这通常适得其反——记住的能力在工具与容量,不在口号。更有效的顺序是:先确认编辑类工具已挂载,再检查目标块的剩余容量,最后才考虑用 persona 一两句话引导编辑时机。这个排查顺序在第 5 章的排错手册里还会以清单形式出现。
编辑的时序:一轮推理里的多次读写
闭环描述的是单次编辑,实际推理中的一轮常常包含多次读写交织。一个典型的复杂轮次长这样:用户的消息同时包含新事实与一个提问——"我把观察期的结论更新了:缓存击穿是主因。顺便查一下上次类似事故的处理记录。"模型会先发起核心记忆的替换(更新事故结论),再对存档发起检索(找历史处理记录),拿到检索结果后综合两者给出回答。多次工具调用在同一轮里按序执行,每次的结果都回填给模型供下一步决策。
这种时序交织说明一个深层设计:记忆操作与推理不是两个阶段,而是同一条思考流。 模型可以边想边记、边记边查,记忆维护不需要用户发起专门的"请记住"指令,也不需要应用层安排独立的"整理时间"。理解了这一点,你就明白为什么 persona 里的记忆策略如此重要——它定义的不是某个功能开关,而是这条思考流里"什么时候该停下来记一笔"的判断习惯。
本节要点回顾
- 权责分离:模型握有编辑提案权,服务端持有执行与审计权,安全靠机制而非信任。
- 工具全集:五种内置工具覆盖记忆全生命周期——两种核心记忆编辑、两种存档操作、一种对话检索。
- 四道闸门:工具挂载、参数签名、目标存在、旧表述在场,任何一道不过即拒收并反馈。
- 闭环本质:发起、校验、执行、反馈的回路,失败原因回流给模型供其修正下一次提案。
- 调试入口:返回轨迹的 reasoning、tool_call、tool_return、message 四类消息是排查记忆问题的第一现场。
- 策略思维:工具挂载是表达"自我修改权边界"的配置手段,先查工具与容量,再改提示词。
下一节视角拉高一层:这套编辑闭环跑在什么样的系统架构上,一条请求从客户端到数据库要经过哪些部件。