1.1 第一条能跑的路径
1.1 第一条能跑的路径
本节摘要:XPath 用斜杠连接步,从文档树里选出节点。绝对路径以单斜杠开头,从根走;相对路径跟着当前上下文走;双斜杠在当前节点的全体后代里搜。先写出三条能命中书店样本的表达式,再谈「步」的内部结构。
学习目标
阅读完本节,你应当能够:
- 对着书店树写出
/bookstore/book并说出命中几本 - 解释相对路径
book/title依赖上下文节点 - 用
//title取出所有书名,并说明它比绝对路径贵在哪 - 把一条路径拆成「步」,知道默认轴是 child
一、先跑三条,再解释名词
样本始终是这棵树(原文集贯穿的书店文档,含 cooking / children / web 三类):
<bookstore> <book category="cooking"> <title lang="en">Everyday Italian</title> <author>Giada De Laurentiis</author> <year>2005</year> <price>30.00</price> </book> <book category="children"> <title lang="en">Harry Potter</title> <author>J. K. Rowling</author> <year>2005</year> <price>29.99</price> </book> <book category="web"> <title lang="en">Learning XML</title> <author>Erik T. Ray</author> <year>2003</year> <price>39.95</price> </book> </bookstore>
把求值上下文放在文档根上,三条表达式的命中如下。
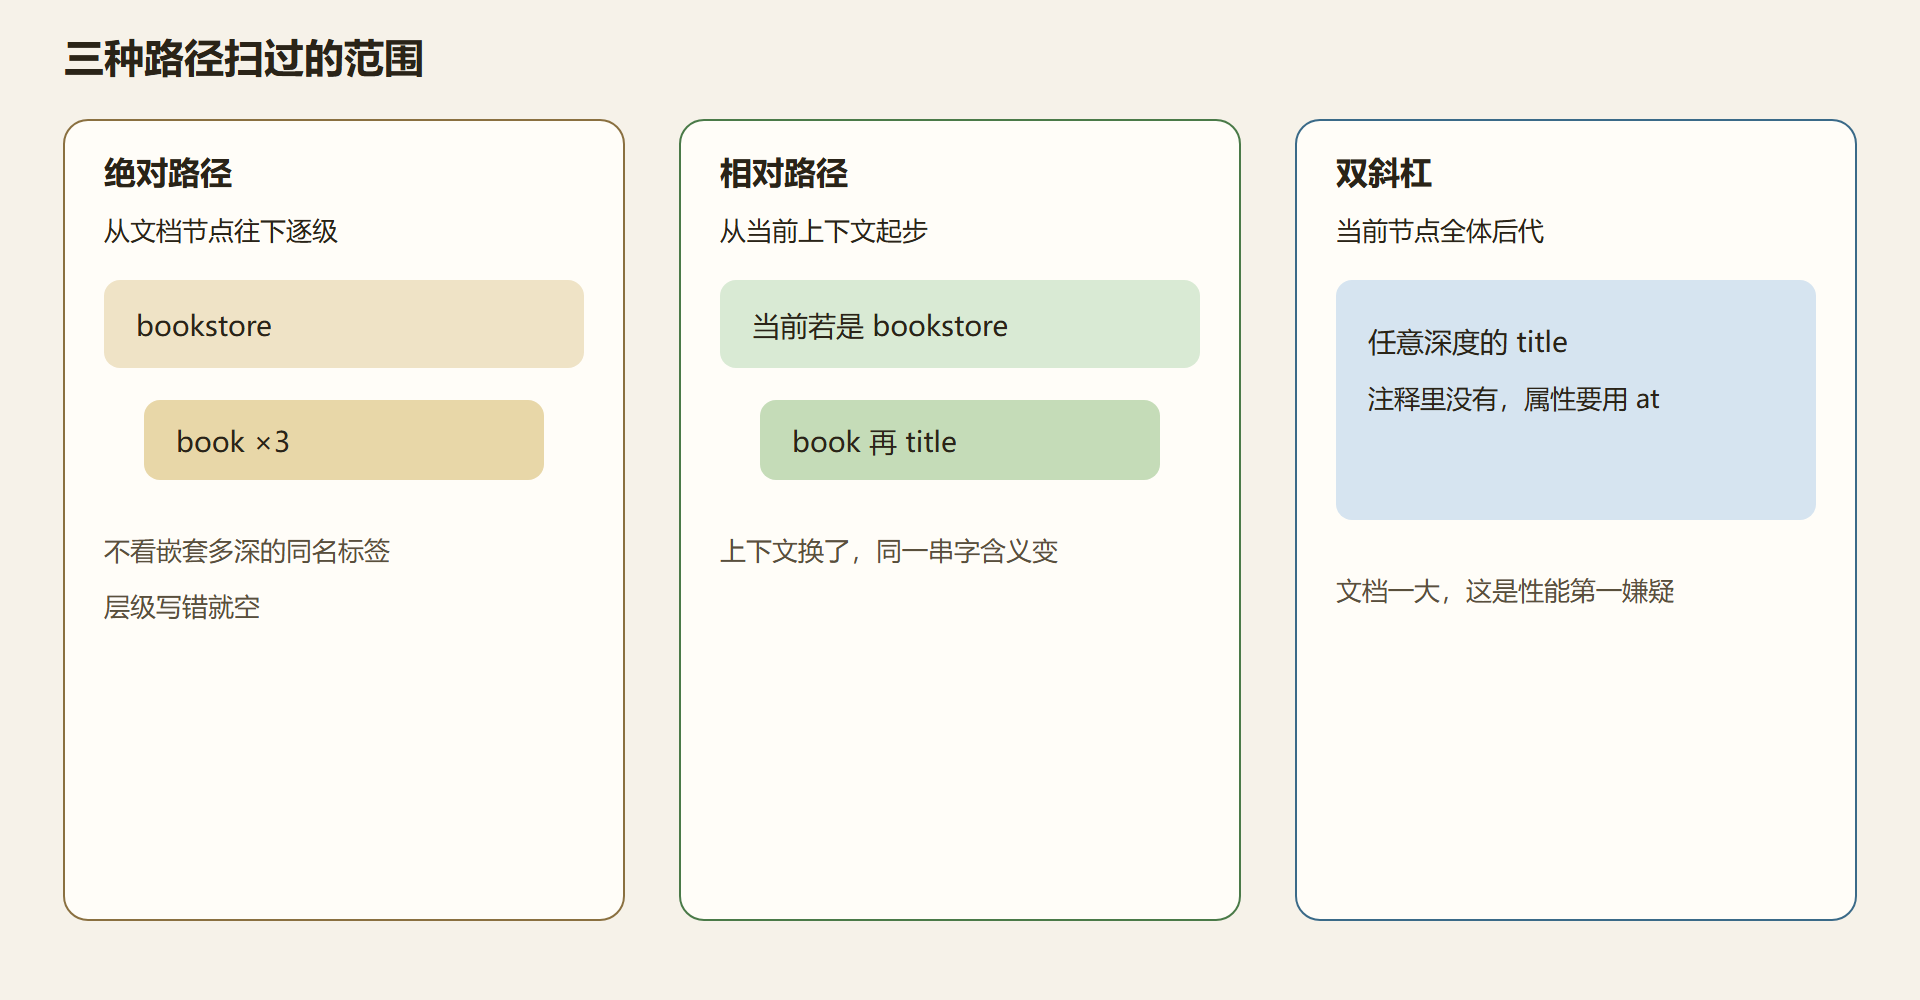
/bookstore/book → 3 个 book 元素 book/title → 3 个 title 元素(相对根元素 bookstore) //title → 3 个 title,位置不限
我更倾向你把第一条写成绝对路径。绝对路径不依赖「当前点在哪」,排错时少一个变量。相对路径适合已经走进某个 book、只想拿它的 title 的场景。双斜杠适合结构不稳定、你懒得数层级的时候,但会扫整棵后代。
在 Python 的 lxml 里,对根元素求值时,/bookstore/book 与 book 都能拿到三本——因为根元素就是 bookstore。很多人在这里混淆「文档根」和「根元素」:文档节点在根元素之上,绝对路径的第一个斜杠停在文档节点,下一步才是 bookstore。
原文集用 lxml 演示时还写过 /root()。在 lxml 里这条经常不工作,要拿根元素请用 /*。这是引擎差异,不是你记错了语法。
二、路径长什么样
一条路径是若干步用 / 串起来。一步的完整写法是:
轴::节点测试[谓词]
省略轴时默认 child。所以 /bookstore/book 实际是 /child::bookstore/child::book。//book 实际是 /descendant-or-self::node()/child::book:先走到自己及所有后代,再取名为 book 的孩子。这也是它贵的原因——中间那一步会铺开大量节点。
把树当成书架:/bookstore/book 是「总馆目录里的每一本」;book/title 是「我已经站在总馆里,看每本书脊上的书名」;//title 是「整栋楼里凡是叫 title 的标签都翻出来」,储藏室里若还有别的 title,也会被扫到。
| 写法 | 从哪开始 | 典型命中 | 我怎么选 |
|---|---|---|---|
绝对路径 /bookstore/book |
文档节点 | 根下直系 book | 结构稳定、要可复现 |
相对路径 book/title |
当前上下文 | 当前节点下的书名 | 已经走进某层 |
双斜杠 //book |
当前节点的后代闭包 | 任意深度的 book | 结构会变,但文档要小 |
当前节点 . |
自己 | 自己 | 谓词里引用当前项 |
父节点 .. |
父 | 上一层元素 | 从属性或文本走回元素 |
⚠️ 常见坑:在已经是
bookstore的根元素上再写/bookstore/book没问题;若上下文已经是某本book,相对路径book/title会去找 book 的子 book,结果为空。空结果优先检查上下文,而不是改谓词。
💡 关键直觉:斜杠是「走一步」,双斜杠是「在后代里再走一步」。不是「任意字符串匹配」。
原文集 1.3 还给出过四本书的样本:第三本是 XQuery Kick Start,两位 author(James McGovern 与 Per Bothner),第四本才是 Learning XML。后面讲 book[3]、following-sibling 时我会切到这个四本书版本,避免「只有三本时 last() 和第三本撞车」说不清。
三、动手时怎么接到引擎上
概念上的调用是:把 XML 解析成树,对某个上下文节点求值,拿到节点列表。lxml 大致是 root.xpath("book/title"),返回元素对象列表,再用 .text 取字符串。Java 要先 compile 再 evaluate,并声明想要 NODESET 还是 STRING——同一条 //title/text(),返回类型不同,你拿到的是列表还是拼起来的第一个字符串。
# 概念片段,不是完整脚本 titles = context.xpath("/bookstore/book/title") # 期望三个元素:Everyday Italian / Harry Potter / Learning XML
不要在 Markdown 里把表达式写成可点击链接。平台会把方括号路径当成超链接吃掉。一律放进代码块或反引号。
图:三种走法扫过的范围
问题:为什么 /bookstore/book/title 有结果,/book/title 是空?
因为绝对路径的第一步必须是根元素名。这份样本根元素叫 bookstore 不叫 book。CSS 选择器里 book title 可以不管祖先叫什么;XPath 绝对路径不行。
问题:HTML 能不能用同一套写法?
能,前提是解析器把它建成树。真实 HTML 常缺闭合标签,lxml 的 HTML 解析器会补节点,补完之后路径要按补完的树写,不能按你在源码里看到的缩进猜。HTML 还有默认命名空间问题,第 3 章单独练。
四、把步拆开排错
当你写出 /bookstore/book/title 却得到空,不要整串扔掉重写。从左往右砍:先求 /bookstore 看根元素在不在;再求 /bookstore/book 看孩子在不在;最后才加 title。哪一步 count 变成 0,问题就钉在那一步。这和修水管从总阀往后关是同一思路。相对路径更要先打印当前上下文的标签名——很多库能告诉你现在站在哪个元素上。站在 book 上还写 book/title,等于找书的子书,空得理所当然。
双斜杠的排错方式相反:先承认它会多命中。//title 在书店样本里刚好三本,看起来无害。把样本改成 book 里再嵌一套目录,目录里也有 title,双斜杠会把目录名也捞上来。这时你才会怀念绝对路径的「只走这一枝」。工程上我把双斜杠当警告符:出现在提交的表达式里,评审要问「深度真的未知吗」。
原文集 1.1 把 XPath 比作 SQL。这个比喻有用的一半是「声明式:说要什么,不说怎么遍历」。有害的一半是「写错了会报错」。请把有害的一半丢掉。空节点集是合法结果。宿主语言里对空列表取下标才会爆,那是 Python 的事,不是 XPath 在报错。养成 count 一下的习惯,比依赖异常可靠。
步进阶时会出现 . 和 ..。点是自己,两点是父。从 title 文本节点走两点回到 title 元素,再走两点回到 book。属性节点的父是拥有它的元素,所以从 category 属性走两点回到 book,再取 title,这是合法且常见的走法。不要以为两点只能从元素出发。
HTML 片段上练第一条路径时,解析器可能给表格补 tbody,给你的 div 外包一层。你按「我看见的源码」写绝对路径会空。对策不是改用双斜杠逃避,而是先把解析后的树打印成缩进标签,对着树写。第 4 章会回到这件事,这里只要记住:路径对着树,不对着源文件字符。
五、三条起步路径对着三本书逐条对答案
绝对 /bookstore/book 命中三本。/book 空,根不叫 book。相对 book/title 在上下文是 bookstore 时命中三个 title;上下文若已是某本 book,同一串字去找子书,空。双斜杠 //title 三本都中,书内再嵌目录 title 会多。lxml 对根元素求值时 /bookstore/book 与 book 都能拿到三本,因为根就是 bookstore。文档节点在根元素之上,绝对路径第一斜杠停在文档节点。/root() 在 lxml 不可靠,用 /*。空节点集合法,count 一下。路径不要写成可点击链接。步从左往右砍着排错。点是自己,两点是父。HTML 对着解析后的树写,表格可能有 tbody。
练习:在根上跑三条,记下 count。把上下文改到第一本 book,再跑相对 book/title,确认变 0,改成 title 变 1。加一个嵌套 title,看双斜杠 count 增加而绝对三级链不增加。这三项分别钉绝对根名、相对上下文、双斜杠多命中。原文集 1.1 的 SQL 比喻丢掉「写错会报错」那一半。养成 count 习惯。第 2 章函数挂在已经选中的集合上,这三条不过关不要往后赶。
六、把空集合当成正常答案来练手
路径语言几乎不吼人。名字写错、少写一层、站错地方,它照样给你一个合法的空集合。后面若程序崩溃,那是宿主对空列表取第一个元素时炸的,不是路径引擎在报语法错。所以每写一步先数集合大小:数字和心里的书架一致,再往下加斜杠;数字是零,立刻停,不要再叠筛选条件。在空地上筛沙子,筛得再细还是空。绝对路径第一段必须是根元素的名字,这份样本根是书店不是书,把书当根抄过来第一步就空。相对路径完全看你站在谁身上:站在书店根上能拿到三本书名;已经走进某一本再写同样的字,等于找书的子书。双斜杠授权引擎铺开全体后代,样本小时看不出多捞,书里再嵌目录书名数字就会偏大。评审把它当警告符。和结构化查询语言只借声明式,不借写错会报错。文档节点在根元素帽子上,有的库根函数不可靠。表达式必须放代码块,否则方括号会被平台当成链接吃掉。
你可以做一个小实验:先在总馆根上数书,应当是三或四;再故意把第一段改成书,数应变零。数字从有到无的那一跳,就是根名字写错,不是筛选写错。接着把上下文挪到第一本书上,相对地写书再书名,数应变零;改成只写书名,数应变一。这第二跳证明相对走法跟着站位走。最后在某本书里塞一页也叫书名的目录,双斜杠的书名数会变大,从根到书再到书名的三级链不应当变大。三跳都预测对并且用计数对上,三种走法才算长进肌肉。不要用「我感觉选中了」代替计数,感觉会把碰巧当成掌握。
排错时把长串当成水管,从总阀往后关。先只要根元素,再要根下的书,再要书下的书名。哪一截从有变无,问题就在刚打开的那一截。很多人整串扔掉重写,等于把已经通的前两截也拆了,浪费时间还引入新错。点表示自己,两点表示父,从字走两点回到盒子,再走两点回到书,这是合法回走。属性盖章的父是拥有它的人,从分类章走两点回到书再取书名,同样合法。解析器若给表格补身体,你按源码缩进写的绝对走法会空,对策是打印解析后的树,不是改用整栋楼搜查来逃避。
和结构化查询语言只借「说要什么」这一层。它不会因为列名写错而红字提醒你,它只是给你空。宿主对空列表取第一个才会炸,那是宿主的脾气。养成每一步计数,比依赖异常可靠。正文里的路径必须放进代码块,平台会把方括号当成跳转链接吃掉,读者一点,表达式就从教程里消失。有的库根函数不可靠,取根元素用星号那一招更稳,这是原文集用同一种库时明确踩过的坑,不要当标准语法抄走。
要点速记
- 三条起步表达式:绝对
/bookstore/book、相对book/title、后代//title,先跑通再谈理论 - 步的结构:轴、节点测试、谓词;省略轴等于 child
- 双斜杠不是模糊匹配:它展开 descendant-or-self 再取 child
- 空结果先查上下文:相对路径在错误的当前节点上会静默变空
- lxml 的根:
/root()不可靠,用/*取根元素 - 别把路径写成超链接:方括号和斜杠在正文里用代码块包起来
下一节我们不急着写更长的路径,而是用已经能跑的表达式,把元素、属性、文本、注释逐个摸一遍。