1.2 用路径摸一遍七种节点
1.2 用路径摸一遍七种节点
本节摘要:XPath 不直接啃 XML 源文本,而是在七种节点构成的树上走路。元素、属性、文本、注释、处理指令、命名空间、文档节点各有选法。属性不是元素的 child——这是本节最值钱的一条,写错轴就会选空。
本节目标
阅读完本节,你应当能够:
- 用路径分别选出元素、属性、文本、注释
- 说明属性节点不属于 child 轴,要用
@或attribute:: - 区分文档节点与根元素
- 对「字符串值」和「节点本身」的差别给出例子
一、别在源码上数空格,在树上点名
很多人把 XML 当字符串用正则抠。书店样本里书名两侧没有多余空白还好;一旦缩进、换行、注释挤进来,正则就开始碎。XPath 的数据模型把文档收成树:每个标签、每段文字、每个属性都是节点。你点名,引擎返回节点,再决定要标签还是要字符串。
在样本上先跑这组,建立手感:
/bookstore → 根元素节点 /bookstore/book → 三个元素节点 /bookstore/book/@category → 三个属性节点 cooking / children / web /bookstore/book/title/text() → 三段文本 Everyday Italian 等
注意第四条:title 是元素,它的孩子才是文本节点。写 //title 拿到的是元素;很多库打印元素时看起来像书名,其实你拿到的是包裹文本的盒子。要纯字符串,显式 text(),或在宿主语言里读元素的字符串值。
原文集把七种节点列得很全。常用的是前四种。处理指令出现在样式表声明里,命名空间节点几乎只在绑前缀时碰到,文档节点是树尖上那个看不见的帽子。
二、七种节点各自怎么点
文档节点不是 <bookstore>。<bookstore> 是根元素,是文档节点的孩子。绝对路径开头的 / 停在文档节点。所以 /bookstore 读作「从文档节点走 child 轴,名叫 bookstore 的元素」。
元素节点构成骨架。* 匹配任意元素名:/bookstore/* 仍是三本 book,因为根下没有别的元素孩子。空白文本呢?缩进产生的换行往往是文本节点,不是元素,所以 * 看不见它们,node() 看得见。
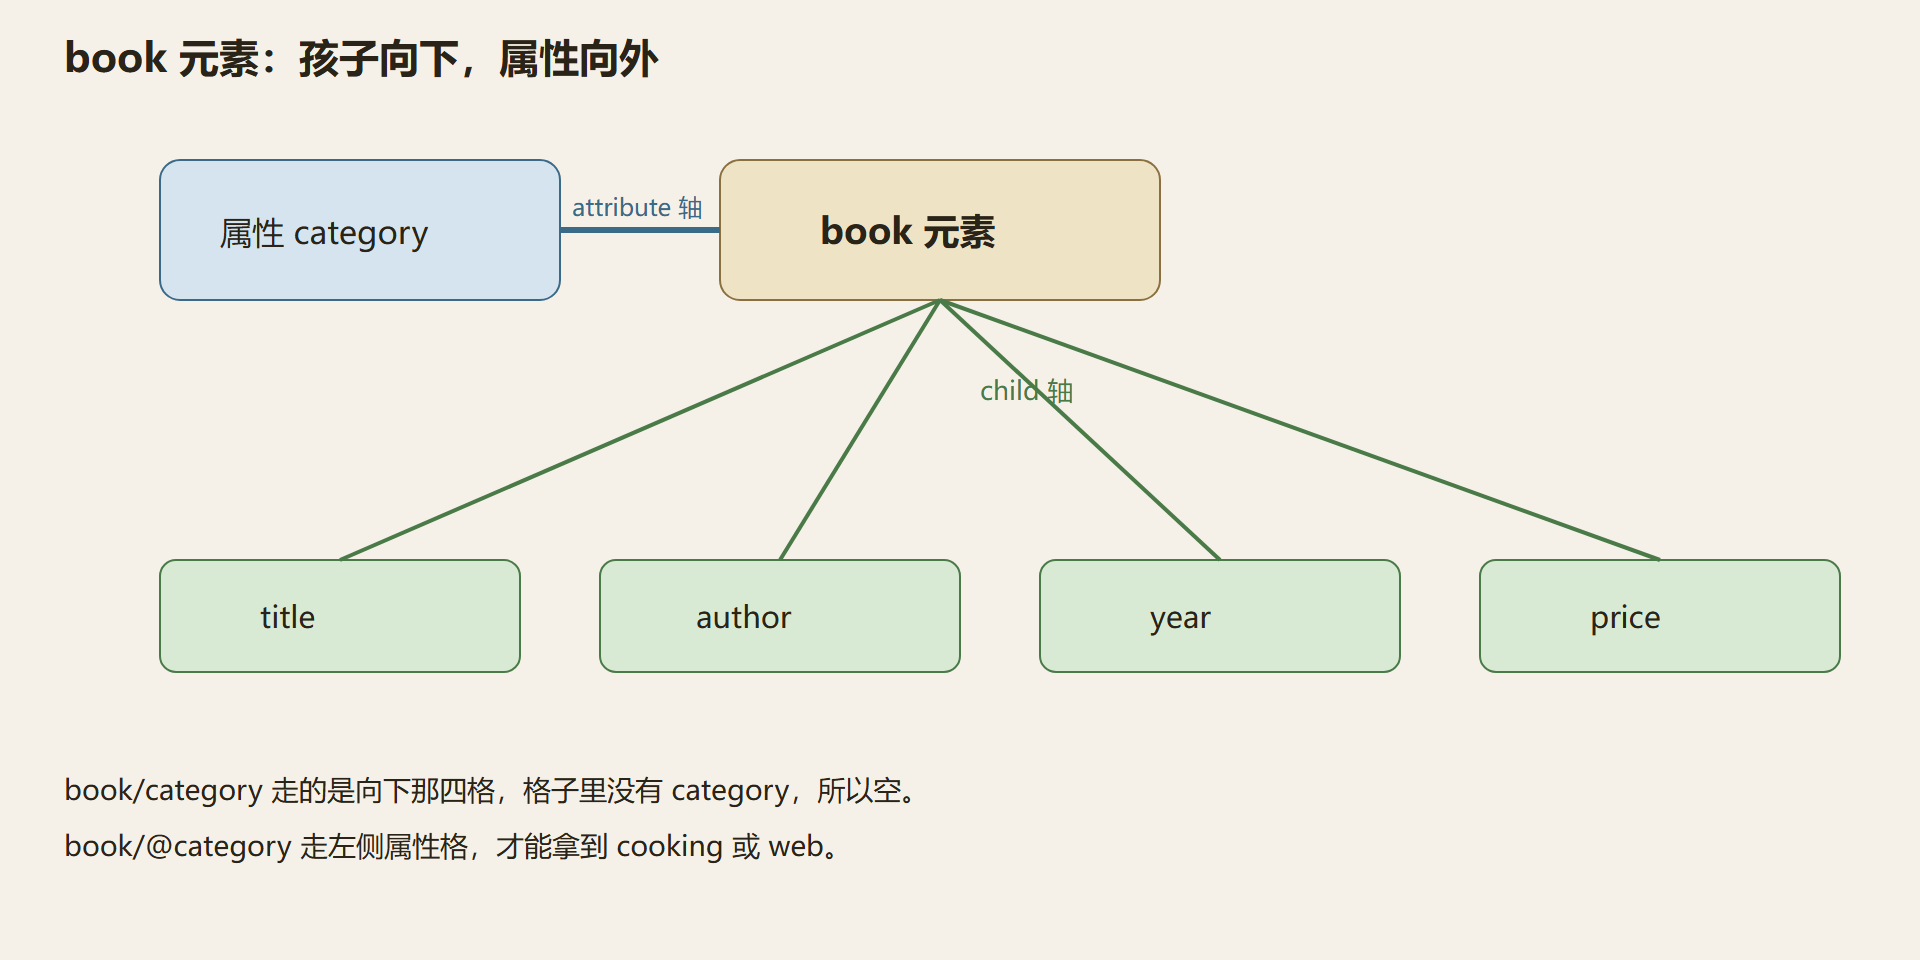
属性节点挂在元素上,但不是 child。book/category 会去找名为 category 的子元素,样本里没有,空。正确是 book/@category 或 book/attribute::category。这是数据模型里最容易踩的坑,不是语法糖问题。
文本节点用 text()。一个元素若被插进子元素,文本可能被拆成多段。string(title) 会把该元素下所有文本后代拼起来;title/text() 只取直接文本孩子。书店样本里 title 没有嵌套,两条等价。
注释节点 comment()。在 book 旁加 <!-- promo --> 后,/bookstore/comment() 能拿到。注释不是给用户看的数据,但清洗脏 XML 时经常要定位它们。
处理指令 processing-instruction()。常见形态是文档头附近的 stylesheet 声明。选的是指令节点,不是它指向的样式文件。
命名空间节点在 1.0 里可以沿 namespace 轴走。2.0 起这根轴基本废弃,改用 in-scope-prefixes 一类函数。本节只要记住:命名空间不是普通属性,尽管源码看起来像 xmlns:prefix="..."。
| 节点种类 | 怎么选 | 常见误写 | 你拿到的是 |
|---|---|---|---|
| 文档节点 | / |
把根元素当成文档节点 | 树尖 |
| 元素 | 元素名或 * |
用 @ 去选元素 |
盒子 |
| 属性 | @名 |
book/category 当属性 |
名值对 |
| 文本 | text() |
以为 //title 已是字符串 |
字符数据 |
| 注释 | comment() |
当子元素名去写 | 注释内容 |
| 处理指令 | processing-instruction() |
当属性 | 指令 |
| 命名空间 | 第 3 章绑前缀 | 把 xmlns 当普通 @ |
前缀到 URI |
⚠️ 常见坑:
//text()会把缩进空白一并带回。过滤空文本,或改用元素的字符串值。lxml 里元素.text只是第一个文本孩子,后面尾巴在.tail。
💡 关键直觉:属性像护照上的盖章,贴在人身上,但不是这个人的孩子。要盖章走 attribute 轴,要孩子走 child 轴。
图:属性不在孩子那一排
三、字符串值:引擎替你「拍扁」节点
XPath 1.0 里,元素出现在需要字符串的地方(比如和 'web' 比较),引擎取该元素的字符串值:后代文本按文档序拼接。book[1] 的字符串值大约是 Everyday ItalianGiada De Laurentiis200530.00,中间没有你想象的空格分隔(取决于源码空白文本有没有进树)。所以不要用「整个 book 等于某书名」来过滤,应写 book[title='Everyday Italian'],让比较发生在 title 的字符串值上。
string(节点集) 只转换第一个节点。string(//title) 得到 Everyday Italian,后面两本被丢掉。要所有书名,先选出节点集,在宿主语言里循环;或等 2.0 的序列处理(第 2 章、第 5 章)。
node() 匹配任意类型。/bookstore/node() 可能混着元素和空白文本。调试「为什么 count 比我看到的标签多」时,把 node() 打出来看一眼。
问题:为什么 //title[1] 不是「每本书的第一个 title」?
在 1.0 里,//title[1] 常被读成「整份文档里第一个 title」,实现细节依赖引擎如何展开 //。稳妥写法是 /bookstore/book/title[1](每本的第一个 title 孩子)或 (//title)[1](全集再取第一)。括号会改变谓词绑在哪一步上,1.4 节展开。
问题:HTML 的 class 是属性还是子元素?
属性。//div[@class='item']。写成 //div/class 是在找名为 class 的子元素,页面上几乎一定空。
四、文档序、字符串值和你以为的「空格」
XPath 给节点排的顺序叫文档序:源码里先出现的在前。三本 book 的顺序就是 cooking、children、web,位置谓词按这个序,不是按 category 字母序,也不是按价格。你若按价格排序,那是宿主语言或 XQuery 的 order by,不是 1.0 路径的职责。理解文档序,才能理解为什么 [1] 总是 Everyday Italian 那本,除非你先过滤成别的队伍。
字符串值会把后代文本按文档序拼接。book 的字符串值把书名、作者、年份、价格粘在一起,中间夹着源码里的换行和缩进——那些空白也是文本节点。所以你几乎永远不该写 book='Harry Potter'。比较发生在 title 上:book[title='Harry Potter']。若 HTML 里书名夹着 span,title 的字符串值仍能拼出完整书名,title/text() 却可能只拿到 span 前面那一小段。抓混排文本用字符串值或 normalize-space,不要迷信 text 函数总能拿到「看见的字」。
注释和处理指令在数据模型里是一等节点,在业务里通常不是。清洗时用 comment 轴或节点测试删掉它们;查询业务字段时不要让 node() 把它们算进 count,否则「根下有三个孩子」会对不上你眼睛数到的三个 book——中间可能夹着注释。原文集列出七种节点,不是要你每天都选命名空间节点,而是避免「怎么多出来几个」。
属性没有元素那样的「子树」。属性的字符串值就是属性字面。@category 的值是 cooking,没有再嵌套。不要对属性写 text(),有的引擎会空。需要属性值当字符串时,直接把属性节点放进需要字符串的地方,或显式 string。
命名空间节点在 1.0 可以沿 namespace 轴走,2.0 起这根轴基本废弃。本节只要你见到 xmlns 不要当成普通 at 属性去比相等来「选元素」。选元素靠第 3 章的前缀绑定。把七种节点记成「四种常用加三种遇到再查」,比假装每天都用满七种诚实。
五、属性当孩子写为什么空,字符串值为什么不能当书名
book/category 走 child,格子里没有名为 category 的元素,空。book/@category 走到盖章,cooking 或 web。这是数据模型最值钱的一条。//title 拿到盒子,title/text() 拿到字。string(//title) 只要 Everyday Italian。book='Harry Potter' 几乎永远假,因为 book 的字符串值是书名作者年份价格粘在一起还夹空白。应写 book[title='Harry Potter']。//text() 带回缩进空白。node() 让 count 对不上眼睛数到的标签。//title[1] 与 (//title)[1] 绑定不同。HTML class 是属性不是子元素。注释用 comment(),不要当业务字段。命名空间节点第 3 章再绑。文档节点不是根元素。属性没有 text() 子树。
练习:把 book/category 与 book/@category 各跑一次,确认前者 0 后者 3。对 string(//title) 与循环取 .text 对照。用 book[title='Harry Potter'] 命中第二本。打印 count(/bookstore/node()) 看是否大于元素孩子数。这四项钉属性轴、string 偏心、比较落在 title、空白文本是节点。七种里日常用四种,其余遇到再查。不要在源码上数空格当树。
六、先认盒子再认字再认盖章
书名标签是盒子,盒子里的文字才是要打印的内容。选中盒子再在宿主里读字符串,和直接选文本节点,两条路都能到字,打印出来却不一样。字符串转换若吃到一堆盒子,只拍扁队长那一本,后面直接丢,所以把所有书名拼成一句是宿主循环的活。属性像护照上的章,贴在人身上却不是孩子,用孩子方向去找分类名一定空,必须换属性方向。这个空和拼错元素名外表一样,排错要先问要的是孩子还是盖章。注释和处理指令在模型里是正式节点,在业务里通常不是,用任意节点去数孩子会把注释和缩进空白算进去,数字对不上三本书。文档序决定编号,不是价格序。整本书的字符串值会把书名作者年份价格粘成一串还夹换行,不要拿整本书去和某个书名比。超文本里书名再套小标签,直接文本可能只剩一段,拍扁后代才能拼全。七种不必每天用满。
把分类写成孩子名字去找,数一定是零;写成盖章去揭,数应当等于书的本数。这一对对照比任何定义都硬。书名写成盒子,拿到的是盒子;再取直接文字孩子,拿到的是字。转换函数打在全部书名盒子上,只留下第一本的字,这是偏心,不是优化。循环宿主才能拿到三行书名。缩进空白也是字,用任意节点去数总馆孩子,数字会大于元素孩子数,多出来的往往是难看的空白和注释。业务查询不要用任意节点当所有标签。
整本书的字符串值会把口袋里所有纸条粘成一长串还夹换行,拿整本书去和某个书名比相等,几乎永远假。比较必须落在书名盒子上。超文本里书名再套一层小标签,直接文字孩子可能只剩一小段,拍扁后代才能拼出完整标题。抓混排标题用拍扁或先压空白,不要迷信直接文字总能拿到看见的字。文档从头到尾谁先出现谁是一号,不是谁更贵谁是一号。位置课建立在文档序上,不要用价格序去赌编号。
注释和处理指令有正式座位,清洗时可以单独请它们离席,查询业务字段时不要让它们混进计数。命名空间那一席看起来像源码里的属性声明,数据模型里却不是普通盖章,选元素靠后面专章绑贴纸,不要用揭章的办法去「选空间」。文档节点是帽子,根元素是帽子下面的头,绝对走法开头那一撇停在帽子上。帽子和头搞混,第一步的名字就会写错。七种里日常用盒子、盖章、字、注释四种,其余遇到再查,比假装每天用满诚实。
一节小结
- 先点名再取字符串:
//title是元素盒子,text()或字符串值才是字 - 属性不是 child:必须
@或attribute:: - 文档节点 ≠ 根元素:绝对路径第一斜杠停在文档节点
- string 只拍扁第一个节点:不要指望它返回所有书名
- 空白文本是节点:
node()和count会把它算进去 - 七种里日常用四种:元素、属性、文本、注释;其余遇到再查
下一节换方向:从当前节点走向父、后代、兄弟,并把
@、//还原成轴的简写。