第1章 先写出能选出节点的路径
第 1 章 · 先写出能选出节点的路径
章节摘要:XPath 的最小可用单位是路径表达式。本章不从「什么是查询语言」起讲,而是对着同一棵书店树写出绝对路径、相对路径和双斜杠,摸清七种节点,再用轴换方向、用谓词加筛选。读完你应当能独立写出命中指定书名或属性的表达式,并解释空结果通常出在哪一步。
先说结论
阅读完本章,你应当能够:
- 写出从文档根出发的绝对路径,以及相对当前上下文的相对路径
- 判断双斜杠会扫整棵后代树,并在小文档上验证命中集合
- 用路径分别碰到元素、属性、文本、注释、处理指令
- 用 child、parent、descendant、sibling、attribute 轴换方向
- 在方括号里写位置、属性相等、数值比较和 and/or 条件
- 对空节点集做三步排查:上下文、轴、谓词
核心概念速览
金句:XPath 先走步,再过滤;步走错了,谓词再精也是空。
图:一条路径怎么拆成三截
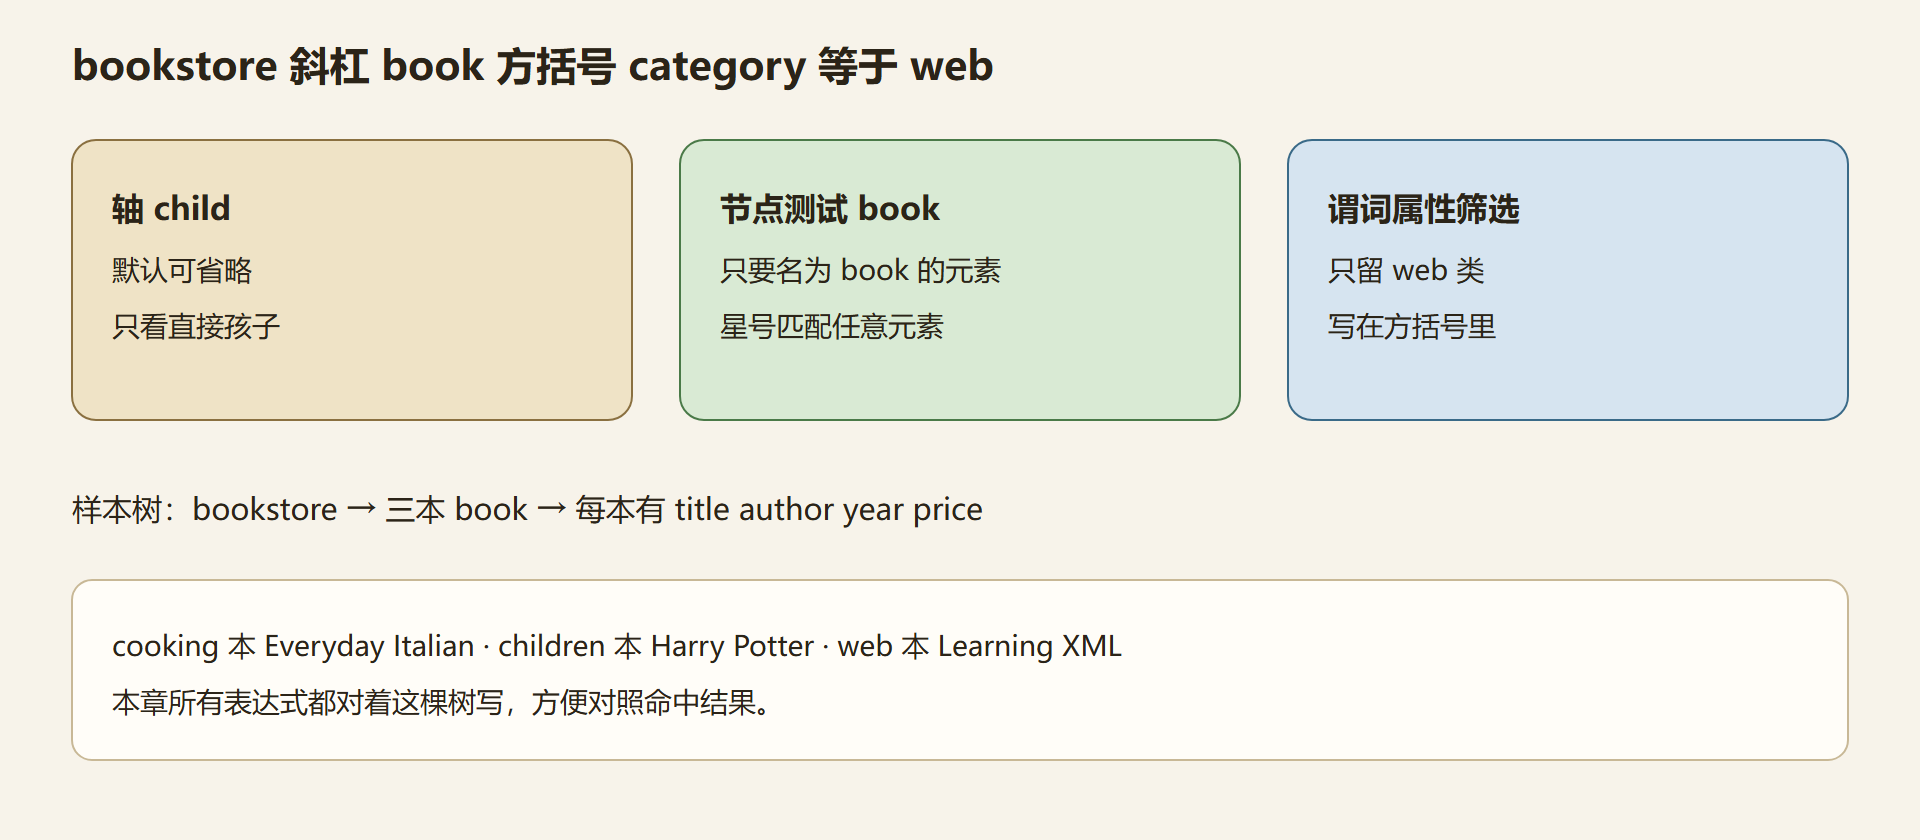
子章节导航
1.1 第一条能跑的路径
从 /bookstore/book、book/title、//title 三条表达式入手,分清绝对、相对、后代三种走法,以及上下文节点如何改变相对路径的含义。
1.2 用路径摸一遍七种节点
元素只是树的骨架。属性用 @,文本用 text(),注释用 comment()。属性不是元素的 child,这点会直接决定你的轴怎么写。
1.3 轴:往上往下往旁边走
默认轴是 child。需要父、祖先、后续兄弟、属性时,显式写出轴名。简写 @ 和 // 都对应某条轴,不是魔法符号。
1.4 谓词:方括号里写筛选
位置 [1]、last(),属性 [@category='web'],数值 number(price)>35,组合 and/or。谓词作用在「当前步已经选中的节点」上。
子章节之间的逻辑关系
先让路径命中一堆节点,再弄清命中的是哪种节点,然后换方向,最后过滤。跳过前两节直接写轴,容易把「选不中」误判成「轴名记错」。
1.1 写出三条能跑的路径 │ ▼ 1.2 摸清命中的是哪种节点 │ ▼ 1.3 换方向:父、后代、兄弟、属性 │ ▼ 1.4 在已选中的集合上加方括号过滤
本章你要建立的手感
路径不是字符串匹配。你在源码里看见连续的标签名,并不等于可以按键盘顺序把它们拼成表达式。中间若隔着一层包装元素,绝对路径必须把那一层写出来;你图省事写成双斜杠,等于授权引擎去扫整棵后代。本章四节就是把这点变成肌肉记忆:先命中,再认节点种类,再换方向,最后才过滤。
很多人第一次空结果发生在「我明明写了 book 的 category」。他们写的是子元素路径,数据模型里 category 是属性,必须走 attribute 轴。1.2 会把这件事画成「盖章贴在人身上,但不是这个人的孩子」。不要把 1.2 当成理论课跳过,否则 1.3 的轴表只是另一张要背的清单。
| 节 | 你跑通的最小表达式 | 过关标准 |
|---|---|---|
| 1.1 | 绝对、相对、双斜杠三条 | 能说出相对路径依赖上下文 |
| 1.2 | 属性、文本、元素各一条 | 不再用子元素写法去选属性 |
| 1.3 | 后续兄弟、父、祖先各一条 | 能把 at 与双斜杠还原成轴 |
| 1.4 | 位置、属性、数值、组合各一条 | 能解释括号如何改变谓词绑定 |
四本书样本会在 1.3 和 1.4 登场。三本书时「最后一本」和「第三本」容易混,四本才能把 last 与位置 3 拆开。作者节点在 Kick Start 那本是两个,用来证明 author[1] 是「每一本的第一个作者」而不是「文档里第一个作者」。这些细节都来自原文集的 lxml 实践,不是为了凑例子硬编的。
读完本章,你应当能对着一棵没见过的小 XML,先写出从根到目标的 child 链,再用方括号把不要的砍掉。若第一步就写双斜杠加星号,本章算没读进去。函数、命名空间、语言 API 都假设你已经能命中节点——空地上无法修扳手。
常见卡点
读本章时最容易发生的三件事:一是跳过 1.1 直接背轴表,结果相对路径的上下文从来没建立过;二是把属性当子元素写,空了却去改谓词;三是一上来双斜杠加星号,样本太小看不出代价,到了 HTML 才抱怨慢。这三件事分别对应 1.1、1.2、1.3 的过关标准,过不了不要赶去 1.4。谓词是筛子不是路,人还没走到,筛子再细也是空地。把这句话贴在编辑器旁边,比再读一遍轴表有用。
和文件系统路径的类比同样有用也有害。有用的是斜杠表示往下走一层、两点表示往上。有害的是文件系统没有属性轴、没有谓词、没有文档序。不要把通配符星号理解成「任意文件名含 book」,它只匹配元素节点。文本、属性、注释都要各自的节点测试。本章结束时你应当能不看表写出三条起步路径,并解释为何 /book/title 在这份样本上是空——根元素不叫 book。这个解释说得清,第 2 章的函数才有地方可挂。
书店样本会陪你到第 5 章。三本版本讲绝对路径和价格;四本版本讲位置和兄弟。作者节点在 Kick Start 上是两个,用来拆穿「第一个作者」的两种读法。这些不是装饰,是夹具。对着夹具 count,比对着脑海中的树争论更接近真实工作。
前置知识与后续延伸
- 前置知识:会看 XML 标签嵌套;不要求先学 Schema 或 XQuery。HTML 读者只要知道标签会建成树即可。
- 后续延伸:第 2 章把函数塞进谓词;第 3 章处理命名空间导致的「路径明明对却是空」;第 4 章把同一条路径接到 lxml 与 Java。