1.3 轴:往上往下往旁边走
1.3 轴:往上往下往旁边走
本节摘要:轴规定从当前节点朝哪个亲属关系走。默认 child,可省略。父、祖先、后代、前后兄弟、属性各有全名和少数简写。先用四本书样本把 sibling 跑通,再记轴表——方向走错,节点测试写对也是空。
你能学到什么
阅读完本节,你应当能够:
- 把
@还原成attribute::,把//还原成 descendant-or-self 再 child - 用 parent、ancestor 从 title 走回 bookstore
- 用 following-sibling / preceding-sibling 在 book 之间平移
- 说清 child 与 descendant、parent 与 ancestor 的包含关系
一、从当前书往旁边挪一本
本节改用原文集 1.3 的四本书样本,否则「第三本之前的兄弟」故事讲不圆:
- cooking · Everyday Italian
- children · Harry Potter
- web · XQuery Kick Start(两个 author)
- web · Learning XML
上下文若在第一本 book 上:
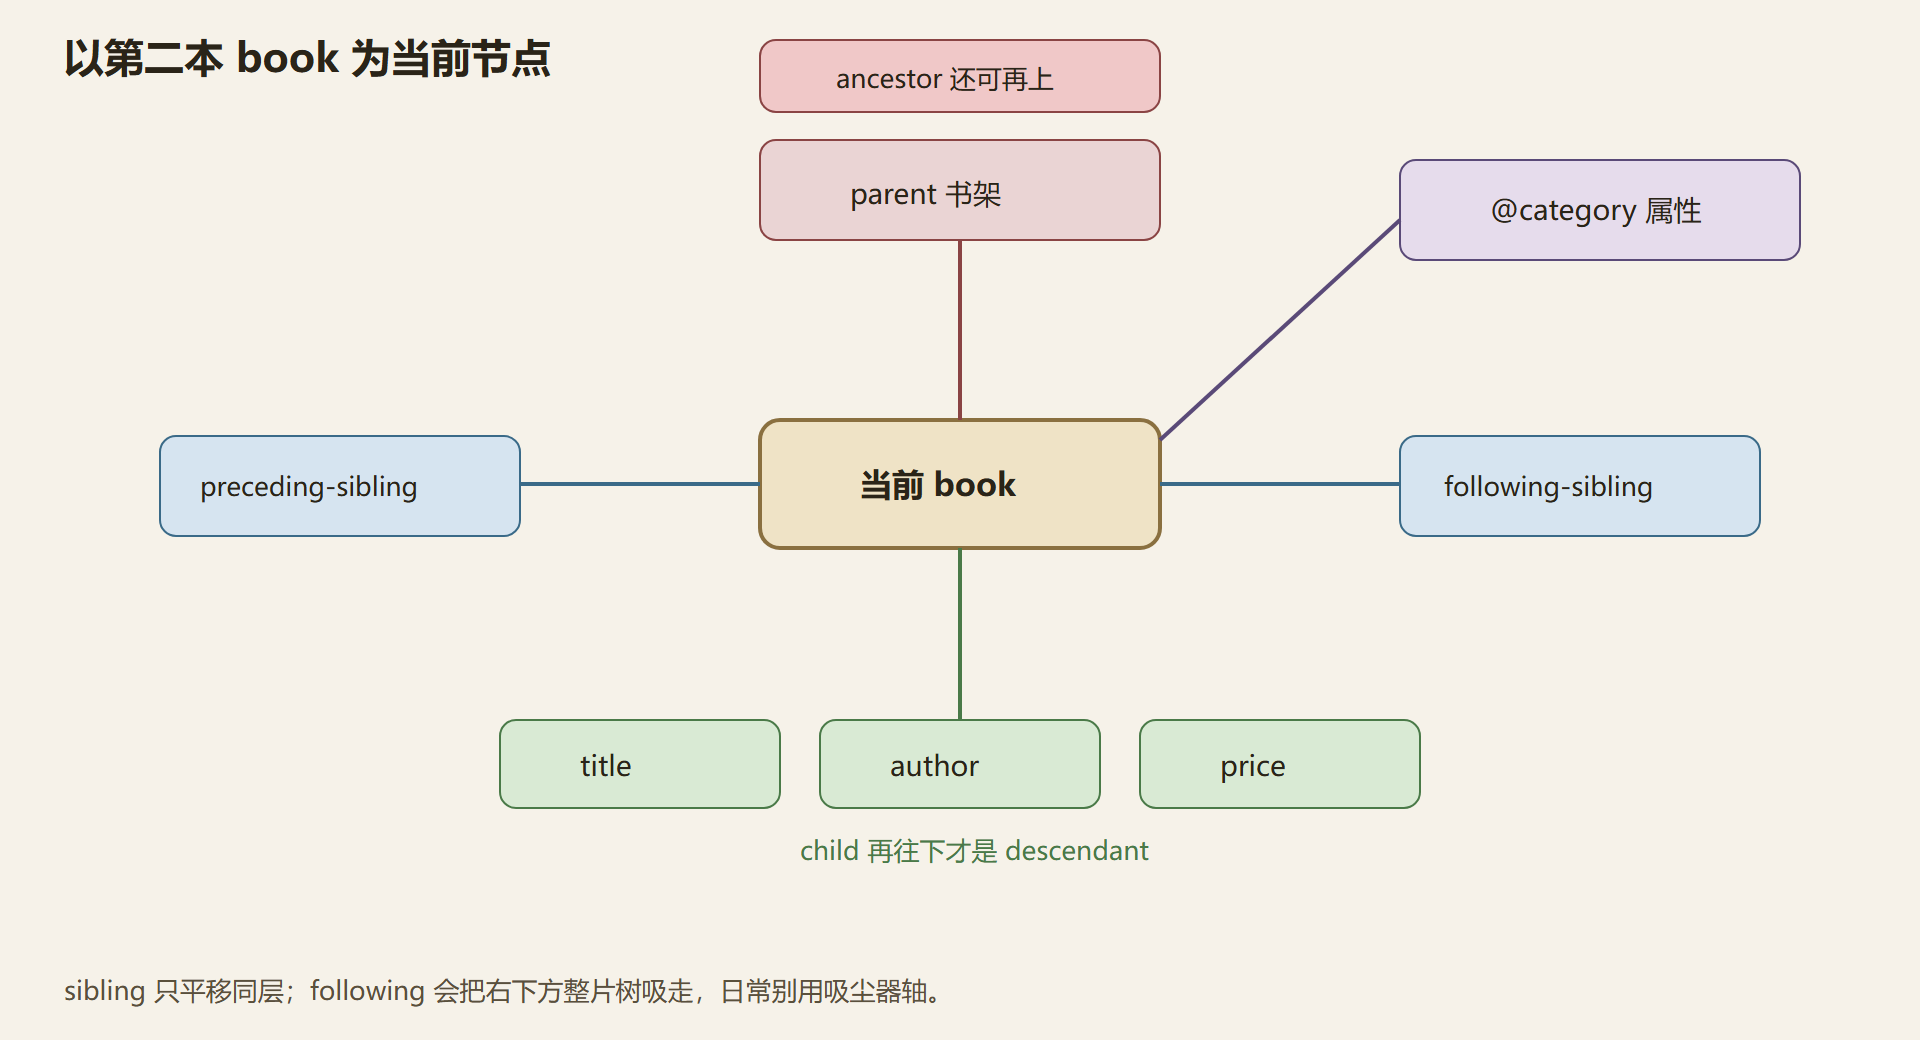
child::title → Everyday Italian 那个 title following-sibling::book → 后面三本 following-sibling::book[1] → 紧邻的 Harry Potter 那本 parent::bookstore → 书架根
从根出发的写法要带路径前缀:/bookstore/book[1]/following-sibling::book。lxml 示例里,对根元素求 book[1]/following-sibling::book 得到 children 与两本 web。book[3]/preceding-sibling::book 得到前两本。这组结果是原文集用 lxml 跑过的,可当对照。
我把轴当成地铁换乘:child 是下一站,descendant 是这条线往后所有站,parent 是上一站,ancestor 是回总站途中每一站,following-sibling 是同一站台后面的车,attribute 是车身上的线路编号——编号不在车厢里面。
二、常用轴对照
完整一步:轴::节点测试[谓词]。节点测试可以是名字、*、text()、node()。
| 轴 | 简写 | 含不含自己 | 典型用途 |
|---|---|---|---|
| child | 省略 | 不含 | 默认往下一级 |
| descendant | 无 | 不含自己 | 跨层找子孙 |
| descendant-or-self | // 的前半 |
含 | 双斜杠展开 |
| parent | .. |
单节点 | 从文本或属性走回元素 |
| ancestor | 无 | 不含自己 | 找最近的某类容器 |
| ancestor-or-self | 无 | 含 | 「自己或祖先里名叫 x」 |
| following-sibling | 无 | 不含 | 同层往后 |
| preceding-sibling | 无 | 不含 | 同层往前 |
| following | 无 | 不含 | 文档序之后几乎所有 |
| preceding | 无 | 不含 | 文档序之前几乎所有 |
| attribute | @ |
属性集 | 取属性 |
| self | . |
自己 | 谓词里限定类型 |
| namespace | 无 | 命名空间节点 | 1.0 遗留,少用 |
following 和 following-sibling 差很远。前者会把后面整棵树不在祖先链上的节点都收进来,调试时像吸尘器。日常平移用 sibling 足够。
原文集还提到 current() 和 root():current() 在 1.0 没有,出现在 XSLT 里表示起点;lxml 里 /root() 不直接工作,用 /*。别把 XSLT 的函数抄进纯 XPath 1.0 引擎。
self::book 看起来多余:当前已经是 book 时,它还是自己。价值在谓词:*[self::book or self::magazine] 从混合孩子里挑两类元素,比写两遍路径再在宿主语言合并干净。
⚠️ 常见坑:
title/ancestor::bookstore从任意 title 往上找名为 bookstore 的祖先,三本四本都能命中同一个根。若写成title/parent::bookstore则空,因为 title 的父是 book。parent 只走一层。
💡 关键直觉:轴解决「朝哪走」,节点测试解决「走过去之后叫什么」。先定方向,再定名字。
图:当前节点的亲属罗盘
三、简写还原,避免「符号魔法」
| 你写的 | 引擎看见的 |
|---|---|
book |
child::book |
@category |
attribute::category |
.. |
parent::node() |
. |
self::node() |
//book |
descendant-or-self::node()/child::book |
bookstore/descendant::title 与 bookstore//title 在「title 是元素」时通常同结果。差别出现在你想选后代文本或注释时:descendant::text() 必须写全名,没有 //text 这种省略(//text() 其实是 descendant-or-self 再 child::text(),对直接文本孩子成立,对更深文本也成立,但中间若隔着别的结构要自己试)。动手时以引擎输出为准,不要靠类比猜。
* 在 child 轴是任意元素;@* 是任意属性。book/@* 一次拿出该元素全部属性。HTML 抓取时常用这招看「这个节点到底贴了哪些盖章」。
性能上,从已知父走 child 比从根 // 便宜。第 4 章会把这条写成硬建议。现在先养成习惯:能写 /bookstore/book/title 就别写 //title,除非 title 可能出现在未知深度。
原文集 Python 示例还演示了 book[self::book][1]——self 在这里多余,book[1] 已经是第一本。保留它只为说明 self 合法,日常删掉。
问题:从属性节点怎么回到元素?
属性的 parent 是拥有它的元素。若上下文已是 @category,.. 回到 book。有的宿主 API 选出属性后给你的是字符串,不是属性节点,这时没有父可走,要在选出属性之前就停在元素上:book[@category='web']。
问题:ancestor::book[1] 是最近的 book 还是最远的?
谓词里的位置按轴的方向计数。ancestor 轴的方向是先父再祖,[1] 通常是最近的那个 book。不要用「文档从头数第一个 book」的直觉套在祖先轴上。
四、从 title 走回去,以及轴的包含关系
练习:上下文在任意一本的 title 上,要拿到这本的 category。正确走法是父轴到 book,再 attribute 轴到 category。写成 ancestor::book/@category 也行,因为祖先链上通常只有一个 book;若书名嵌套在更里层的包装元素里,ancestor 仍能找到最近的 book,parent 则只走到包装层,属性还是空。这就是「parent 一层、ancestor 整条链」在脏 HTML 里的差别。
child 不含自己,descendant 也不含自己。想「自己或者名叫 book 的后代」用 descendant-or-self。双斜杠的展开式带 descendant-or-self,所以 //book 在当前节点自己就叫 book 时也会包含自己——这条在「已经站在 book 上再写双斜杠 book」时会让集合里多一个自己,谓词位置全部错位。相对路径在错误上下文上的第二种病:不是空,是多。
following 与 following-sibling 的差别值得用四本书再走一遍。站在第二本,following-sibling 是第三本和第四本。following 还会把第二本内部尚未走出的节点之后、以及后面书里的 title、author 全收进来,集合瞬间膨胀。调试输出一长串标签名时,先看你是不是手滑写成了 following。日常平移只用 sibling。
namespace 轴在现代代码里几乎绝迹。self 轴在混合孩子里有用:*[self::book or self::magazine]。原文集示范的 book[self::book][1] 是合法废话,提交前删掉。root 作为轴名在 2.0 函数里另有说法;1.0 取根元素用 /*,取文档节点用 /。lxml 对 /root() 不买账,这是原文集明确踩过的坑,不要当标准语法抄走。
把简写还原成全名再排错,比背口诀稳。看见 at 就读 attribute;看见双斜杠就读 descendant-or-self 再 child;看见两点就读 parent 任意节点。还原之后,节点测试是不是写错一目了然。
五、从第二本 title 走回 category,再平移到下一本
上下文在 Harry Potter 的 title 上。parent 一次到 book,attribute 取 category 得 children。写成 parent::bookstore 则空,title 的父是 book。ancestor::bookstore 能到根。ancestor::book[1] 通常是最近的 book,不要理解成文档里第一本。站在第二本 book 上,following-sibling::book 是 Kick Start 与 Learning XML;following-sibling::book[1] 是 Kick Start。following 还会吸进后面的 title 文本等,集合膨胀。日常只用 sibling。
@ 还原 attribute,// 还原 descendant-or-self 再 child。站在 book 上再写 //book 可能把自己也算进去,位置谓词错位。这是相对路径的第二种病:不是空,是多。lxml 取根元素用 /*,不要 /root()。self 在混合孩子里有用,单独写常常多余。从属性走两点回到元素再取 title,合法。
练习:固定上下文在第二本 title,分别求 parent、ancestor bookstore、following-sibling book 的 count。三个数字应当是 1、1、2。再求 following 的 count,确认比 2 大。把简写还原成全名写在注释里给同事看。namespace 轴现代代码不用。attribute 不是 child,1.2 的盖章比喻在这里变成轴的选择。
六、方向错了名字对也走不到
默认只往下走一层,省略轴名不表示任意方向。父一层,祖先整条链。从书名取分类要先回到书再取盖章;写成父是书店根就会空。脏页面书名外再包一层包装,父停在包装上,祖先还能找到书,这是两根轴分胜负的现场。兄弟只在同一层平移,那根吸尘器会把后面几乎所有节点吸走,输出一长串时先看是不是写错轴。简写要还原:圈记是属性,双斜杠是自己及后代再取孩子。已经站在书上再写双斜杠书,可能把自己算进去,编号全错,这是相对路径第二种病:不是空是多。有的库根函数不可用。自身轴在混合孩子里挑两类标签有用,单独写常是废话。从属性走两点回到元素再取书名合法。日常把方向选对,比把全部轴名背熟值钱。站在第二本书名上,父应是书,后续兄弟书应是两本,吸尘器应比两本大,这三个数字能对上,轴就算练过。
固定站在第二本书名上做三次数。上一站应当是书,数一;沿祖先找总馆,数一;后续兄弟书应当是两本。那根几乎吸走整张路网的方向,数会明显大于二。四个数字对得上,方向课才算做过,而不是只看过一张罗盘图。脏页面书名外再包包装,上一站变成包装,祖先还能找到书,这是两根轴分胜负的现场,要用带包装的夹具才能看见,干净样本里父和祖先常常撞车,让人误以为两者一样。
已经站在书上再授权整栋楼搜书,可能把自己算进集合,编号全错。这是相对走法的第二种病:不是空,是多。多比空阴,因为看起来「有结果」,只是结果里多了一个自己,后面的筛选编号全部错位。简写必须能还原:圈记还原成属性方向,双斜杠还原成自己及后代再取孩子。还原之后才知道引擎实际走哪条线,排错才有语言可以讲。有的实现不认根函数,取根元素用星号。自身方向在杂牌子孩子里挑两类牌子有用,单独写常常是合法废话,提交前删掉。
从盖章走两点回到人再取口袋,合法且常见。有的宿主接口选出盖章后只给你字符串,不再给你节点,这时没有父可走,要在揭章之前就停在人身上,用带盖章条件的筛选留人。祖先轴上的一号通常是最近的那位长辈,不要理解成文档里第一本同名的书。日常平移只用兄弟,吸尘器留给明确需要文档序之后几乎所有节点的稀有情况。把方向选对,比把全部轴名背熟值钱。
原文集用同一种库演示过从第一本书走向后续兄弟、从第三本走向前序兄弟、从书名走向祖先总馆。那些输出可以当对照:后续兄弟应拿到儿童类和两本网络类,前序兄弟应拿到烹饪和儿童。自己对照时若数字对不上,先看上下文是不是仍在那一本书上,而不是先怀疑轴名拼写。默认省略的是往下走一层,写成显式孩子方向应当与省略完全一致,这是检查引擎有没有把省略理解成任意方向的办法。命名空间方向在现代代码里几乎绝迹,看见教程还在示范它,当历史遗留即可,日常选元素靠绑贴纸不是靠走那根轴。根作为轴名和根作为函数在不同版本里说法不同,动手时以你手上的库为准,低版本取根元素用星号更少意外。
固定上下文在第二本书名,分别求父、祖先总馆、后续兄弟书的计数,三个数字应当是一、一、二。再求吸尘器方向的计数,确认比二大。把简写还原成全名写在注释里给同事看。命名空间方向现代代码不用。属性不是孩子,盖章比喻在这里变成方向的选择。原文集用同一种库演示过后续兄弟和前序兄弟的输出,可以当对照。默认省略的是往下走一层,写成显式孩子方向应当与省略完全一致。脏页面包装层让父和祖先分胜负。已经站在书上再整栋楼搜书会多算自己。从盖章走两点回到人再取口袋合法。祖先上一号通常是最近长辈。日常平移只用兄弟。
核心回顾
- 默认轴是 child:省略不等于「任意方向」
- parent 一层,ancestor 整条链:选错就空
- sibling 平移,following 吸尘:日常用 sibling
@和//是简写:还原成轴再排错- lxml 用
/*取根元素:不要抄/root() - self 用在混合节点测试:单独写常常多余
下一节把筛选从「换方向」里拆出来:方括号谓词按位置、属性、数值和逻辑组合切割已经选中的节点集。