1.4 谓词:方括号里写筛选
1.4 谓词:方括号里写筛选
本节摘要:谓词写在方括号里,对「当前步已经选中的节点」逐个做真假判断。位置、属性相等、数值比较、存在性、and/or 都是谓词。括号会改变谓词绑在哪一步。字符串比大小和数字比大小不是一回事——样本里 39.95 那本最能说明问题。
阅读收获
阅读完本节,你应当能够:
- 用
[1]、last()、position()取节点集里的位置 - 用
[@category='web']和[author]做属性与存在性过滤 - 用
number(price)>35做数值比较,避开纯字符串比较的坑 - 解释
(//book)[1]与//book[1]可能不同
一、先切出「贵的那本」
三本书样本里,Learning XML 的 price 是 39.95,另外两本约 30。目标:只要贵的。
/bookstore/book[number(price)>35]/title
期望书名:Learning XML。
原文集用 lxml 对比过两条:
bookstore/book[price>35]:把 price 当字符串比,碰巧'39.95'大于'35'也能蒙对,换一组价格就翻车bookstore/book[number(price)>35]:显式转数字,这是我主张的写法
位置谓词对着四本书样本更清楚:
/bookstore/book[1] → Everyday Italian 那本 /bookstore/book[last()] → Learning XML 那本 /bookstore/book[position()<=2] → 前两本 /bookstore/book[3] → XQuery Kick Start 那本
[1] 不是「文档里第一个 book 元素」的全局编号,而是当前这一步产生的节点集里的第 1 个。所以 /bookstore/book/author[1] 是「每一本的第一个 author」。XQuery Kick Start 有两个 author,这条仍只拿 James McGovern;要「整份文档第一个 author」得写成 (//author)[1]。
二、谓词在干什么
引擎对当前步的每个候选节点:把该节点设为上下文,计算括号里的表达式。
- 结果是数字:当它等于
position()时为真。所以[last()]能工作——last()返回集合大小,与当前位置相等的那一个留下。 - 结果是布尔:真则留。
- 结果是节点集:非空为真。所以
[author]表示「具有 author 子元素」,三本都有,count 为 3。 - 结果是字符串:非空为真,较少直接这么写。
| 类型 | 例子 | 留下谁 | 注意 |
|---|---|---|---|
| 位置 | book[2] |
第 2 本 | 相对当前步 |
| 末位 | book[last()] |
最后一本 | last 是函数 |
| 属性 | book[@category='cooking'] |
Everyday Italian | 引号别混 |
| 子元素值 | book[title='Harry Potter'] |
第二本 | 比的是 title 字符串值 |
| 数值 | book[number(price)>35] |
Learning XML | 先 number |
| 存在 | book[author] |
有 author 的 | 不看内容 |
| 组合 | book[@category='cooking' and number(price)<35] |
第一本 | and 优先级 |
| 否定 | book[not(@category='cooking')] |
非 cooking | not 是函数 |
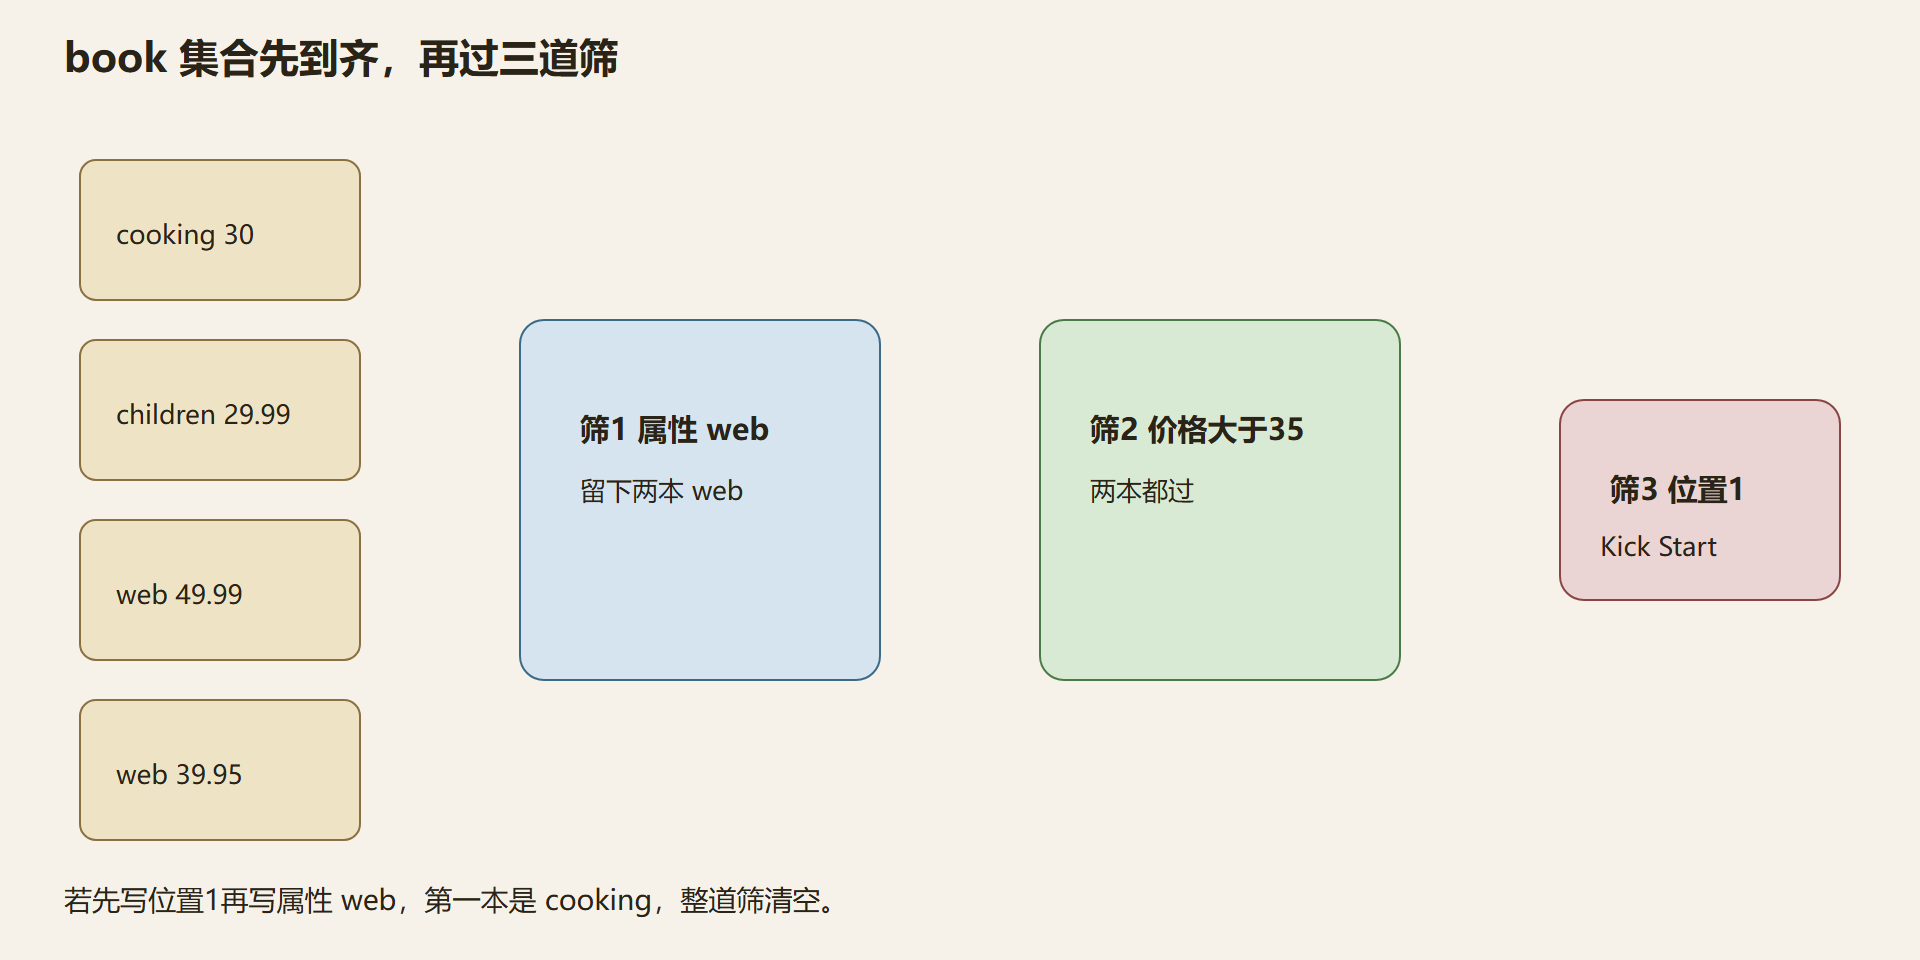
多个谓词是连续过滤:book[@category='web'][1] 先留 web 类,再取这个子集的第一本——四本书样本里是 XQuery Kick Start,不是整份文档第一本。book[1][@category='web'] 则先取第一本再看它是不是 web,cooking 那本被否掉,空。顺序有意义。
⚠️ 常见坑:HTML 里把
[2]当「第二个 class」用。谓词位置是节点集位置,不是属性里空格分开的词。class 含某个词,用contains(concat(' ',@class,' '),' item ')这类技巧,或把工作交给 CSS。
💡 关键直觉:谓词不负责走路,只负责砍人。人还没走到,谓词砍的是空地。
图:谓词是筛子,不是路
三、比较、括号、空结果排查
相等:XPath 1.0 的 = 会做存在量化。book[author='Per Bothner'] 在多 author 时,任一 author 等于该字符串即真,XQuery Kick Start 能命中。这和「全部 author 都等于」不是一回事。!= 更绕:存在一个不相等就可能为真。多值比较我更倾向 not(author='x') 或把条件写到具体的 author 步上。
数值:始终 number(...)。空 price 转数字是 NaN,任何与 NaN 的比较为假,该书被丢,不会报错。
逻辑:and、or;否定是函数 not(),没有 ! 前缀运算符(那是别的语言)。
括号:(//book)[1] 先得到全部 book 再取第一;//book[1] 绑在 child::book 那一步,含义随 // 展开而变。需要「全集的第 n 个」就加括号。
排查空结果我按这个顺序:上下文是否仍在以为的节点 → 这一步轴对不对(属性写成了 child)→ 谓词是否过严(先去掉谓词看集合多大)→ 是否该 number()。不要一上来改函数。
问题:book[price] 和 book[price>0] 谁更宽?
[price] 只问有没有这个子元素,空标签也算有。[price>0] 要比较字符串值,空字符串转数字失败,通常为假。有标签没内容时,存在性谓词更宽。
问题:能不能在谓词里再写路径?
能。book[title/@lang='en'] 从候选 book 往下探 title 的 lang。谓词里的路径相对当前候选,不是相对文档根。写成 book[/bookstore/...] 会从根另起一条,偶尔有用,多数是误写。
四、位置谓词与过滤谓词不要写反
评审表达式时我先问:方括号里是数字还是条件。数字走位置语义,条件走真假语义。把它们写反的典型是 book[last()-1] 想表达「不要最后一本」——那会留下倒数第二本,不是去掉队尾的集合。去掉队尾应写 book[position()!=last()]。last()-1 是一个数字,当位置用。
and 与 or 的优先级按规范 and 更紧。拿不准就加括号。book[@category='web' or @category='children' and number(price)>35] 很容易读成人话「web 或 children 且贵」,实际绑定不一定按人话。写成 book[(@category='web' or @category='children') and number(price)>35] 才是你想的。谓词里少玩优先级游戏。
存在性谓词 [author] 在 Kick Start 那本仍然为真,因为它有作者,不管有几个。要「恰好两个作者」用 count(author)=2。这是 2.1 的 count 提前借用,允许。要「作者文本包含 Bothner」写 book[author[contains(.,'Bothner')]]:外层筛书,内层筛作者节点。只写 contains(author,'Bothner') 时,1.0 对节点集参数偏心第一个作者,James McGovern 那一段不含 Bothner,书会被丢掉。谓词嵌套是为了把函数的偏心限制在正确的那一层。
空结果排查我实际操作是四刀:去掉所有谓词看 count;count 为 0 则回到轴和上下文;count 很大再一把一把加回谓词;价格条件单独拿出来对单本求 number(price) 看是不是 NaN。不要四刀同时砍,否则不知道哪一刀起作用。
HTML 的 class 属性经常是空格分隔的多词。[@class='item'] 要求整段字面相等,class="item active" 为假。contains 又会误伤 item-old。土法是前后补空格再 contains。这不是谓词理论,是 HTML 现实。能改用 CSS 的 class 选择器就改;必须用 XPath 时把这土法写成固定片段,不要每次现场发明。
五、谓词顺序现场:web 再取第一,对 先取第一再看 web
四本书。book[@category='web'][1] 先留两本 web,再取这支队伍第一本,Kick Start。book[1][@category='web'] 先取 cooking,再问是不是 web,空。同一组方括号,顺序决定有没有结果。数字谓词比位置,last()-1 是倒数第二本,不是「去掉最后一本」;去掉队尾用 position()!=last()。and 加括号。contains(author,'Bothner') 偏心第一作者会丢掉 Kick Start,要 author[contains(.,'Bothner')]。class 多词不要整段相等。空结果四刀:摘谓词、查轴、一把把加回、单独看 number。
练习:把上面两条顺序相反的路径都跑一遍,记下 title。再写「去掉最后一本」的正确谓词,确认留下前三本。给 Kick Start 的第二作者做 contains,确认书能留下。这三项覆盖顺序、位置语义、嵌套谓词限制偏心。HTML class 土法前后补空格,能改 CSS 就改。
六、筛子不负责找路只负责砍人
方括号里是数字就比位置,是条件就比真假,写反会得到倒数第二本而不是去掉队尾。去掉队尾要写位置不等于队长。多个方括号按书写顺序连滤:先留网络类再取第一本,得到的是该类队长;先取第一本再问是不是网络类,烹饪那本被否掉,空。顺序有意义。逻辑组合加括号,不要靠优先级赌人话。多作者时字符串函数偏心第一个作者,要把函数放到作者那一层再往外筛书。分类多词不要整段相等。价格比较先转数字,空价格变成非数,比较全假,书蒸发。空结果四刀:摘掉所有筛选看大小,为零查方向和护照,不为零一把把加回,价格条件单独打印转换结果。存在性只问有没有这个孩子,不管里面有没有字;有标签没内容时存在性更宽。谓词里再写路径,相对的是当前候选书,不是文档根。
用四本书把顺序相反的两条筛选都跑一遍。先留网络类再取一号,书名应是入门那本;先取一号再问是不是网络类,应空。把两行写在纸上对照,顺序课才算过。去掉队尾应写位置不等于队长,写成队长减一留下的是倒数第二本。数字进方括号就是比位置,不是比个数。逻辑组合加括号,人话「网络或儿童且贵」和引擎绑定不一定一样,拿不准就加括号,少玩优先级。
多作者那本第二位才含目标姓氏时,把包含直接打在作者集合上会偏心第一位,书被丢掉。正确是让每一位作者自己做包含,再让书因为存在这样一位作者而留下。这是嵌套筛选限制偏心的典型。分类若是空格隔开的多词,整段相等会拒绝带附加词的;包含又可能误伤词头。能改用另一套选择器就改;必须用路径时前后补空格再包含,写成固定片段,不要每次现场发明。
价格条件单独打印转换结果。空标签变成非数,比较全假,书蒸发却不报错。存在性只问有没有这个孩子,不管里面有没有字,有标签没内容时存在性更宽。筛选里再写路径,相对的是当前候选书,不是文档根,写成从根另起一条多数是误写。空了先把筛子全摘掉看队伍有多大:为零查方向和护照,不为零一把把挂回去。四刀不要同时砍,否则不知道哪一刀起作用。
原文集对价格做过字符串比较和显式转数字两套。字符串比较碰巧能把三十九点九五判成大于三十五,换一组价格或带上货币符号就会翻车。所以贵书筛选的及格写法是转数字,不是赌隐式。位置一、队长、位置小于等于二,这三条在四本夹具上分别对应烹饪、最后一本网络进阶、前两本。第三本入门带两位作者,用来证明作者一号是每一本的第一位作者,不是文档里第一位作者。要文档第一位作者,得先形成全集再取一号,括号会改变筛选绑在哪一步。布尔与和或组合时,烹饪且价格小于三十五,应只留下第一本。存在性作者在三本都有作者时计数为三,要看出它不看内容,得造一本没有作者的书。
把顺序相反的两条筛选都跑一遍记下书名,再写去掉最后一本的正确筛选,确认留下前面几本。给多作者那本的第二位做包含,确认书能留下。这三项覆盖顺序、位置语义、嵌套筛选限制偏心。超文本类别土法前后补空格,能改短选择器就改。价格用转换。空了先摘筛选看大小。存在性不看内容。筛选里再写路径相对当前候选。数字进方括号比位置。队长减一是倒数第二本不是去掉队尾。逻辑组合加括号。四刀不要同时砍。原文对价格做过字符串比较和显式转数字两套,字符串碰巧能过,换一组就会翻车。
动手验收再钉一条容易写反的位置筛:去掉队尾应写成位置不等于队长,写成队长减一会留下倒数第二本,四本夹具上两行书名一眼能对出来。再把「先留网络类再取第一」和「先取第一再问是不是网络类」的书名并排抄下来,前者应是入门那本,后者应空。两行对不上,说明方括号绑错了步,不是样本坏了。
本节速览
- 谓词砍的是当前步的集合:步走错,筛子再细也空
- 数字谓词比的是 position:
[last()]因此成立 - 多谓词按书写顺序连滤:web 再取第一,和先取第一再看 web,结果不同
- 价格用 number:不要赌字符串比较碰巧对
- 括号改变绑定:
(//book)[1]才是全集第一本 - 空结果先摘掉谓词:看未过滤集合,再加回条件
下一章把函数当扳手塞进这些方括号:count、contains、substring、not。路径会选,函数才会修。