第2章 函数当工具用
第 2 章 · 函数当工具用
章节摘要:函数不是先背的清单,而是塞进谓词和路径里的扳手。本章按你真正会写的顺序:先数节点、再切字符串、再转数字、再做布尔,最后才是 2.0 的日期与序列。每类函数都对着书店样本给出能跑的表达式,并标明 1.0 引擎做不到的部分。
读前必看
阅读完本章,你应当能够:
- 用 count、position、last、name、local-name 探查节点集
- 用 contains、starts-with、substring、normalize-space 过滤书名和空白
- 用 number、sum、floor、round 处理价格,避开字符串求和
- 用 not、boolean、lang 写否定与语言条件
- 判断日期函数和序列函数是否被当前引擎支持
核心概念速览
金句:函数修的是已经走到的节点;没选中,函数只是在空地上打转。
图:五类扳手挂在同一块板上
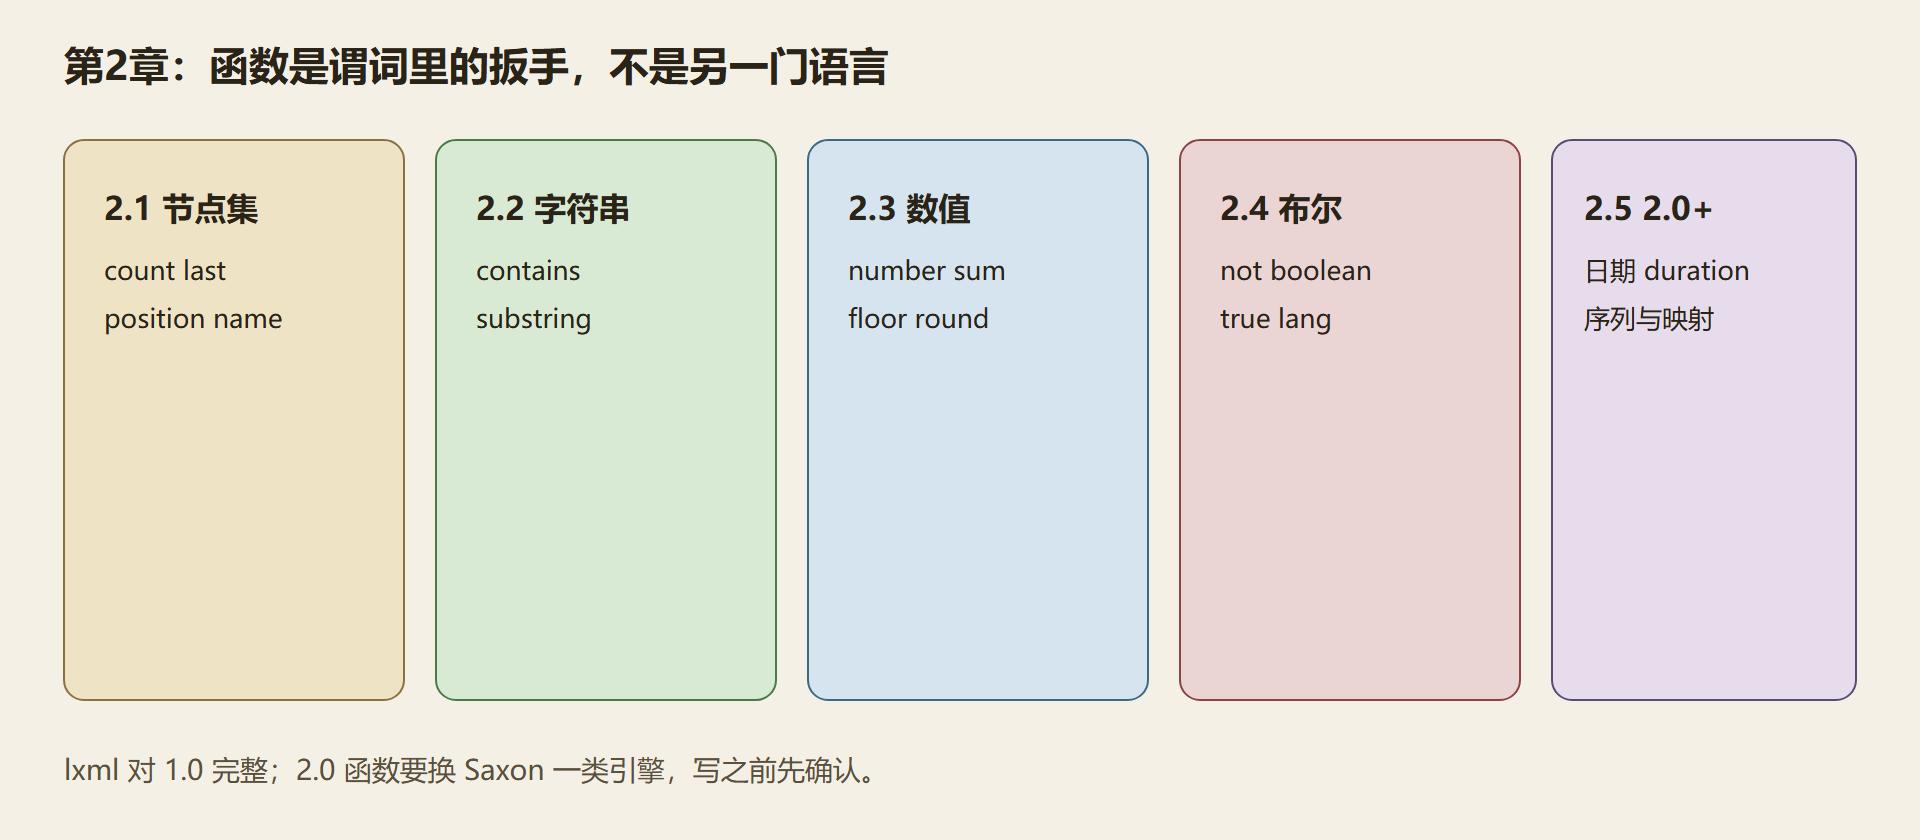
子章节导航
2.1 节点集函数:count 与 position
数有多少本、取最后一个、读节点名。这些函数几乎全部能在 1.0 里用,是谓词里最稳的一批。
2.2 字符串函数:contains 与 substring
书名是否含 XML、截前几个字符、压空白。string() 只拍扁第一个节点,这点会反复咬人。
2.3 数值函数:number 与 sum
价格求和必须先转数字。sum(bookstore/book/price) 在 1.0 里对节点集求和,lxml 能做;别把字符串拼起来当加法。
2.4 布尔函数:not 与 lang
没有 !。否定用 not()。lang() 看 xml:lang 继承,和普通属性相等不是一回事。
2.5 日期时间与序列函数
xs:date、duration、current-date 属于 2.0。1.0 引擎会直接报未知函数。把「其他函数」里的序列操作一并放在这里,避免单独开一节空转。
子章节之间的逻辑关系
先探查集合大小和位置,再处理人类可读的字符串,然后才是数字和布尔。日期放最后,因为很多读者的引擎根本没有它们。
2.1 探查节点集 ──► 2.2 切字符串 ──► 2.3 转数字 │ └► 2.4 布尔开关 └► 2.5 仅 2.0 引擎
本章怎么当扳手手册用
函数表很容易写成「签名、参数、返回值」的词典。本教程不这么排。每一节先给一条已经能跑的谓词,再解释函数在这条谓词里干了什么。你若只收藏函数名而不写进方括号,考试能填空,抓取时仍会把 contains 套在整集 title 上,只看见第一本书。
节点集函数几乎全是 1.0,可以放心写进 lxml。字符串函数同样。数值函数要注意 sum 的参数形态,以及 number 失败变成 NaN 后比较全假。布尔没有感叹号。日期与序列明确标成 2.0,抄进 1.0 引擎会报未知函数——这不是你记错名字,是引擎版本不够。
| 节 | 先跑哪一条 | 最容易踩的坑 |
|---|---|---|
| 2.1 | count 与 last | 位置编号相对当前队伍,不是全局 |
| 2.2 | contains 书名 XML | string 与 contains 都偏心第一项 |
| 2.3 | number 比较价格 | 货币符号导致 NaN,书从结果里蒸发 |
| 2.4 | not 掉 cooking 类 | 否定相等和否定存在不是同一筛 |
| 2.5 | 用数字年比较 | 不要在 lxml 里写 current-date |
原文集把节点集、字符串、数值、布尔拆成四节,日期和其他 2.0 函数另开。我们保留这个拆法,只把「其他函数」并进 2.5,避免单独一节空转序列 API。读的时候不必按天打卡:你正在过滤书名就读 2.2,正在加总价格就读 2.3。把 2.1 的 count 当作万用表,几乎每条新路径都值得先 count 一下,确认集合大小再加函数。
常见卡点
函数节最容易变成收藏夹。收藏夹不能选中节点。把 2.1 的 count 当成万用表:每条新路径先数,数字不对再谈 contains 和 number。string 与 contains 的偏心第一项会反复咬人,2.2 用图把它画成三本书只留下队长,这张图值得在写过滤时回想。价格比较漏 number,脏文本变成 NaN,书从列表蒸发,2.3 把这扇门画成海关。布尔没有感叹号,2.4 把否定相等和否定存在拆成两道筛。2.5 整节可以标成「引擎不够就当参考」,不要为了 current-date 去升级整个栈。
原文集按函数类别分节是合理的,因为扳手本来就不一样。不合理的是先背签名再找场景。本教程倒过来:场景是书店树上已经能写的谓词,函数是往方括号里塞的零件。读完应当能不查表写出 count、contains、number、not 四条,并说明各自最常见的空或错结果从哪来。日期和序列函数能认出「这是 2.0」就算达标,默写不是目标。
lxml 对 1.0 完整、对 2.0 只覆盖一部分。看到教程或同事代码里的 matches、abs、exists,先问引擎再抄。未知函数错误看起来像路径写错,其实是版本。本章表格把 1.0 和 2.0 分开,就是为了减少这类误判。把函数当工具,工具要匹配手上的那把钳子。
读函数表之前先保证第 1 章三条路径能命中。函数修的是已经走到的节点。把计数当万用表,把包含放进每一本的筛选,把价格显式转成数,把否定写成函数而不是感叹号,把日历和序列标成高版本参考。原文按类别分节合理,本教程倒过来用场景带扳手。轻量库对低版本完整、对高版本只覆盖一部分,看见陌生函数名先问引擎。读完应当能不查表写出四条最常用的,并说明各自最常见的错从哪来。日期能认出属于高版本就算达标。
前置知识与后续延伸
- 前置:第 1 章能写出路径和谓词,知道属性要用 at 选取。
- 后续:第 3 章命名空间会影响 name 与 local-name 的差别;第 5 章会回到 3.0 的箭头运算符,那只是把本章这些函数从里往外嵌改成从左往右读,并不引入全新的查询思想。