第 4 章 关键算法与数据结构
第 4 章 · 关键算法与数据结构
章节摘要:这一章介绍 LevelDB 的四件核心武器:跳表(MemTable 的骨架)、布隆过滤器(读路径的守门员)、双层缓存(Table Cache 与 Block Cache)、数据压缩(Snappy 与前缀压缩)。它们不是孤立的知识点,而是上一章"三放大"框架下的具体对抗手段——每个算法都在用某种可控代价换某类性能。读完你就能理解这些"零件"为什么长成这样。
本节导航
阅读完本章,你应当能够:
- 解释跳表为什么是 MemTable 的默认结构(概率平衡 + 无锁读)
- 推导布隆过滤器的误判率公式,并说明它对读路径的价值
- 区分 Table Cache 与 Block Cache 的缓存对象与职责
- 说清 Snappy 与前缀压缩的差异及各自适用场景
- 用"代价换性能"的视角评价每个算法的取舍
核心概念速览
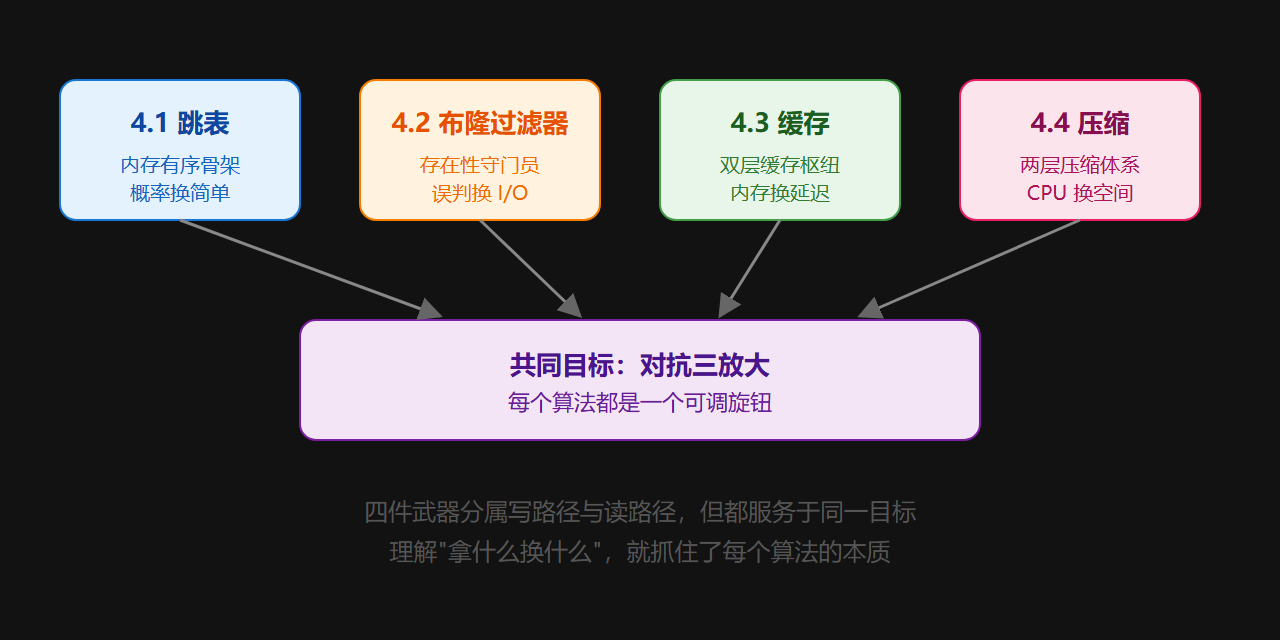
本章金句:LevelDB 选算法不选"最快的",选"在它要解决的问题里代价最可接受"的——跳表用概率换简单,布隆过滤器用误判换 I/O,缓存用内存换延迟,压缩用 CPU 换空间。
图:四件武器各守一关
子章节导航
4.1 跳表:概率平衡的有序结构
讲跳表的设计哲学(抛硬币晋升)、节点结构、无锁读取的实现,以及与红黑树、B+树的对比。这是 MemTable 高效的根基。
4.2 布隆过滤器:用误判换 I/O
讲位数组 + 哈希函数的原理、误判率公式、在 SSTable 中的集成方式,以及为什么它只对点查有效。
4.3 缓存机制:Table Cache 与 Block Cache
拆解双层缓存:Table Cache 缓存文件句柄与索引块,Block Cache 缓存解压后的数据块。讲清楚各自主角、淘汰策略、与 Compaction 的互动。
4.4 数据压缩:Snappy 与前缀压缩
讲两层压缩体系:Block 级的 Snappy(速度优先)与 Block 内的前缀压缩(零成本解压),以及参数选择的工作负载判断法。
章节速览表
| 小节 | 武器 | 核心权衡 |
|---|---|---|
| 4.1 跳表 | 有序结构 | 概率换简单、原子换无锁读 |
| 4.2 布隆过滤器 | 概率判断 | 误判率换 I/O 节省 |
| 4.3 缓存机制 | 双层缓存 | 内存换延迟、分层换精准 |
| 4.4 数据压缩 | 两层压缩 | CPU 换空间、语义换零成本 |
⚠️ 注意:这四个结构都是可独立复用的通用算法,别只当"LevelDB 零件"学。
💡 提示:读 4.2 时想想"为什么布隆过滤器绝无假阴性",这是理解它的关键。
子章节之间的逻辑关系
4.1 跳表(内存有序)──► 支撑写入路径 4.2 布隆过滤器(判存在)──► 防御读放大 4.3 缓存(内存换延迟)──► 加速读路径 4.4 压缩(CPU 换空间)──► 降低存储与 I/O └────── 共同对抗"三放大" ──────┘
四件武器分属两条战线:4.1 服务写入路径,4.2-4.4 服务读取与存储效率。它们共同对抗上一章的"三放大"——每个算法都是一个可调旋钮。
为什么叫"算法与数据结构"而不叫"优化技巧"
因为 LevelDB 里的这些组件不是"锦上添花的技巧",而是"支撑系统的承重结构"。跳表是 MemTable 的骨架,没有它写入路径就垮了;布隆过滤器是读路径的守门员,没有它"键不存在"查询会拖垮读性能;缓存是内存与磁盘之间的桥梁;压缩是存储效率的保证。每一个都是"缺了它系统就没法优雅工作"的零件,而非可选的加速器。
这一章的另一个价值是"通用性":跳表、布隆过滤器、LRU 缓存、前缀压缩,都是计算机科学里可以独立复用的经典结构。你从这一章学到的,不只适用于 LevelDB,而是适用于任何"需要有序存储、快速判存在、高效缓存、空间压缩"的系统。
本章使用建议
这一章的四个主题相对独立,可以按需读,不必一次读完。如果时间紧张,优先读 4.2(布隆过滤器)和 4.3(缓存)——它们与读性能的关系最直接,面试也最高频。读 4.1(跳表)时建议对照第 2 章的 MemTable;读 4.4(压缩)时对照第 2 章的 SSTable 文件结构,你会发现"算法"与"组件"是同一枚硬币的两面。
本章在全书的位置
第 4 章是把第 2、3 章的"架构与流程"进一步"拆到算法的粒度"。前几章回答"系统由什么组成、如何流转",本章回答"每个环节用什么结构、为什么用这个结构"。第 5 章的并发模型会用跳表的无锁读,第 6 章的调优会调本节四个旋钮,第 8 章源码阅读会在这几个结构里看到具体的实现。掌握本章,你的 LevelDB 认知就进入了"能解释为什么"的层次。
本章自测
读完本章后,试着回答以下问题:
- 跳表为什么能在"单写多读"下实现无锁读取?关键前提是什么?
- 布隆过滤器为什么"绝无假阴性"?假阳性会带来什么代价?
- Table Cache 和 Block Cache 的缓存对象分别是什么?为什么分开?
- 前缀压缩为什么能"零成本解压"?它依赖什么数据结构特征?
- Snappy 为什么不做熵编码?它用压缩率换来了什么?
- 缓存解压后的数据块 vs 缓存压缩块,各有什么代价?
如果第 1 或第 6 题没把握,建议重读 4.1 和 4.3 节。这四个"武器"(跳表、布隆过滤器、缓存、压缩)都是独立可复用的通用结构,把它们的原理与权衡吃透,你的收获将远超"会配 LevelDB"本身。
本章的四句话总结
跳表:用概率换简单,用原子换无锁读。 布隆过滤器:用可接受的误判,换掉大部分无效 I/O。 缓存:用内存换延迟,用分层换精准。 压缩:用 CPU 换空间,用语义换零成本。 四句话各自点破一个权衡的核心,合起来就是本章的"算法观":LevelDB 选结构不选"最快的",选"在该问题里代价最可接受的"。带着这个视角,无论以后遇到什么新的数据结构,你都会先问"它拿什么换什么"。
前置知识与后续延伸
- 前置知识:第 2 章的 SSTable 结构(本节的布隆过滤器、缓存、压缩都作用在它身上);第 3 章的三放大框架(这些算法的存在理由)。
- 后续延伸:第 5 章的并发控制会用到跳表的无锁读与版本管理的协同;第 6 章的调优大部分是在调本节四个旋钮。