4.1 跳表:概率平衡的有序结构
4.1 跳表:概率平衡的有序结构
本节摘要:跳表(SkipList)是 MemTable 的默认实现结构,由 William Pugh 于 1989 年提出。它的核心是"概率平衡"——用抛硬币决定节点层数,把红黑树那种复杂的旋转平衡变成简单的指针操作。本节讲透跳表的原理、节点结构、无锁读取特性,以及它在 LevelDB 中"单写多读"模型下的独特价值。
核心问题
阅读完本节,你应当能够:
- 解释跳表如何用多级索引把查找从 O(n) 降到平均 O(log n)
- 描述节点的构成(键值、高度、前进指针数组)与头节点
- 说清"先搜索后链接"的插入过程
- 解释跳表为什么能支持无锁读取,这对 LevelDB 意味着什么
一、问题与直觉
假设你要在一排有序的数据里查一个值。最笨的办法是挨个找(O(n))。聪明的办法是每隔几个元素立一根"跳板",先跳着粗查,再落下细查——这就是跳表的基本直觉。
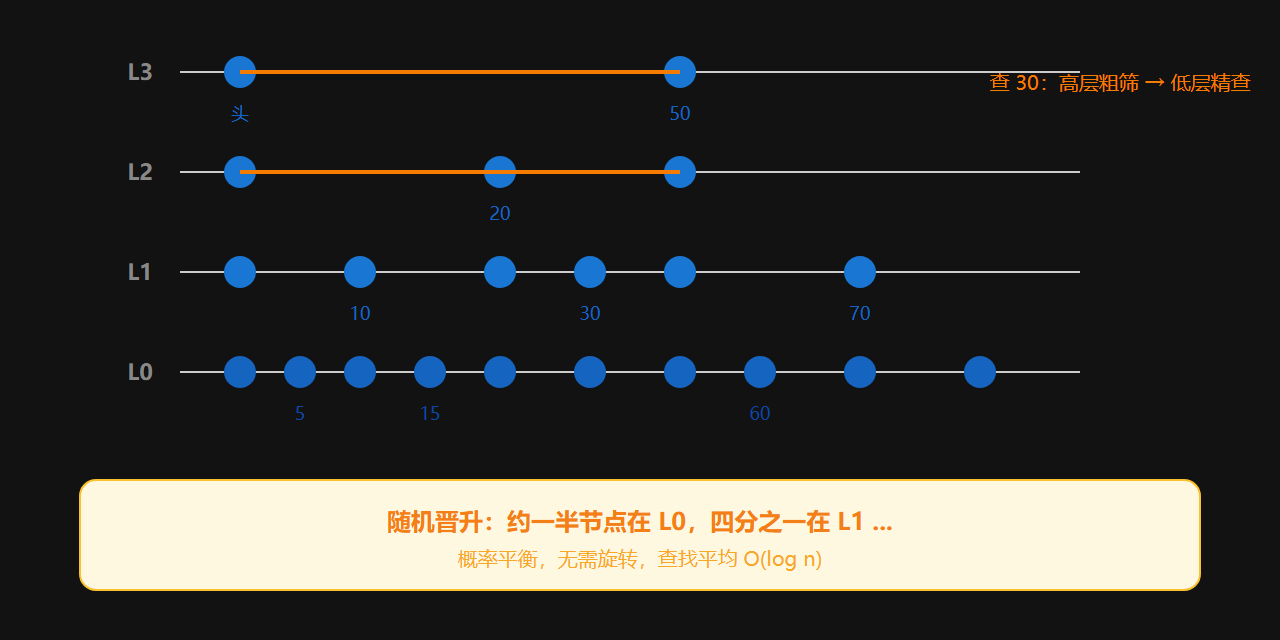
跳表把这个直觉形式化了:底层是一条完整有序链表(保证所有数据有序),之上通过随机晋升建起一层层越来越稀疏的"快速通道"。查找时从最高层出发,沿着通道大步前进,遇到超目标值的节点就降一层继续。高层粗筛、底层精查,路径长度从 O(n) 降到平均 O(log n)。
二、核心原理
概率平衡:抛硬币决定层数
插入新节点时,除了链接到底层链表,还通过随机过程决定晋升高度:50% 概率晋升一层,再 50% 继续向上。数学期望上,约一半节点在第 1 层、四分之一在第 2 层、八分之一在第 3 层……形成天然的金字塔。
这个随机化带来三个优势:
- 插入/删除逻辑简单:只需定位各层更新位置、改前后指针,无需旋转
- 平均性能好:O(log n),与平衡树相当
- 内存友好:高度动态可控,不需要为最坏情况预留存储
节点结构与搜索
每个节点包含:键值对、高度、前进指针数组(forward[i] 指向第 i 层的下一个节点)。头节点高度固定(LevelDB 中最大层数硬编码为 12),是搜索起点。
插入过程是"先搜索,后链接":从最高层出发,记录每层最后一个小于待插键的节点到"更新数组",然后随机生成高度,从第 0 层到该高度把新节点的指针链入。整个过程局部、链式,无需全局调整。
无锁读取:并发场景的利器
LevelDB 的 MemTable 面临"单写多读":一个写线程(由写入队列序列化),多个并发读线程。跳表在这里给出了优雅的答案——无锁读取。
由于插入/删除只涉及有限几个节点指针的原子性更新(现代 CPU 上指针读写通常原子),写操作对并发读者的影响是局部可控的。读者无需任何锁,沿指针前进即可;即使读到被并发修改的指针,也只会看到旧状态或新状态,绝不会看到损坏的结构。底层链表始终有序,读者最终都能正确找到目标或确定不存在。
💡 关键直觉:把跳表想成"多层电梯系统"。底层电梯每层都停(完整链表),高层电梯只停大站(快速通道)。坐电梯(查找)先乘高层快车跳过大半路程,再换低层细停。而"电梯运行图"是随机画的——但统计上总有一半节点只出现在低层,让高层永远稀疏而高效。
为什么是跳表不是红黑树
| 维度 | 跳表 | 红黑树 |
|---|---|---|
| 实现复杂度 | 低,代码量少 | 高,旋转操作多 |
| 并发读取 | 天然无锁 | 复杂旋转难无锁化 |
| 范围迭代 | 底层链表天然有序 | 需树形遍历 |
| 常数因子 | 链表遍历缓存友好 | 节点跳转较差 |
三、工程实践要点
使用约束与陷阱
跳表也不是万能的。它的空间复杂度略高于严格平衡树(多存指针),性能基于概率保证而非绝对保证。但在 LevelDB 的设计哲学里,这些权衡被证明是值得的——工程简洁、并发无锁、实际硬件上表现优秀。
| 场景 | 跳表表现 | 说明 |
|---|---|---|
| 点查 | O(log n) | 与平衡树相当 |
| 范围扫描 | 优 | 链表顺序遍历 |
| 高并发读 | 极优 | 无锁,无上下文切换 |
| 随机性最坏情况 | O(n) | 概率极低,可忽略 |
⚠️ 常见坑:担心跳表的随机性导致性能不稳。实际上,所有节点都晋升到同一低层的概率随节点数指数级衰减,工程上可以完全忽略。LevelDB 把最大层数硬编码为 12,足以应对数十亿级数据。
SOURCE 独有事实
跳表由 William Pugh 在 1989 年提出,最初更多出现在教科书和算法竞赛里,LevelDB 把它"请"出来放进了 MemTable 这个关键位置——这标志着一个研究算法向工程核心的转身。在 RocksDB 中,除了跳表还实验性地支持了哈希链表等 MemTable 实现,但跳表始终是默认且经典的选择。另外,跳表节点层数的几何分布有明确数学表达:节点层数至少为 k 的概率是 p^(k-1)(p=1/2),这保证了高层节点的稀缺性。
四、深入展开:跳表为什么是"工程优选"而非"理论最优"
图:跳表的多层快速通道
概率平衡 vs 严格平衡:一场务实的交易
红黑树和 AVL 树能保证严格 O(log n) 的插入删除,理论上比跳表更"确定"。但它们为此付出的代价是复杂的旋转操作和平衡维护逻辑——一旦写错,就是隐蔽的数据损坏。跳表用"抛硬币"决定层数,把平衡责任交给概率,实现代码量只有平衡树的几分之一。
工程上这个交易很划算:LevelDB 的首要目标是"多年稳定运行不出错",代码可维护性比理论最优重要得多。跳表的"大概率均衡"在实际数据量下与严格均衡的差距微乎其微,但实现的简单性带来了巨大的可靠性收益。这就是"工程优选"的含义——不是每个维度都最优,而是在"性能、可靠性、可维护性"的综合分数上最优。
无锁读取的正确性论证
跳表无锁读取能成立,依赖一个关键前提:指针更新是原子的。在现代 CPU 上,对对齐的指针进行读写是原子操作,读者要么读到旧指针、要么读到新指针,绝不会读到"写了一半"的指针。这个原子性保证读者看到的数据结构永远是"某个合法的中间状态",而底层链表始终有序,所以搜索最终总是正确的。
这个论证揭示了一个通用模式:用"原子性原语"代替"锁"来保证并发安全,前提是数据结构本身对"读到的中间状态"是宽容的(无论看到新旧都不影响最终正确性)。跳表恰好满足这个条件,而红黑树不满足——旋转会同时改多个指针,读者可能看到不一致的树结构。这就是为什么跳表在"单写多读"场景下能实现无锁读,而平衡树很难。
内存开销的一笔账
跳表的空间开销比平衡树略高,因为每个节点按概率存了多个前进指针。设晋升概率 p=1/2,平均每个节点有约 2 个指针(1 + p + p² + ... = 1/(1-p) = 2)。对 LevelDB 的 MemTable 来说,这意味着"每个键值对多付约一个指针的空间"。相比键值本身,这个开销很小,但它说明了一个道理:没有免费的午餐,跳表的简单是拿少量空间换的。
在内存敏感的嵌入式场景,这个开销值得考虑;但对绝大多数服务端应用,MemTable 的几 MB 到几十 MB 空间里,指针开销占比微不足道。理解这笔账,你就不会在面试或选型时对跳表的空间复杂度含糊其辞——它不是"空间最优",但它是"代价可接受的最简实现"。
常见问题
问:跳表的最坏情况真的会发生吗? 理论上可能(所有节点层数都是 1,退化成链表),但概率随节点数指数级衰减。对 10 亿个节点,全部退化到 O(n) 的概率小到可以忽略。工程上完全不需要为它设计兜底逻辑。
问:为什么最大层数设 12? 因为 2 的 12 次方是 4096,而期望层数约为 log2(n),12 层足以容纳十亿级别的数据量,同时把每个节点的指针开销控制在 12 个以内。这是一个"够用且不浪费"的经验值。
问:跳表能替代所有平衡树吗? 不能。跳表更适合"内存中、读写混合、需要范围迭代"的场景;对磁盘页式存储(需要局部性),B 树/B+树更合适。选型要看存储介质的特性,而不是结构本身的优劣。
一个直观的类比:跳表是"有电梯的图书馆"
把跳表想成一座图书馆。底层(L0)是每层书架都通的走道,你可以在里面逐本找书(O(n) 线性)。但图书馆还建了直达电梯(高层索引),电梯只停大站(稀疏节点)。查书时先坐电梯直达可能区域,再走楼梯精确定位。电梯停得越少、越稀疏,找书的平均时间越短——这就是 O(log n) 的来源。
而这个电梯系统是"随机建的"——每本书被选中作为电梯停靠点的概率是抛硬币决定的。听起来不严谨,但统计上总能形成"高层的电梯停靠点指数级稀少"的结构。这种"用随机性代替人为设计"的思路,让整个结构不需要维护(像平衡树的旋转),因为电梯密度天然自动平衡。理解了这幅图,你就抓住了跳表全部的精髓:随机带来的自动平衡 + 分层带来的对数查找。
跳表思想给我们的启发
跳表最有价值的启发不是数据结构本身,而是一种工程思维:当"确定性平衡"代价过高时,可以退而求其次使用"概率平衡"——只要最坏情况发生的概率可忽略,就能用更低的实现复杂度换取几乎相同的平均性能。这个思维在算法设计里反复出现(比如随机化快速排序、哈希表),是"工程不是数学"的典型体现。
对于 LevelDB 而言,选择跳表还传递了一个信号:设计者把"代码正确性"看得比"理论最优"更重。一个几乎不可能触发的最坏情况,远不如一个每天都在执行的简单路径重要。这种价值观,贯穿了 LevelDB 的每一个组件选择——也是它成为教材的根本原因。
要点速记
- 要点一:跳表用概率平衡替代严格平衡,把实现复杂度降到链表级别。
- 要点二:查找从最高层开始,高层粗筛、底层精查,平均 O(log n)。
- 要点三:节点由键值、高度、前进指针数组构成,头节点高度固定为 12。
- 要点四:插入是"先搜索后链接",局部改指针,无需全局调整。
- 要点五:无锁读取靠指针原子更新保证安全,是"单写多读"模型的理想结构。
- 要点六:相比红黑树,跳表胜在实现简单、并发友好、缓存友好。
内存里的有序结构搞定了。下一节看读路径的守门员——布隆过滤器如何用极小代价挡住海量无效查询。