1.1 定义与核心价值
1.1 定义与核心价值
本节摘要:Ollama 是一个本地大模型运行工具,它把"下载、加载、运行、交互"一个开源大模型的全过程压缩成命令。本节讲清它的四重身份——模型容器化抽象层、运行时智能调度器、交互协议统一层、生态信任锚点——并用它与 vLLM、LM Studio、LocalAI 的对比,帮你判断它适合解决哪类问题、不适合解决哪类问题。
学习目标
阅读完本节,你应当能够:
- 用
ollama run跑起第一个本地模型,并理解背后发生了什么 - 解释 Modelfile 如何让模型获得"可移植二进制"的语义
- 说出 Ollama 的守护进程会根据什么条件自动切换 GPU/CPU 后端
- 从设计原点区分 Ollama 与 vLLM、LM Studio、LocalAI
- 用
ollama show查看模型的关键元数据(量化、上下文长度、显存占用)
一、问题与直觉:为什么本地跑模型这么难
先做一个思想实验。你去 Hugging Face 下载一个 Llama-3-8B 的权重文件,然后想在自己电脑上跑起来。你需要:装对 CUDA 版本、编译量化工具、选推理引擎(llama.cpp 还是 transformers)、处理显存溢出、还要会拼对话模板。这一套下来,熟练工也要折腾半小时到一小时,新人可能一整天都卡在环境上。
Ollama 解决的就是这个"抽象层级断裂"。它把模型封装成自包含、可版本化的包,一行命令下载,一行命令运行。你可以试试,装好之后:
ollama run llama3.2
看到 >>> 提示符,就能开始对话了。这行命令背后,Ollama 自动完成了模型下载、格式解析、硬件探测、后端选择——这些正是过去需要手工完成的部分。
💡 关键直觉:Ollama 的"智能"不在跑得多快,而在于把原本属于应用开发者的系统工程负担(选后端、配显存、拼模板)下沉为基础设施的默认行为。
二、核心原理:四重身份解构
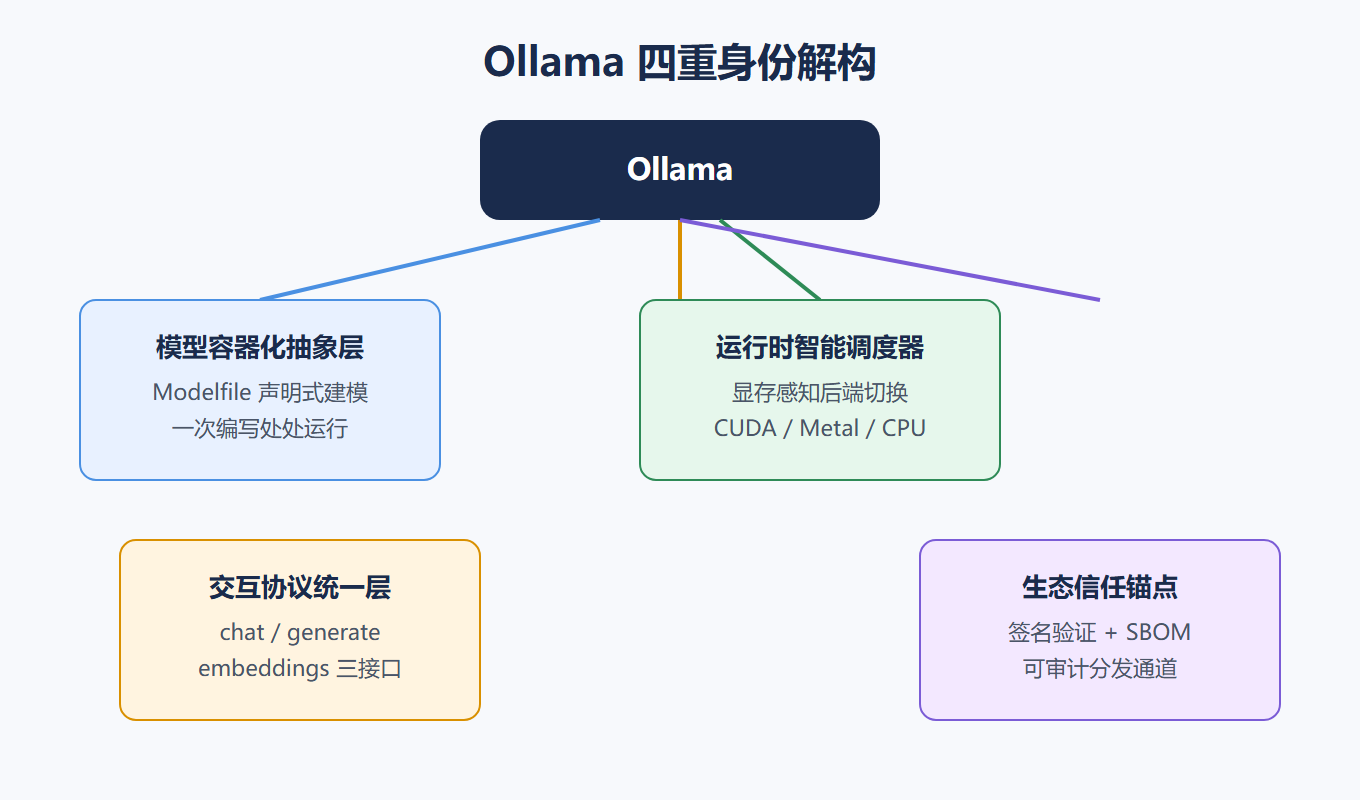
Ollama 官方描述是"a tool for running LLMs locally",但这句话太轻了。剥开命令行工具的表皮,它由四个咬合的维度共同定义。
第一重:模型的容器化抽象层。 一个典型的 Modelfile 长这样:
FROM llama3:8b-instruct-q4_K_M PARAMETER num_ctx 8192 PARAMETER stop "<|eot_id|>" ADAPTER ./lora-finetune.bin SYSTEM "You are a concise, technical assistant."
注意它没有让你指定 GGUF 文件路径、加载 llama.cpp 还是 transformers、手动设置 GPU 层数。这些细节被 FROM 指令的语义吸收了——Ollama 内部维护一张模型元数据映射表,每个标签不仅指向 GGUF 文件的 SHA256 哈希,还隐含该量化版本适配的推理后端、默认线程数、推荐显存阈值。同一个 ollama run llama3:8b,在 M2 Mac、RTX 4090、Jetson Orin 上触发的是完全不同的底层加载策略,但对外暴露的行为契约一致。这就是模型层面的"一次编写,处处运行"。
第二重:运行时的智能调度器。 ollama serve 守护进程动态感知系统资源,基于 OLLAMA_NUM_GPU、OLLAMA_MAX_VRAM 等环境变量实时决策:显存充足(大于 12GB)就走 llama.cpp 的 CUDA 加速后端,把 KV Cache 全部驻留 GPU;显存紧张(低于 6GB)就降级到 Metal 或 CPU 的 OpenBLAS 后端;请求的模型已加载且空闲,直接复用实例,避免重复初始化。这个调度逻辑不需要用户干预。
第三重:交互的协议统一层。 Ollama 对外只暴露一套稳定的 REST API(/api/chat、/api/generate、/api/embeddings)。任何能发 HTTP 请求的客户端——Python、JavaScript、Go、甚至 Shell 脚本——都能和任意模型对话。更关键的是 API 语义与模型无关:messages 的结构、stream 开关、options 里的 temperature 与 top_p,在 phi3 和 qwen2 上有完全一致的解释规则。这解决了开源 LLM 生态"千模千面"的老问题——过去调 transformers.pipeline、llama.cpp、exllama 需要三套不同代码。
第四重:生态的信任锚点。 ollama pull 连的是官方模型库,这个库不是简单的文件托管 CDN,而是一个经过人工审核、自动化测试、签名验证的可信分发通道。每个上架模型附带一份 MODEL 文件(作者、许可证、训练数据概要、已知偏差),一组标准测试用例,以及由 cosign 签名的 SBOM(软件物料清单)。执行 ollama run mistral:7b,你得到的不只是权重,还有一份可审计、可追溯的软件制品。这跟从 Hugging Face 随便下个未经验证的 GGUF 文件,本质不同。
四个维度的关系
三、工程实践要点:它在工具光谱里的位置
把 Ollama 放进开源 LLM 工具的坐标里看,会比孤立地看更清楚。三句话总结三个邻居:
- vLLM,出身伯克利 SkyLab,设计原点是大规模服务推理的吞吐极致优化,用户是 SRE 和 MLOps 工程师,关心 requests/s 和 P99 延迟。它对单个开发者不友好——默认假设你有 Kubernetes 集群和 Prometheus 监控栈。
- LM Studio,面向非技术用户的图形化体验,模型浏览器、拖拽参数、内置聊天界面都有。代价是深度定制能力受限,模型生态依赖社区上传,缺乏 Ollama 那样的元数据治理与签名验证。
- LocalAI,设计原点是 OpenAI API 的无缝替代,完美复刻
/v1/chat/completions的每个字段,适合"已深陷 OpenAI 生态、急需本地逃生舱"的应用开发者。但它是向后兼容的"优秀",不重新定义模型的使用范式。
Ollama 走的是第三条路:以模型为中心的开发者原生体验。它做出了三个明确取舍:
| 取舍 | 放弃什么 | 换来什么 |
|---|---|---|
| 吞吐 | vLLM 那般的极致吞吐优化,选择在 llama.cpp 上做稳健增强 | 对本地场景,"能否启动"远重要于"40 vs 20 tokens/s" |
| GUI | LM Studio 那般的丰富图形控件,坚持 CLI 为一等公民 | 自动化、脚本化、CI/CD 集成唯一可靠的载体 |
| API 兼容 | 对 OpenAI API 逐字复刻,提供更简练的 /api/chat |
system 角色、tool_use、response_format 更贴合本地语义 |
定位清晰了,使用边界也就清楚了。个人开发者、小团队要"跑通一个开源模型并嵌入自己的工具链",Ollama 是门槛最低的路径;但如果你要做的是单模型高并发生产服务,vLLM 那种吞吐优化才是该考虑的;如果你的用户是完全没有命令行基础的人,LM Studio 的图形界面更合适。工具没有高低,只有匹配不匹配。
⚠️ 常见坑:拿
ollama show llama3:8b的输出当摆设。它不只是模型大小,而是运行时知识图谱——GPU layers: 35/48 (offloaded to GPU)直接告诉你当前量化下有几层被卸载到 GPU,VRAM usage: ~5.2 GB帮你判断显存够不够。跑之前先看它,比跑完报错再猜省时间。
结合动手体验的补充:ollama show 到底能看什么
ollama show llama3:8b 的输出往往被人扫一眼就跳过,但它是理解"模型即文件"最直观的窗口。你会看到:参数规模(8.0B)、量化类型(Q4_K_M,约 4.5 比特每权重)、上下文长度(8192 token)、GPU 层数(35/48,即 48 层里 35 层被卸载到 GPU)、显存占用(约 5.2GB)。这些信息不是随手的展示——它们是 Ollama 加载模型时通过解析 GGUF 头部、运行微型基准测试、查询显卡设备属性后主动推送的"运行时知识图谱"。它不教你怎么调参,但让你在调参之前就知道参数的物理意义与约束边界。
举个真实判断的例子:你想在 8GB 显存的显卡上跑 13B 模型。ollama show 告诉你当前量化档位下显存需求,你就知道要不要换 Q4_K_M 而不是 Q8_0——前者把每权重位宽压到 4.5 比特,后者要 8 比特,显存需求差近一倍。这个判断不需要你懂量化数学,只需要你会读它给出的数字。这也是"知识的具身化"——知识不再悬浮于文档,而是内嵌于每次 CLI 交互的反馈里。
为什么"先跑起来"是第一条原则
我们特意把动手放在原理前面,是有原因的。Ollama 的 ollama run 设计目标之一,就是让你在完全不懂底层时也能用起来——它把硬件探测、后端选择、量化匹配全部自动化了。如果你一上来就啃架构,很容易被 GGUF、CUDA、KV Cache 这些术语劝退;但如果你先跑起来,看到一个流畅回答的瞬间,你就有了继续深入的内在动力。等读完第 2 章再回头看这一章,你会发现很多"魔法"其实都有清晰的工程解释。先跑起来,再理解为什么——这是本教程的节奏,也是 Ollama 这个工具本身的哲学。
要点速记
- 一行命令跑通:
ollama run自动完成下载、解析、硬件探测与后端选择 - Modelfile 即契约:FROM/PARAMETER/ADAPTER/SYSTEM 把模型变成可版本化、可校验的包
- 守护进程智能调度:根据显存大小自动切换 CUDA/Metal/CPU 后端,无需干预
- 协议统一:
/api/chat、/api/generate、/api/embeddings三接口语义与模型无关 - 信任分发:官方模型库带测试、签名与 SBOM,区别于直接下 GGUF 文件
- 定位取舍:放弃极致吞吐与丰富 GUI,换开发者原生体验与生产就绪度
本节对应的常见 FAQ
Q:Ollama 会不会比云端 API 差很多?
看场景。生成质量取决于你选的模型,7B-8B 的开源模型在日常问答、代码补全、文本总结上已经够用,而且零延迟(无网络往返)、零成本、无隐私担忧。但在复杂推理、长文生成上,大参数云端模型仍有优势。合理姿势是:敏感数据走本地,重活交给云端。
Q:Ollama 和 llama.cpp 是什么关系?
llama.cpp 是 Ollama 的底层推理引擎之一(不是唯一)。Ollama 在它之上加了模型仓库、Modelfile、REST API、SDK 这些"操作系统层"能力。你可以把 llama.cpp 想成发动机,Ollama 想成整车。
Q:为什么叫"模型即文件"?
因为 Ollama 让模型具备了像文件一样的基本操作:可下载、可校验(哈希)、可版本化、可删除、可导出。第 3 章会详细讲这套机制的实现——它不是比喻,而是真的按文件系统的思路设计的。
从四重身份看一次完整调用
把四重身份串起来看一次 ollama run llama3:8b 的完整旅程:容器化抽象层把模型名解析为具体的 GGUF 文件与量化配置(第一重);守护进程查询显存与后端,决定加载策略并启动推理(第二重);你输入的每一轮对话都通过统一接口发出(第三重);模型本身来自签名验证过的可信分发通道(第四重)。这四步环环相扣,任何一环缺失,体验都会崩坏。这也是为什么单独说"Ollama 就是个模型运行器"会失真——它同时是文件系统、调度器、协议栈和信任链。
局限也要说清楚
第一节末尾泼一点冷水,免得期望值跑偏。Ollama 有四个已知边界:一是对超大模型(70B 以上)支持有限,单机场景基本吃不动;二是模型管理是它擅长的,但训练、微调数据流水线不是它的活;三是默认无认证的 API 在暴露到公网前必须自己加固(第 7 章详述);四是它的调度策略是"够用优先"而非"极致优先"——想要 vLLM 那般的极限吞吐,得换工具。清楚边界,才能把它放在正确的位置上用。
一句话总结本节
如果你只记住一句话:Ollama 是模型时代缺失的那层"语义化运行时"——它把"部署一个模型"从半小时的手工劳作压缩成一条命令,同时用 Modelfile、统一接口和签名分发,给了模型文件级的可移植性、服务级的可编程性和供应链级的可验证性。后面每一章,都是这句话的具体展开。
下一节我们看这个东西从 2023 年诞生到现在经历了哪几个阶段——理解了它的演化路径,很多"为什么这么设计"的疑问会自然解开。