1.2 发展历程与社区生态
1.2 发展历程与社区生态
本节摘要:Ollama 在 2023 年夏天诞生时只解决一个痛点——把 llama.cpp 包进"一条命令就能跑"的体验。两年多时间里,它靠 Modelfile、模型仓库、REST API 三件套聚起一个从个人玩家到企业团队的生态。本节按时间线梳理关键节点,盘点模型库与周边工具的生态位,并观察治理方式对项目走向的影响。
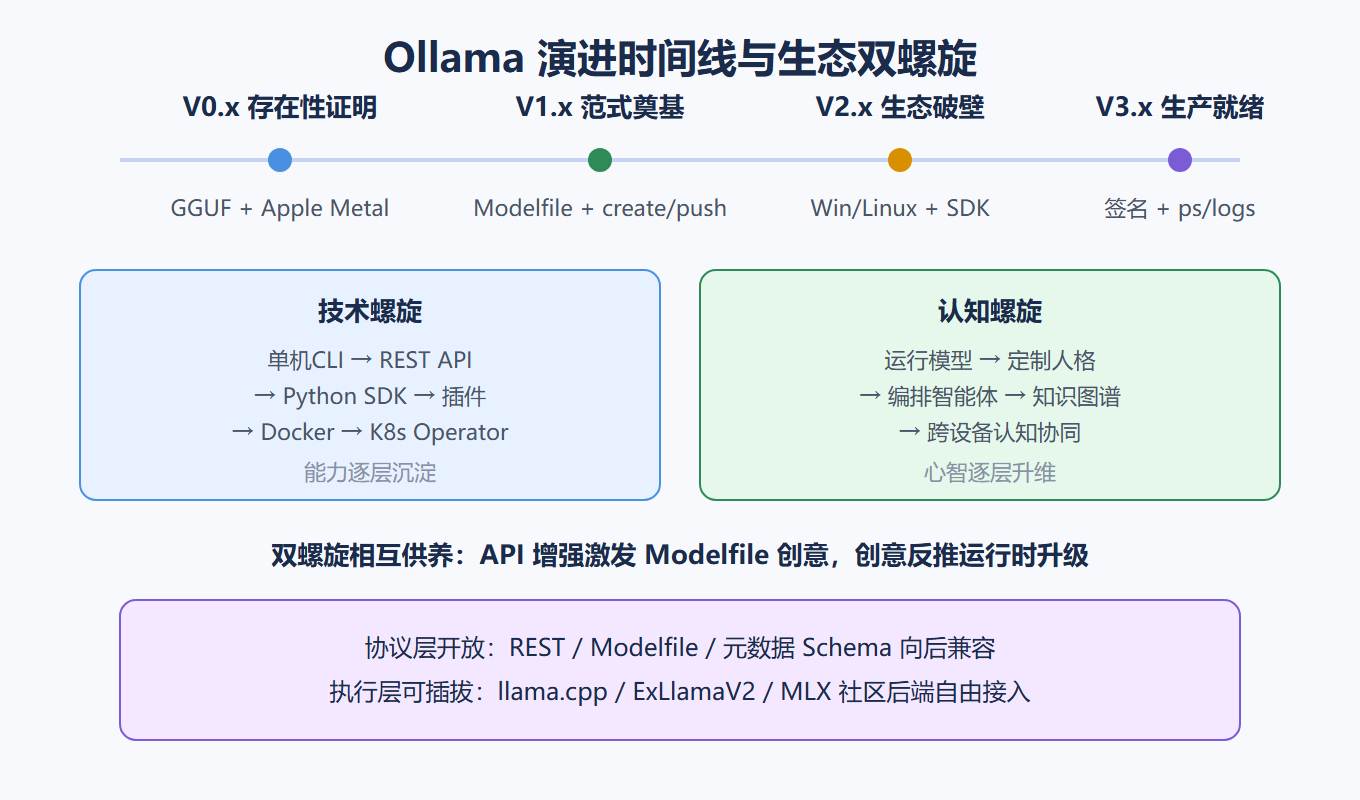
时间线:四个阶段
起点(2023 年中)。彼时跑 Llama 系模型的主流路径是下载权重、编译 llama.cpp、手敲命令行参数,量化与分层对新手近乎天书。Ollama 的初始版本把这条链路折叠成 ollama run llama2,下载、量化选择、GPU 探测全部自动。这种"把复杂度吞进工具"的取向从第一天延续至今。
模型即镜像(2023 下半年)。registry 与 pull/push 机制的引入让模型可以像容器镜像一样分发,FROM 语法与 Modelfile 随后定型(3.2 节的主角)。同年 GGUF 格式统一了量化模型的载体,Ollama 与 llama.cpp 社区形成共生:上游出格式与算子,Ollama 出体验与分发。
服务化(2024 年)。REST API、OpenAI 兼容端点、并发请求、keep_alive 驻留等能力相继落地,Ollama 从终端玩具变成可以被应用嵌入的服务。也是在这一年,qwen、gemma、phi、mistral、llava 等家族进入官方库,多模态与中文模型的可用性大幅改善。
生产化(2024 下半年至今)。结构化输出、工具调用、Flash Attention 默认化、容器化部署文档完善——面向团队与生产的特性成为更新主线(8.2 节展开)。
模型库:官方库与社区命名空间
官方 library 按家族组织,每个家族下挂多个参数规模与量化 tag。可运行的远不止聊天模型:
ollama pull nomic-embed-text # 嵌入模型,RAG 基础设施 ollama pull llava # 视觉模型,读图问答 ollama pull qwen2.5-coder # 代码补全特化 ollama pull deepseek-coder-v2 # 代码生成 ollama search qwen # 检索可用变体
社区命名空间(用户名/模型名)承担长尾:微调变体、领域模型、实验性量化。选社区模型看三样:最近更新时间、下载量、是否附 Modelfile 说明基座来源。
周边生态的四个圈层
第一圈是前端界面:Open WebUI 已成事实标准,IDE 侧 Continue 与 Cline 把本地模型接进编码流(8.1 节细讲)。第二圈是框架适配:LangChain、LlamaIndex 提供官方 Ollama 集成,Spring AI、Semantic Kernel 等企业栈也有对接,本地模型由此进入既有应用开发体系。第三圈是运维工具:Docker 镜像、K8s Operator、各类监控面板,覆盖部署侧。第四圈是同类项目——LM Studio 走图形客户端路线、llama.cpp server 走极简原生路线、vLLM 走高吞吐批处理路线,Ollama 卡位在"易用与功能的平衡点",这也是理解它取舍的坐标:为易用牺牲部分极致吞吐,为稳定牺牲新特性上船速度。
治理与社区参与
Ollama 由独立团队维护,接受赞助而非风险投资驱动,迭代节奏务实——新模型支持与 bug 修复优先于激进重构。参与方式三种:GitHub issue 报问题(附上 ollama --version、日志与复现步骤的 issue 处理快得多)、贡献模型适配、在 Discord 讨论区互助。值得注意的张力点:核心引擎高度依赖 llama.cpp,上游重大变更的消化速度决定 Ollama 新量化与新特性的滞后时长;社区对"生产特性(认证、多租户)要不要进主线"的讨论持续存在,目前的答案仍是从简,把安全与配额留给部署层(第 7 章的做法)。
版本选型与跟进节奏:给使用者的实用建议
生产或长期项目不要追最新版,而是钉住一个稳定版本号,只在两类更新出现时升级:修复了你遇到的问题(先在 changelog 里对上症状),或带来了你等待的能力(如新版模型的适配)。升级前把模型目录备份一份——绝大多数升级是无损的,但 blobs 结构偶有调整,回滚成本远低于排查。团队内部建议指定一个"版本负责人",统一升级窗口与验证清单:探活、跑一次基准探测(5.2 的脚本)、确认模型列表完整。这套小流程把"升级"从风险事件变成例行操作。
另一条建议是同时跟踪 llama.cpp 的动态。Ollama 的大量能力(量化方案、注意力优化、新架构支持)都来自上游,看懂 llama.cpp 的发布说明,常常能提前半拍判断 Ollama 下一个版本会带来什么,也能在遇到诡异性能问题时多一条排查线索。信息源控制在三个以内即可:Ollama 的 release 页、llama.cpp 的 release 页、以及一个聚合社区讨论的渠道,多了反而看不过来。还有一个侧面观察:Ollama 的模型命名与 tag 体系两年间保持了稳定,早期学会的 pull/list/show 命令至今未变——这种接口层面的克制,本身就是它能在企业环境被放心采用的原因之一。反过来,读旧文档也不必担心过时:两年前的教程换个模型名大多依然能跑,学习资料的保值率同样来自这份克制。
# 升级前后的三步核对清单 ollama --version # 1) 确认版本号已切换 curl -s localhost:11434/api/tags | head # 2) 模型列表完整 ollama run qwen2.5:7b --verbose "1+1" # 3) 冒烟测试并记录 t/s
生态盘点到此。下一章进入正题:这套体验底下是一副怎样的架构——从进程分工到量化机制,逐层拆开看。