第1章 Ollama概述与核心价值
第 1 章 · Ollama 概述与核心价值
章节摘要:本章先解决"Ollama 到底是什么、凭什么值得我用"这两个问题。我们会从一个真实的安装过程讲起——一条命令装好、一条命令跑起模型——然后退后一步,看看这个工具在开源 LLM 生态里站在哪个位置,以及它从 2023 年诞生至今经历了哪几个关键阶段。读完本章,你能说清 Ollama 与直接下载 GGUF 文件、与 vLLM、LM Studio 等同类工具的区别,也知道它背后社区生态是怎么运转的。
你能学到什么
阅读完本章,你应当能够:
- 用安装脚本或包管理器装好 Ollama,并用
ollama run跑起第一个模型 - 说清 Ollama 解决的核心痛点:本地模型部署的"抽象层级断裂"
- 从设计原点区分 Ollama 与 vLLM、LM Studio、LocalAI 的差异
- 讲出 Ollama 从 V0.x 到 V3.x 的演进脉络与每个阶段的标志性能力
- 理解其"协议层开放、执行层可插拔"的开源治理思路
核心概念速览
金句:Ollama 的价值不在"能跑模型",而在把"部署一个模型"从半小时的手工劳作压缩成一条命令——它做的是模型时代缺失的那层"语义化运行时"。
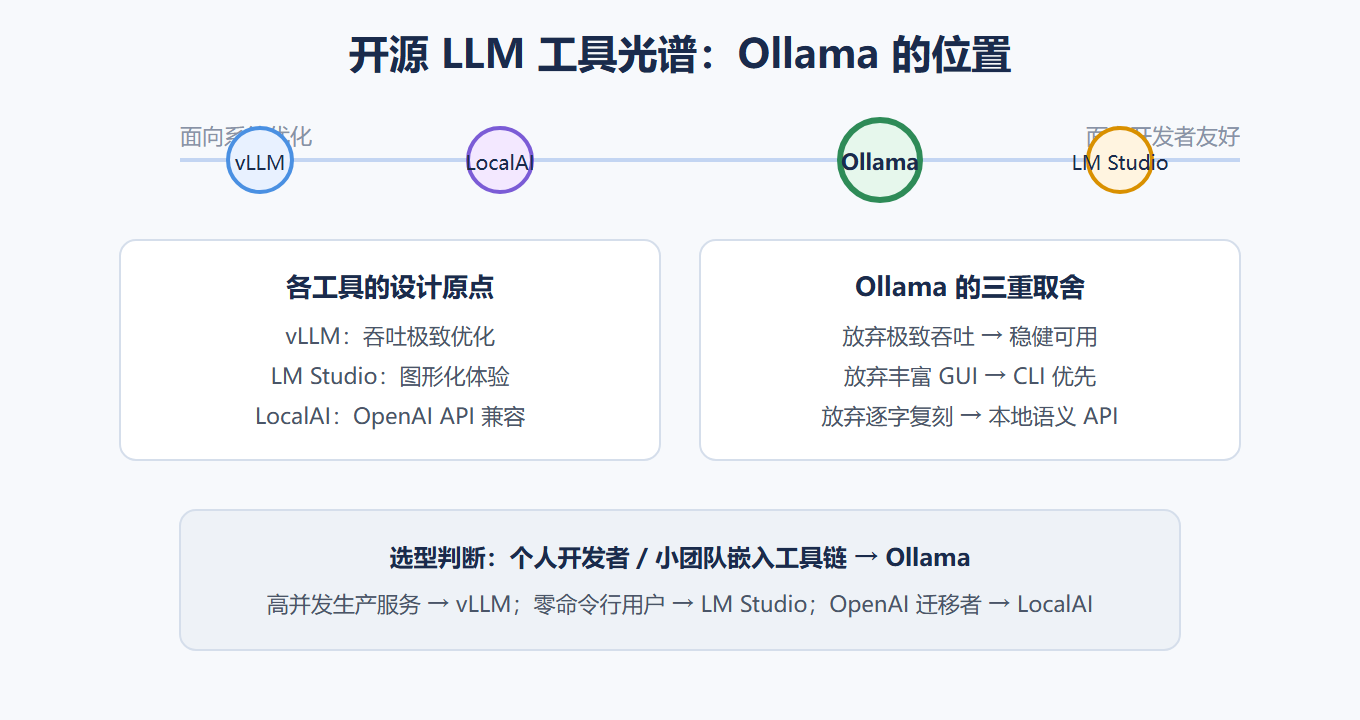
工具光谱定位矩阵
子章节导航
1.1 定义与核心价值
讲清楚 Ollama 是什么、不是什么。它把自己定位成"模型生命周期操作系统":模型像 Docker 镜像一样可移植,推理通过统一接口暴露,模型文件自带元数据与校验。本节会给出与 vLLM、LM Studio、LocalAI 的对比定位。
1.2 发展历程与社区生态
从 2023 年 8 月 GitHub 首版讲起,梳理 V0.x 到 V3.x 的演进,以及"协议层开放、执行层可插拔"的开源策略如何让社区贡献百花齐放。这一节为后续章节理解"为什么这么设计"提供历史背景。
子章节之间的逻辑关系
1.1 是什么、为什么 ──► 1.2 怎么来的、谁在贡献 │ │ ▼ ▼ 建立"模型即文件"心智 解释"为何协议先行"
先建立对工具本质的判断,再用演化史印证这个判断——后面几章讲架构、讲 API 时,都会反复回到这两个认知基点上。
一个贯穿全书的例子
为了让你后面几章有落点,先记一个贯穿例子:一家中小公司的工程师要把内部规章制度做成问答机器人,让同事用自然语言查报销流程、年假规则。用云端 API 要考虑数据出境、按量计费、网络延迟;用本地模型,数据留在公司内网,一次投入之后使用免费。这个例子在后面章节会反复出现——第 3 章教他怎么把制度文档做成专属模型,第 4 章教他怎么用 API 把模型接进内部系统,第 6 章教他怎么用 RAG 让答案有据可查,第 7 章教他如何让局域网同事安全访问。带着这个具体场景读,每章的命令都不会是抽象练习。
一个容易误判的点
很多人第一次接触 Ollama,会把它当成"又一个模型下载器",觉得和从 Hugging Face 下权重没本质区别。这个误判的代价在后续会逐渐显现:如果你只把它当下载器,就会错过 Modelfile 带来的可移植性(第 3 章)、REST API 带来的可编程性(第 4 章)、以及"模型即服务"带来的部署形态(第 7 章)。正确的打开方式是把它看成一个运行时平台:模型是它管理的资产,接口是它提供的服务,Modelfile 是它定义的契约。这个心智越早建立,后面学得越顺。
本章定位速查
| 问题 | 一句话答案 |
|---|---|
| Ollama 是什么 | 本地大模型运行工具,把部署压缩成一条命令 |
| 它解决什么 | 模型部署的抽象层级断裂 |
| 和 vLLM 什么区别 | 前者保可用性,后者追极致吞吐 |
| 怎么开始的 | 2023.8 首版,run/pull/list 三命令 |
⚠️ 常见误区:别急着拿 Ollama 和云端 API 比"模型能力"。它管的是"运行与分发",不是"模型训练"——跑什么模型、模型多聪明,取决于你选的开源权重,Ollama 负责让它们跑得起来、接得进去。
💡 关键直觉:把 Ollama 想成 Docker——Docker 不生产软件,但让软件可以随时随处跑;Ollama 不生产模型,但让模型可以随时随处跑。
本章在全书中的位置
第一章承担的任务是"定调":它不解决具体技术问题,但决定你后续所有学习的方向感。第 2 章的架构、第 4 章的 API,本质都是对第一章"模型即文件、推理即服务"这句话的展开;第 8 章讨论生态与未来,也是在第一章建立的坐标系里讨论。所以读完本章,你不必记住所有细节,但要能用自己的话回答两个问题:Ollama 是做什么的?它和同类工具差在哪?答得出这两问,本章的目标就完成了。
前置知识与后续延伸
- 前置知识:能打开终端执行命令即可,本章不要求任何深度学习背景
- 后续延伸:第 2 章将进入"它凭什么这么快"的架构层;第 4 章讲解 CLI 与 API 的完整用法,会直接用到本章的"模型即文件"心智
动手建议
读完本章后,强烈建议先做一件事:装好 Ollama,然后 ollama run llama3.2(或任何你喜欢的 3B-8B 模型)聊几句话,再用 ollama list 看看模型存在哪、用 ollama show <模型名> 看看它的量化与显存信息。这一步不需要理解原理,目的是让"命令行"这个界面先进入你的肌肉记忆。后面第 3、4 章的大量操作都建立在这些命令之上——现在先混个脸熟,后面就顺了。
常见疑问速答
- Ollama 是国产软件吗? 不是,它由一家海外创业公司开发,核心代码开源,社区遍布全球。中文模型(如 Qwen)可以正常通过它运行,这和使用什么工具无关。
- 它和 OpenAI 是什么关系? 没有直接关系。Ollama 运行的是开源模型,不依赖任何云端供应商;它提供的接口风格借鉴了 OpenAI 生态以便迁移,但推理完全在本地。
- 有图形界面吗? 官方偏命令行,但社区有大量 WebUI 可用——这正是第 8 章会讲的。
- 收费吗? 工具本身免费开源,模型也基本是开源许可,但要注意各模型的许可证条款(第 3 章讲 LICENSE 时会涉及)。
带着这些问题开始读第一章吧——读完你应该能自己回答它们。