4.3 向量化执行
4.3 向量化执行
本节摘要:逐行执行让 CPU 大部分时间花在"调度一行数据"而不是"计算一行数据"上;向量化把约两千个值打成一批,一次性过算子,解释开销被摊薄、缓存命中被拉满。本节用一次对照实验把收益拆开验证。
一次可以亲手做的对照实验
DuckDB 本身就是向量化引擎,做对照实验需要换个参照物——用同一份数据分别走逐行循环和 DuckDB 向量化路径,耗时差距能直观到令人发笑的程度:
-- 逐行思路的等价物:数据库里几乎没有"逐行函数调用",但可以用一个慢查询模拟重解释开销 -- 这里用 Python 侧对照更直观(见下方说明) SELECT sum(amount) FROM trades_clean;
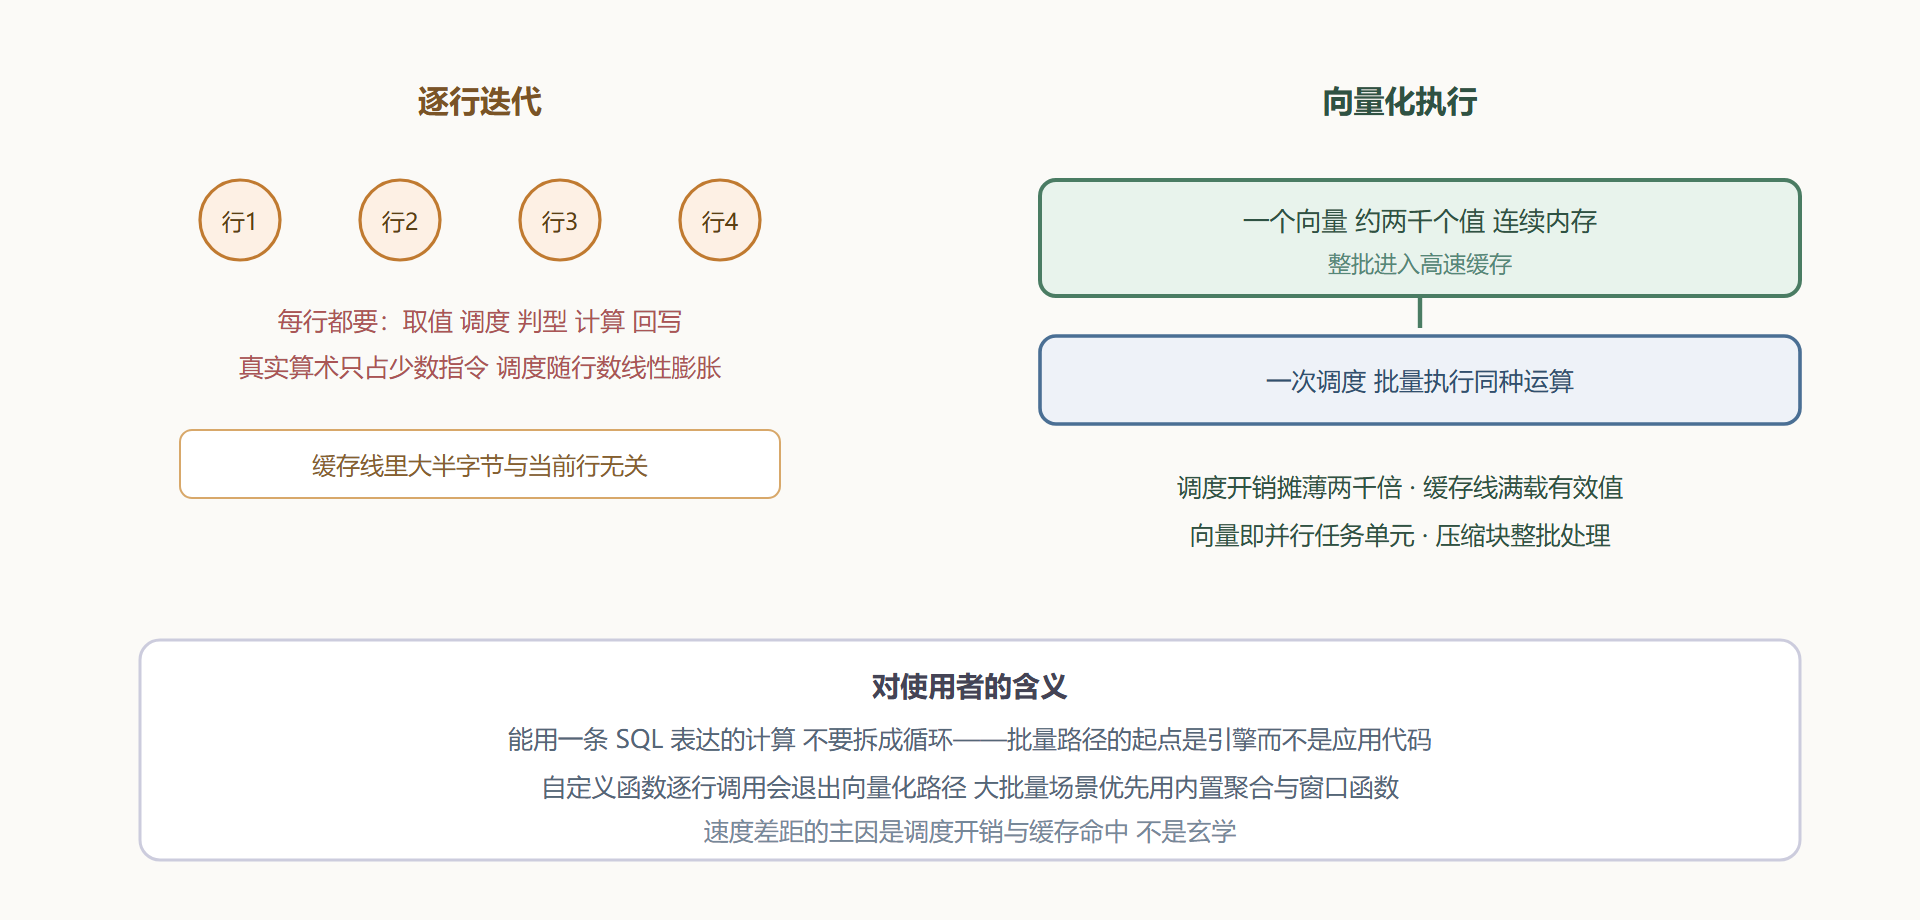
在 Python 里对照:对一千万行的金额列用普通循环逐个累加,再让 DuckDB 执行上面这条聚合——差距通常是两三个数量级。差距从哪来?逐行循环的每一步都要经过解释器调度:取值、判断类型、执行加法、存回,真正的算术只占少数指令。向量化把这四步的调度成本一次性付给两千个值——调度开销被摊薄两千倍,这就是量级差距的主因。
实验还能再往深走一步,把向量化与并行拆开各看各的贡献。同一台八核机器上测三组:单线程逐行循环(基线)、DuckDB 单线程聚合(隔离向量化收益)、DuckDB 八线程聚合(叠加并行收益)。典型结果里,第二组对第一组的差距来自本节的向量化,第三组对第二组的差距来自第2.1节的 morsel 并行——两段加速比大致相当,谁也不是配角。这个拆解实验的副产品是对"加速"一词的祛魅:你以后看到任何引擎的性能宣传,都会本能地问一句"这收益来自批次、并行还是布局"——三个来源在本章与前三章各有一节,你已经全部见过它们的脸。布局、批次、并行三环合起来才是速度的全貌,本节把"批次"这环讲透,另外两环分别是第3章与第2.1节的主场。
收益的三层来源
第一层:摊薄解释与调度开销。 算子对一批值执行同一种运算,取数、类型检查、分支判断这些固定动作只做一次。这一层收益对任何批量计算都成立,是最大的一块。它也是三条里唯一与你无关的一条——另外两层吃数据布局与硬件,这一层只要求"别把批量拆散":让过滤、聚合整列整列地过引擎,调度摊薄的红利就自动到账。
第二层:CPU 缓存吃满。 列式向量是连续内存,批量处理时数据整批驻留在高速缓存里,运算期间不再频繁访存。行式布局下相邻数据在内存里挨着,但一次只取一行,缓存线里大部分字节用不上;列式向量则把缓存线的每个字节都变成有效载荷。
第三层:为并行与压缩感知铺路。 向量是天然的任务单元——线程领一批向量独立处理,第2.1节的 morsel 并行正是以向量为基础单位;同时压缩数据可以整批解压或直接参与计算(第3.2节),压缩感知执行也以向量为批次。三层收益叠加,构成列式引擎速度优势的执行侧全貌。三层之间还有个先后依赖值得看清:没有列存就没有连续向量(第一层的前提),没有向量就没有高效并行(第三层的前提)——列存、向量化、并行三者是咬合的齿轮串,任何一环缺失,另外两环的收益都会塌方。这解释了为什么"给行式数据库加多线程"从来没有追上列式引擎:缺的不是线程,是让线程吃饱的那条批量流水线。
图4-3 逐行迭代与向量化对照
向量化的边界
两个诚实的提醒。其一,自定义函数是向量化路径的逃逸口:引擎内置的聚合、字符串、窗口函数都按批实现,而你用宿主语言写的自定义函数按行回调——一旦用上,批处理就退化成逐行调用。大批量场景里,优先想想"这个逻辑能不能用内置函数组合表达"。其二,向量化的收益集中在扫描、过滤、聚合这类规整运算;连接、排序的收益同样可观但机制不同(它们的核心在算法与内存布局),不必把所有提速都归功于向量化。还有第三条提醒藏在日常习惯里:把数据搬出引擎再逐行处理(读成列表循环算)等于主动放弃全部三层收益——所以"能用 SQL 表达就留在引擎里算"不只是风格偏好,而是有硬件账本支撑的工程纪律。三条提醒归成一句话:向量化是引擎送给"整批整批想问题"的人的礼物,拆散了领不到。
-- 好的形态:整列批量过滤与聚合,全程向量化路径 SELECT vip_level, avg(amount) FROM trades_clean JOIN users ON user_id = users.id WHERE status = 'refunded' GROUP BY vip_level; -- 需要逐行逻辑时,先想想能否用条件表达式内置化 SELECT sum(CASE WHEN amount > 1000 THEN 1 ELSE 0 END) AS 大额笔数 FROM trades_clean;
两条 SQL 的差别不在结果(完全等价),在执行路径:前者整列批量过引擎,后者条件被翻译进表达式后同样走批量——而把数据读进宿主语言再循环的第三种写法,就全盘放弃了批量路径。代码评审时用这个标尺看数据处理的写法,一眼就能分辨"引擎思维"与"脚本思维",而两者的性能差距,正是本节全部内容的价格标签。
主线案例在"按用户聚合"之外还要算"大额退款占比"这类条件统计——用条件聚合而非拆成两次查询,既少扫一遍表,也让每一步都留在批量路径上。执行引擎的知识到此齐备,下一节看数据布局层面的最后一项武器:索引。届时你会看到一个有趣的分工反转:行式数据库靠索引省扫描,列式引擎靠布局省扫描——索引在那里是主角,在这里是配角。
为什么是一批两千,而不是更多或更少
向量长度这个数字本身藏着工程权衡,值得点破。不能太小:批量是为了摊薄调度开销,一批八个值的摊薄没有意义,调度成本还是主角。不能太大:一个向量的中间结果也要整个驻留在缓存里,批太大就装不进高速缓存,第二层收益(缓存吃满)直接蒸发;此外批越大,带过滤条件时被跳过的计算浪费越多——过滤后存活率低的批次,大部分计算白做。两千上下恰好卡在"调度开销可以忽略"与"中间态留在缓存"的交点上。理解这个权衡还有一个实际好处:读性能文章时看到别人引擎的批大小不同(有的上千有的几千),你不会再当成玄学——那是各自的缓存策略与指令集算出来的平衡点,原理同源,数字因地制宜。
与第2章的合流:为什么并行和向量化是天生一对
本节反复提到向量是并行的任务单元,这里把两层机制对齐看一次。第2.1节的 morsel 是数据块级的分工单位——它把表切成线程可认领的任务;向量是批次级的处理单位——线程拿到一块之后,内部再按向量逐批过算子。两层互为表里:没有 morsel,向量化只是单线程内的加速;没有向量化,morsel 领到任务后仍是逐行慢跑。这也解释了一个此前的悬案:为什么并行度开满后扫描聚合能接近线性加速(第2.1节的实验)——因为每个线程内部的批量路径是满速的,线程之间又没有共享状态要争抢。两章知识在此合流,第4章剩下的两节(计划与索引)则负责决定"哪些数据根本不必进入这条流水线"。
本节要点回顾
- 摊薄调度是最大收益:一批约两千个值共享一次调度,解释开销线性变摊销。
- 缓存吃满是第二收益:连续向量让缓存线满载,访存效率倍增。
- 向量是并行与压缩的单位:morsel 并行与压缩感知执行都以向量为基础。
- 自定义函数是逃逸口:能内置就内置,逐行回调会让批量路径退化。