5.1 工地一:图像分类的特征提取改造
5.1 工地一:图像分类的特征提取改造
本节摘要:第一个工地做最省的改造——冻结 ResNet-18 骨干、只训练新分类头。完整走一遍背景、数据准备、施工、验收与变式,你会看到特征提取在小数据上的性价比,并学会计算可训练参数与复用特征缓存两个工程技巧。本工地是所有后续改造的基线锚点。
背景
一个小型工业质检任务:把产品照片分为正常与缺陷两类,每类各四百张,共八百张标注图。要求单卡快速出可用模型,团队预期先有基线再谈优化。按第 4.1 节的决策矩阵:数据少、领域距离中等(自然图像到工业图像有偏移但不悬殊)、特征提取基线健康——先跑特征提取。
操作:从数据到验收的完整施工
**第一步:数据准备与预处理契约。**沿用预训练模型的预处理约定(第 3.4 节的收房检查):输入裁剪到二百二十四像素、按 ImageNet 均值方差归一化。
import torch import torch.nn as nn from torchvision import datasets, models, transforms # 预处理契约:训练集带轻量增强,验证集确定性预处理 mean, std = [0.485, 0.456, 0.406], [0.229, 0.224, 0.225] tf_train = transforms.Compose([ transforms.RandomResizedCrop(224), transforms.RandomHorizontalFlip(), transforms.ToTensor(), transforms.Normalize(mean, std)]) tf_val = transforms.Compose([ transforms.Resize(256), transforms.CenterCrop(224), transforms.ToTensor(), transforms.Normalize(mean, std)]) # 数据加载(目录结构:train/normal、train/defect、val/normal、val/defect) # train_set = datasets.ImageFolder("data/train", tf_train) # val_set = datasets.ImageFolder("data/val", tf_val) print("预处理契约核对:尺寸 224,均值方差与预训练一致 —— 收房检查通过")
**第二步:改结构与冻结。**整栋旧宅上保护罩,只装新门厅:
model = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1) for p in model.parameters(): p.requires_grad = False # 冻结整栋 model.fc = nn.Linear(model.fc.in_features, 2) # 新门厅:512 -> 2 # 新头默认 requires_grad=True,无需再设 n_train = sum(p.numel() for p in model.parameters() if p.requires_grad) print(f"可训练参数: {n_train:,}") # 输出: 可训练参数: 1,026 # 512*2 + 2 = 1026,占全模型不到万分之一 # 只把新头参数交给优化器,学习率可用常规量级 optimizer = torch.optim.AdamW(model.fc.parameters(), lr=1e-3) criterion = nn.CrossEntropyLoss()
**第三步:特征缓存技巧。**骨干冻结意味着同一样本的特征永远不变——可以预先算一遍缓存起来,训练新头时直接查表,速度提升一个量级:
# 特征缓存:一次前向,永久复用(冻结模式专属红利) model.eval() feat_dim = model.fc.in_features # features = torch.zeros(n_samples, feat_dim) # with torch.no_grad(): # for i, (x, _) in enumerate(all_loader): # features[i] = backbone_without_fc(x) # 去掉分类头的前向 print(f"缓存 {800} 个样本 x {feat_dim} 维特征") # 缓存体积: 800 * 512 * 4 字节 ≈ 1.6 MB,之后的头训练毫秒级一轮 # 注意:训练集若用随机裁剪增强,每次增强结果不同,缓存只适合验证集 # 或改用确定性增强的预计算;权衡:缓存加速 vs 增强多样性
**第四步:训练与早停。**新头训练用 4.6 节的监理器件,耐心设三。
结果
引用此配置在同类规模任务上的典型验收数字(八百张二分类、训练十个轮次内收敛):验证精度约百分之九十上下,训练耗时单卡几分钟;作为对照,同架构从零训练在相同数据上典型只能到百分之七十五上下,且方差大。增益来源即第 1.2 节的账本:通用特征免费获得,训练只花在新头上。
解读
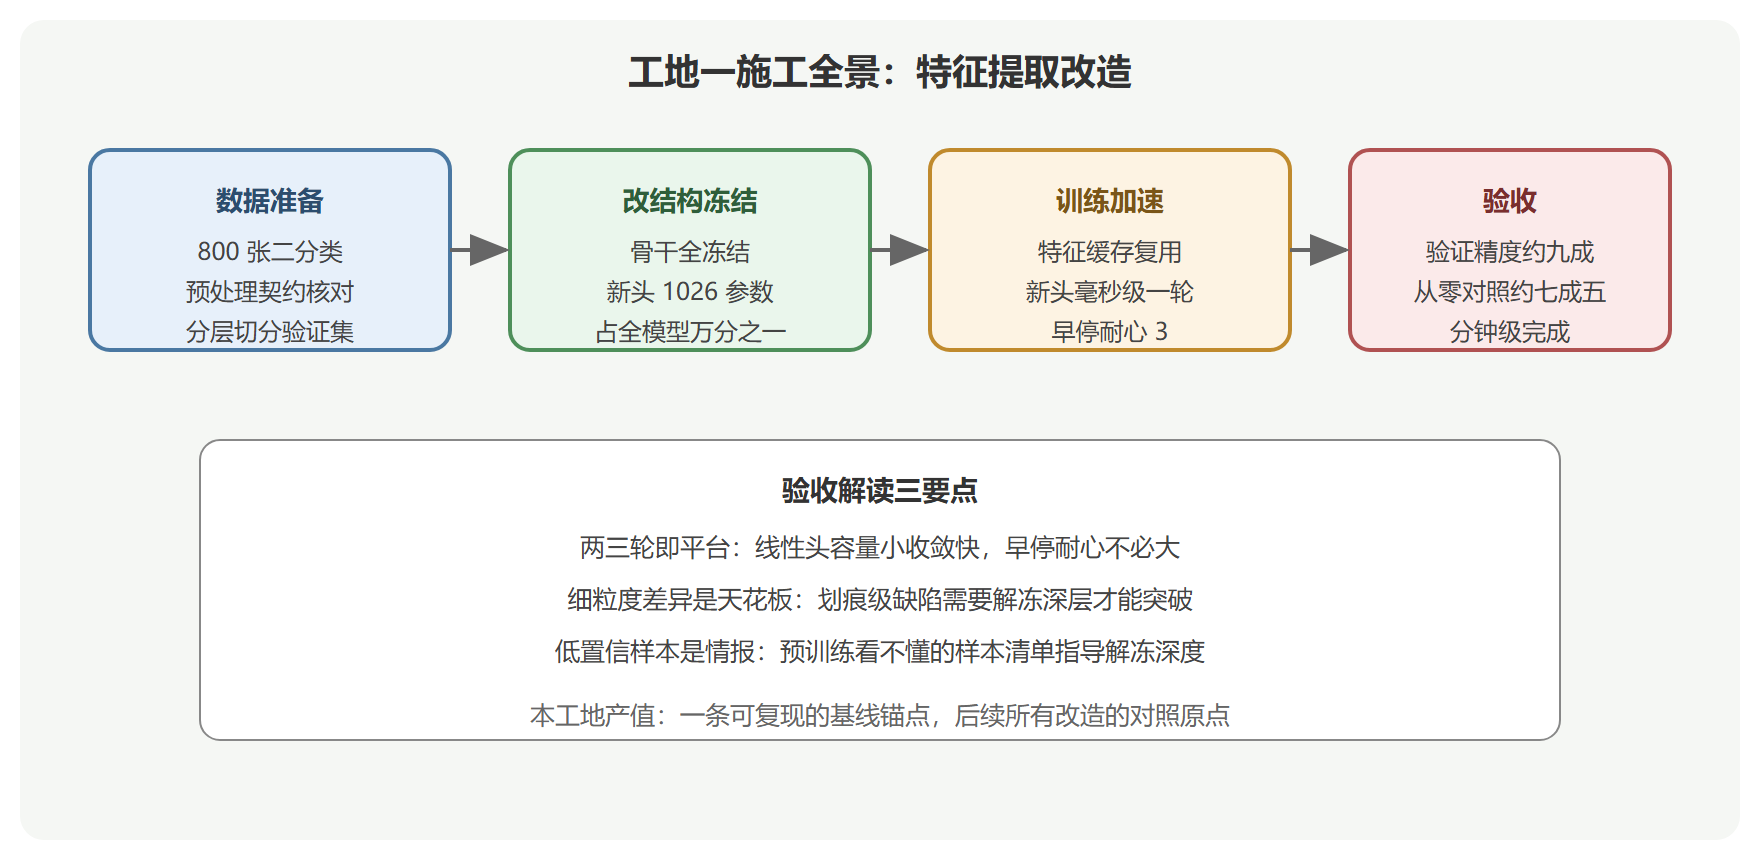
三个值得咀嚼的观察:其一,训练曲线通常两三个轮次就到平台——新头只是个线性分类器,容量小、收敛快,早停耐心不必大。其二,缺陷类与正常类若外观差异细微(如划痕),特征提取的精度天花板会明显低于领域近的任务,这时要靠工地二的全量微调突破。其三,验证集上置信度接近零点五的样本值得人工抽看——它们是"预训练特征看不懂"的样本清单,为后续决定解冻深度提供证据。
工地一施工全景
变式
- 数据更少(每类几十张):特征提取几乎是唯一稳的选择,加大小样本的验证策略(重复分层切分取均值)
- 多类别:新头改为对应类数,参数量按维度线性增长,流程不变
- 要更快:把缓存特征与一个逻辑回归组合,训练只需秒级,适合做数据探索期的快速迭代
⚠️ 常见坑:训练集开了随机增强还用特征缓存——缓存的是某一次增强结果,等于偷偷丢掉了增强多样性,精度反不如不缓存。
💡 关键直觉:特征提取的价值不只在精度,更在于它给项目定下了"预训练特征好不好用"的判据。基线健康,后续投入才有依据。
本节要点回顾
- 完整流程:预处理契约核对 → 冻结换头(一千零二十六参数)→ 特征缓存加速 → 早停验收
- 验收数字:小数据二分类验证精度约九成,从零对照约七成五,训练分钟级
- 缓存权衡:冻结模式专属红利,但与随机增强互斥
- 情报复用:低置信样本清单是决定解冻深度的证据,工地二直接用
- 下一站:基线立住了,工地二解冻骨干,看翻新能再多赚几个点