- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
Transformer 模型详解:NLP领域的革新者
导读:Transformer 是 2017 年由 Vaswani 等人在论文《Attention Is All You Need》中提出的序列建模架构,它彻底抛弃了循环与卷积结构,完全依赖注意力机制处理序列,解决了 RNN 与 LSTM 在并行计算与长距离依赖上的两大瓶颈,并成为 BERT、GPT 等大规模预训练语言模型的基石。本教程采用"概念筑基"的路线:先把自注意力、多头、位置编码这些抽象模型讲透,再看它们如何组装成编码器与解码器,最后落到训练与工程实践。
这本教程解决什么问题
如果你曾经翻开 Transformer 的原始论文,多半会被那张布满模块的架构图劝退过。网上多数资料也遵循同样的顺序:先甩出整体架构,再逐个拆零件。结果读者往往记住了"编码器、解码器、多头注意力"这些名词,却说不出一个词的向量在一层里究竟经历了什么。
我们换一条路。这套教程的信念是:Transformer 里真正新的东西只有一个——注意力机制,其余部件(残差、归一化、前馈网络)都是深度学习的既有积累。所以先把注意力这个抽象模型彻底讲明白,整体架构就只剩"搭积木"的问题。这也是我们把"注意力机制总览"放进第 1 章、而把整体架构放到第 3 章的原因。
读完这套教程,你应当能够:
- 说清楚 Query、Key、Value 三者的检索式语义,以及缩放点积注意力每一步在做什么;
- 解释多头注意力为什么比单头表达能力更强,位置编码为什么必须存在;
- 画出编码器层与解码器层的结构,指出二者在子层配置上的差异;
- 描述训练流程中的损失函数、优化器、warmup 学习率调度与正则化手段;
- 对比贪婪搜索、束搜索、温度采样、Top-k 与核采样等解码策略的适用场景。
内容结构与阅读路线
全书共四章,脉络是"困境—概念—组装—落地":
- 第 1 章 从序列困境到注意力思想。回顾 NLP 从规则、统计到深度学习的演进,剖析 RNN 与 LSTM 在顺序计算和长距离依赖上的固有局限,然后直接引入 Query、Key、Value 的检索式注意力模型——这是全书的概念地基。
- 第 2 章 核心组件:把抽象机制讲透。逐一深挖自注意力、多头注意力、位置编码、前馈网络、残差连接与层归一化。这一章不谈整体架构,只回答"每个零件单独看是什么"。
- 第 3 章 整体架构:编码器与解码器。把第 2 章的零件组装起来:Encoder-Decoder 的分工、编码器层的双子层结构、解码器层的掩码自注意力与交叉注意力。
- 第 4 章 训练与工程落地。分词与嵌入、交叉熵损失与 Adam 优化器、warmup 调度、推理阶段的解码策略,以及以 Hugging Face Transformers 为代表的开源生态实践。
Transformer 在 NLP 演进中的位置
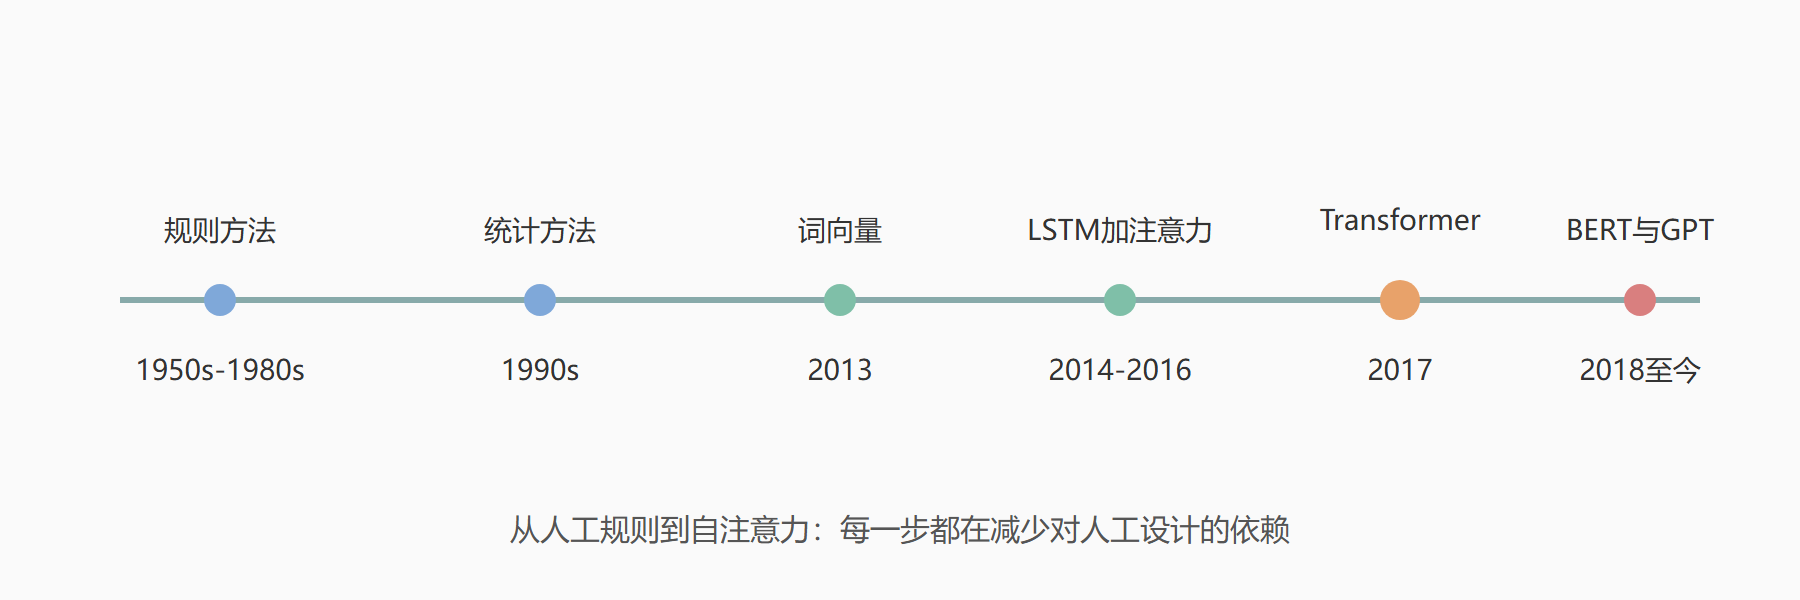
在 Transformer 之前,处理文本的主流是 RNN 及其变体 LSTM、GRU。它们按时间步顺序处理序列,隐藏状态像接力棒一样逐词传递。这套范式在神经机器翻译上取得过巨大成功,但顺序依赖使模型难以充分利用 GPU 的并行算力,信息在长序列传递中也会逐渐稀释。2017 年 Transformer 用自注意力取而代之:序列中任意两个位置的关联一步直达,全部计算可并行展开。这不仅是效率提升,更让"在海量文本上训练超大模型"第一次在工程上变得可行——BERT、GPT、T5 皆由此而来。
下面的时间线给出了这段演进的关键节点。
NLP 关键技术演进时间线
各章角色一览
| 章节 | 角色 | 核心问题 |
|---|---|---|
| 第1章 | 坐标系与概念地基 | 注意力是什么,旧范式欠了什么账 |
| 第2章 | 零件手册 | 每个组件单独看如何运转 |
| 第3章 | 装配图纸 | 零件如何组成两座塔并协作 |
| 第4章 | 运维手册 | 怎么训练、怎么生成、怎么落地 |
怎么读效率最高
我的建议是按章顺序读,尤其是第 2 章不要跳。第 2 章五节分别对应五个组件,它们在后续所有内容里反复出现。如果时间有限,优先读 1.3 节(注意力的检索模型)、2.1 节(自注意力的完整计算流程)和 3.3 节(解码器与掩码),这三处是理解门槛最高、也最容易含糊过去的地方。
每节末尾都有"要点回顾",可以作为自测清单:如果合上书能复述出每条要点的因果链,这一节就算过关了。书中图表较多,架构分层透视、注意力矩阵示意、位置编码热力这类图,建议对照文字多看两遍——Transformer 的很多设计,用语言描述绕,看图则一目了然。
几个贯穿全书的数字先立在这里,读到相关章节可以随时回来核对:原论文的编码器与解码器各堆叠六层;模型维度五百一十二,八个注意力头,每头六十四维;前馈网络中间维度两千零四十八,即四倍模型维度;warmup 步数四千。这组"基础版配置"是后续一切变体的参照原点,记住它们,读到 BERT、GPT 的配置时就能立刻看出改了哪里、放大了什么。
还有一层读者画像说明。这套教程假设你写过一些 Python、懂一点线性代数,但不要求读过机器学习课程——需要的概念(梯度、softmax、损失函数)都会在使用前就地补课。如果你已是资深从业者,第 2 章的五个组件拆解与第 4 章的解码策略对比仍值得快读一遍,那里集中了我们压箱底的实践判断;如果你是第一次接触深度学习,慢一点完全没问题,第 1 章的历史脉络就是为降低门槛准备的。
一句话总结这本教程的主张:理解 Transformer,不在于背下架构图,而在于把"注意力是一种可微分的检索"这个模型想透。
常见疑问
问:直接学 Transformer,跳过 RNN 和 CNN 时代,行不行?
答:能用,但容易知其然不知其所以然。原论文里「Attention Is All You Need」这个标题本身就是对 RNN 时代的宣战书——不懂被宣战的一方,就看不懂宣言的分量。第 1 章用两节的篇幅讲序列困境,正是为了让「为什么偏偏是注意力」这个问题有落点。赶时间的读者至少精读 1.2 一节再往后走。
问:学 Transformer 需要多深的数学?
答:矩阵乘法、向量点积、 softmax 归一化,加上一点概率基础就够了。论文里的公式看着吓人,拆开全是这几样。真正难的不是数学,是把 QKV、多头、位置编码这些抽象概念在脑子里搭成可运转的机器——所以本教程配了大量图示与类比,概念通了公式自然通。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...