- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
化学信息学(Chemoinformatics)教程导读
本册定位:化学信息学是把化学结构变成计算机可读、可算、可检索的数据,再从数据出发设计新分子的一门工程学科。本册按"图书馆"的主线组织十章内容——从结构表示、数据治理、描述符与指纹,到相似性检索、QSAR 建模、虚拟筛选、分子生成与反应规划——面向药物发现、材料设计与化学品数据管理的从业者与学习者。
「SMILES」——在这册书里,它是索书号,是馆藏条码,也是任何计算机都能翻阅的通用目录。你随手写下的这串字符,可能对应一粒阿司匹林,可能是一段候选药物的骨架,也可能是一种还没被合成出来的新材料。把化学结构翻译成计算机能读、能算、能检索的数据,再从数据出发反推值得做实验的分子——这门手艺,就是化学信息学(Chemoinformatics)。
我们更愿意把它叫作"分子图书馆的编目手艺"。一座好的图书馆,不在于藏书多,而在于你能否在几分钟内找到想要的那本,能否判断两本书讲的是不是同一件事,能否根据你的口味荐出你从没听说过但正合需要的新书。化合物宇宙的规模远超任何一座实体图书馆:理论可合成的药物样小分子估计在 10 的 23 次方到 60 次方量级,而已被合成、登记在册的不过两三亿。没有编目、没有索引、没有检索策略,这座馆藏对任何研究者都是黑暗的仓库;有了这套手艺,它才成为可以导航的知识空间。
为什么这门手艺值得花时间
药物研发的一条公认经验法则是"Eroom 定律"——投入翻倍,单位产出的新药反而在缓慢下滑,研发成本每九年翻一番。业内归因时总绕不开两条:实验试错太贵,数据没有用好。化学信息学恰好插在这两处:它让"先算后做"成为可能——用相似性检索圈定候选,用 QSAR 模型预判活性,用虚拟筛选把十万次实验压缩成一百次值得做的实验;它也让历史数据变成资产——ChEMBL 里几十年积累的活性记录,清洗之后就是训练模型的养料。
不只制药。锂电池电解质配方、有机发光材料的分子筛选、催化剂配体的优选、香精与农药分子的设计,底层用的都是同一套技能:结构表示、描述符计算、指纹检索、性质建模。学会这套手艺,你拿到的是一把在多个行业通用的钥匙。
全书主线:一座分子图书馆的日常运营
本册十章,按图书馆的运营逻辑分成四层,层与层之间是严格的依赖关系——不理解表示(第2章),就谈不上数据治理(第3章);没有描述符与指纹(第4章),相似性与聚类(第5章)就无从算起;没有前五章的底子,QSAR(第6章)和虚拟筛选(第7章)只能照抄教程参数,出了问题无从排查。第8章的现代生成模型、第9章的反应信息学是进阶能力,第10章收拢工具生态与前沿方向。
图 0-1:全册知识地图——四层十章的学习路线
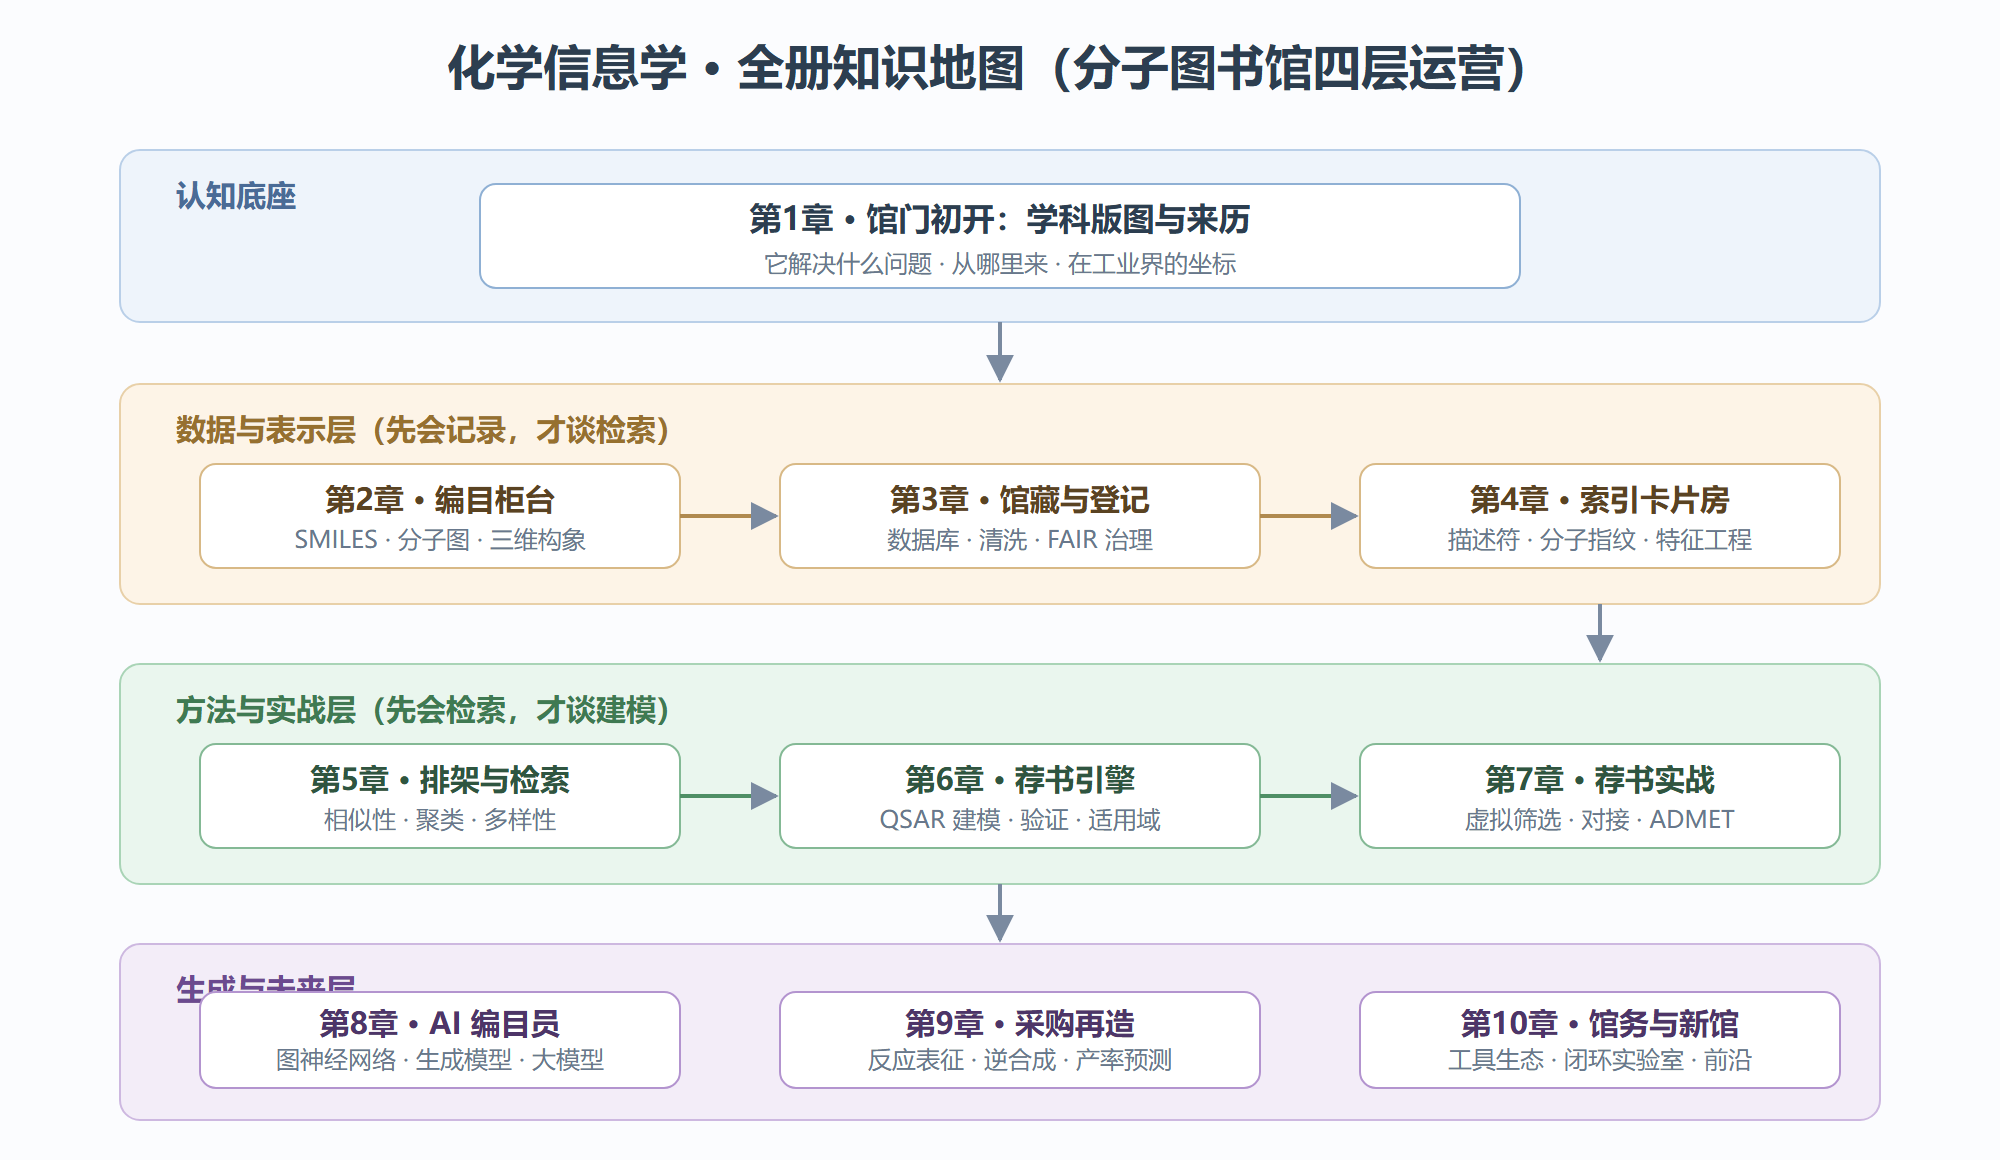
跟着这张图读:横向是同一层内的顺序依赖,纵向箭头是跨层的前置关系。如果你只记得一件事,请记住——表示是根,检索是干,建模和生成是花果;跳过根去追花果,是这门学科最常见的学法错误。
三种读者,三条路线
做数据分析出身、想进药企或 CRO 的读者:从第2章补结构表示起步,认真做完第4章指纹和第5章相似性的全部计算练习,再看第6章建模——你的统计功底是优势,缺的只是把分子变成特征的那段桥梁。第7章虚拟筛选是面试和入职后最常用的场景,值得精读。
化学、药学出身、想补计算能力的读者:第1、2章对你几乎是无痛复习,重点在第3章数据治理和第6章建模工作流——化学家的直觉能帮你判断"哪些描述符在该靶点上讲得通",这是纯计算机背景的人最缺的护城河。第9章反应信息学建议整章精读。
只想建立全局认知的管理者与产品经理:读每章支柱页与 1.1、3.1、7.1、10.2,即可拼出全行业的成本结构与工具版图;判断一个 AI 制药团队是否靠谱,看他们怎么处理第3章的数据清洗和第6章的模型验证,比听概念演讲有用得多。
动手环境与学习方法
本册的代码练习以 Python 与 RDKit 开源工具包为主(第10.1节有完整选型讲解),多数示例只需要几行代码就能跑通。我们建议的学习循环是:读一节 → 把示例数字亲手算一遍 → 换一个自己的分子重跑 → 猜结果再验证。比如学 Tanimoto 系数时,先手算两个小分子的指纹重叠,再与 RDKit 输出对答案;算错不可怕,算错后找到错在哪一位比特,理解才真正发生。
化学信息学是少数"历史数据即教材"的学科:公共数据库里躺着几十年、数百万条的实验记录,本册大量案例直接取材于此。学完第7章后,不妨给自己出一道综合题——从 ChEMBL 选一个靶点,独立跑通"取数据、清洗、建库、相似性筛选、QSAR 精排"的完整链条。能独立跑通这条链,这门手艺就算真正上手了;再往后,第8、9章的现代生成与反应模型,不过是给这条链换上更强的引擎。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...